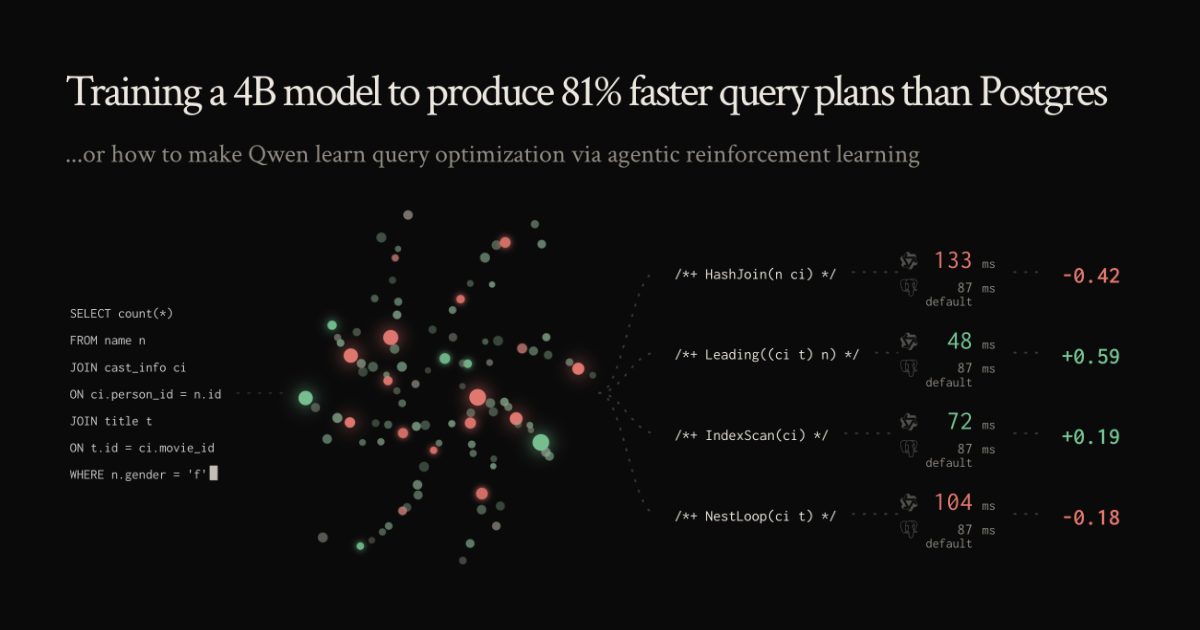
RL-ով մարզված 4B մոդելը Postgres-ից 81%-ով ավելի արագ հարցումների պլաններ է կառուցում
Ռոհան Բանսալը մարզել է 4 միլիարդ պարամետրով բաց մոդել, որը pg_hint_plan ակնարկներով կառավարում է PostgreSQL-ի պլանավորիչը։ 113 միացումներով հարցումներում ընդհանուր ուշացումը նվազել է 44,7%-ով։
Փոքր մոդելը Postgres-ի պլանավորիչի դեմ
Ռոհան Բանսալը հրապարակել է փորձ, որը ցույց է տալիս, որ փոքր, բաց կշիռներով լեզվական մոդելը կարելի է վերապատրաստել այնպես, որ PostgreSQL-ի համար ավելի լավ հարցումների պլաններ ստեղծի, քան ինքը՝ տվյալների բազան։ IMDb տվյալների հավաքածուի վրա միացումներով ծանրաբեռնված 113 SQL հարցումներից բաղկացած Join Order Benchmark-ում (JOB) մարզված 4B մոդելը լավագույն թեկնածուի ընտրությամբ հասել է 1,81x երկրաչափական միջին արագացման, իսկ ամբողջ ծանրաբեռնվածության ընդհանուր ուշացումը նվազել է 44,7%-ով։ Նույն ստուգիչ կետը գրանցել է 68 հաղթանակ և զրո ռեգրեսիա։
Մեկնարկային վիճակը մխիթարական չէր. չմարզված մոդելը 113 հարցումից 99-ի համար օգտագործելի պլան չի կարողացել կառուցել, և միայն 14 փորձ է տվել վավեր թեկնածու։ Հեղինակի մեկնաբանմամբ՝ հարցումների օպտիմիզատորները բարդ են. միացումների հերթականության խնդիրը NP-բարդ է, իսկ պլանավորիչը կարդինալությունը գնահատում է վիճակագրությամբ, ոչ թե տողերի հաշվարկով։ Սակայն պլանը ստուգելը հեշտ է, քանի որ միակ չափանիշը կատարման ժամանակն է։ Հենց այդ ասիմետրիան է խնդիրը հարմար դարձնում ամրապնդող ուսուցման համար։
Ակնարկներ, գործակալային միջավայր և դիստիլացիա
Մոդելը պլանավորիչին չի փոխարինում, այլ կառավարում է այն։ Բանսալը օգտագործել է pg_hint_plan՝ երրորդ կողմի ընդլայնում, որը SQL մեկնաբանություններում կառուցվածքային ակնարկներ է ընդունում, և կառուցել է qo-agent անունով վեց գործիքանոց գործակալային միջավայր։ Գործակալը զննում է աղյուսակներն ու սյունակների վիճակագրությունը, կարդում է լռելյայն պլանը և ուղարկում թեկնածու պլանի գործողություններ; յուրաքանչյուր թեկնածու կատարվում է և ժամանակով համեմատվում լռելյայն պլանի հետ։
Մարզումը ընթացել է երկու փուլով։ Սկզբում՝ վերահսկվող նուրբ կարգավորում off-policy դիստիլացիայով՝ 500 GPT-6 Astra գործակալային հետագծերից, որտեղ թարմացվում էր միայն 42,5 ՄԲ LoRA ադապտերը՝ 21,2 միլիոն մարզվող պարամետրով, 4,66 միլիարդ պարամետրանոց Qwen-ի ածանցյալի վրա։ Երկու էպոխան բարելավել է արդյունքը, երրորդը՝ վատացրել, թեև վալիդացիայի կորուստն այլևս չէր փոխվում։
Պարգևներ աղմկոտ միջավայրում
Երկրորդ փուլը գործակալային ամրապնդող ուսուցումն էր GRPO-ի հարմարեցված տարբերակով։ Արագացման գործակիցը հաշվարկվում էր որպես լռելյայն պլանի երեք չափումների մեդիանայի հարաբերություն թեկնածուի երեք չափումների մեդիանային, և չափիչ կանգառը պետք է հատկապես ուշադիր կառուցվեր. մեկ մեքենայի վրա աշխատող չորս PostgreSQL կոնտեյներեր ստեղծում են Linux-ի էջային քեշի մրցակցություն, որը աղավաղում է չափումները։ Մարզումը բաժանվել է երկու վայրի՝ vLLM-ը և trainer-ը վարձակալված 2x H100 հանգույցում, իսկ տվյալների բազայի կոնտեյներները՝ հեղինակի սեղանին։ Պարգևի սկզբնական բանաձևը մոդելին մղում էր անընդհատ վերադարձնել լռելյայն պլանը. լուծումը rollout-ների իրար հետ համեմատումն էր։
Ինչ սովորեց մոդելը
1200 թարմացումից հետո վերջնական ստուգիչ կետի վերլուծությունը ցույց է տալիս, որ որոնումների մեծ մասը նախ զննել է աղյուսակը, սյունակի վիճակագրությունը կամ լռելյայն պլանը։ Նախագիծը արժեցել է մոտ 1200 դոլար՝ Lambda-ում 2x H100 հանգույցի շուրջ 95 ժամ և 400 դոլար OpenAI-ի API-ի վճար՝ ցուցադրական հետագծերի համար։ Բանսալի եզրակացությունն այն չէ, որ մեծ մոդելները հնացել են. ընդհակառակը, Astra-ից արված դիստիլացիան է պատճառը, որ փոքր մոդելն ընդհանրապես աշխատում է։ Եզրակացությունն այն է, որ փոքր մոդելները լուրջ ուշադրության են արժանի նեղ և հեշտ ստուգվող խնդիրներում։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։