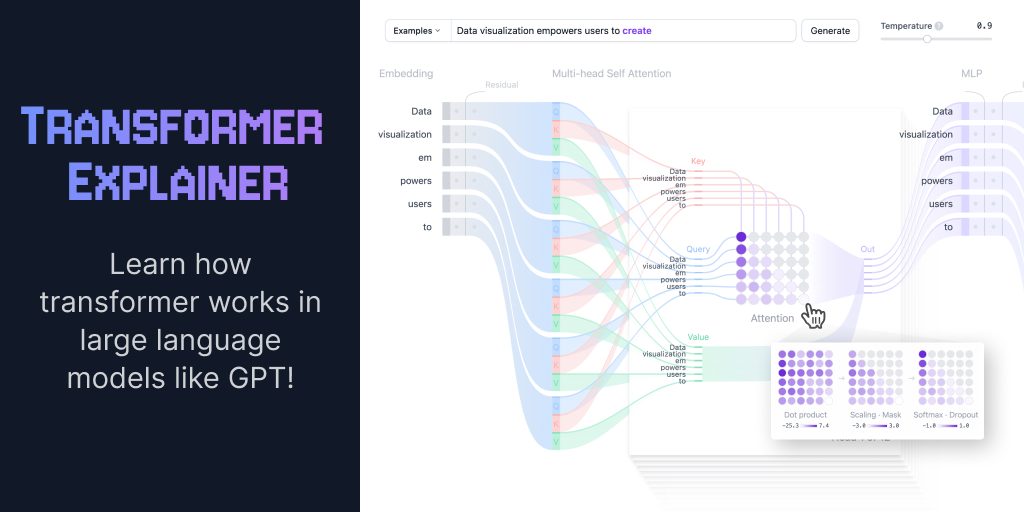
Transformer Explainer. GPT-2 լեզվական մոդելի աշխատանքը՝ տեսողական դիտարկիչում
Ջորջիայի տեխնոլոգիական ինստիտուտի հետազոտողների գործիքը GPT-2-ը գործարկում է հենց դիտարկիչում և քայլ առ քայլ ցույց տալիս, թե ինչպես են թոքենները, ուշադրությունը և ընտրությունը ձևավորում հաջորդ բառը։
Transformer Explainer-ը ինտերակտիվ կայք է, որը ցույց է տալիս, թե ինչպես է տրանսֆորմեր լեզվական մոդելը հուշումը վերածում հաջորդ բառի։ Դիտարկիչում ուղիղ գործարկվում է 124 միլիոն պարամետրով GPT-2 (small) մոդելը, այդ պատճառով էջի բոլոր գծապատկերներն արձագանքում են մուտքագրված տեքստին։ Նախագիծը ստեղծել է Ջորջիայի տեխնոլոգիական ինստիտուտի ութ հոգանոց թիմը, որի կազմում են Aeree Cho-ն, Grace C. Kim-ը և Polo Chau-ն. այն ուղեկցվում է ACM Digital Library-ի հոդվածով։
Թոքեններից մինչև հավանականություններ
Մուտքային տեքստը բաժանվում է թոքենների՝ բառերի կամ բառի մասերի, և յուրաքանչյուր թոքեն դառնում է 768 չափանի վեկտոր։ GPT-2-ի բառարանը պարունակում է 50 257 թոքեն, ուստի միայն էմբեդինգի մատրիցը կրում է մոտավորապես 39 միլիոն պարամետր։ Դիրքային տեղեկատվությունը ավելացվում է առանձին, քանի որ ճարտարապետությունը բառերի կարգի ներկառուցված զգացողություն չունի։
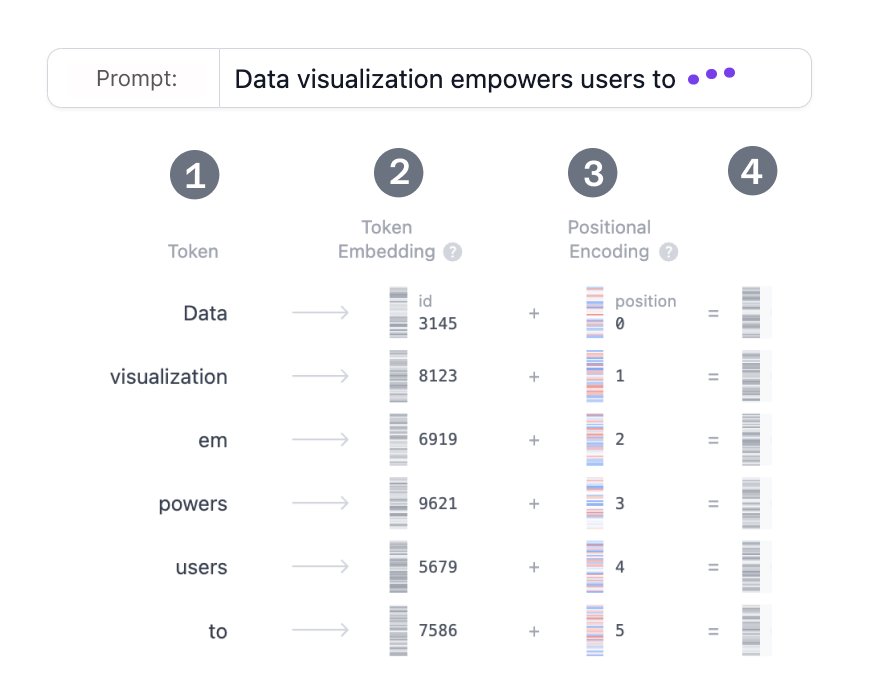
Այնուհետև վեկտորներն անցնում են 12 նույնական տրանսֆորմեր բլոկներով։ Յուրաքանչյուր բլոկ միավորում է բազմագլուխ self-attention-ը, որը թոքեններին թույլ է տալիս փոխանակել տեղեկատվություն, և բազմաշերտ պերցեպտրոնը, որը յուրաքանչյուր թոքեն մշակում է առանձին։ Ուշադրության գնահատականները դիմակավորված են. դիրքը տեսնում է միայն ձախ կողմի թոքենները,
Ուշադրության և MLP-ի ներսում
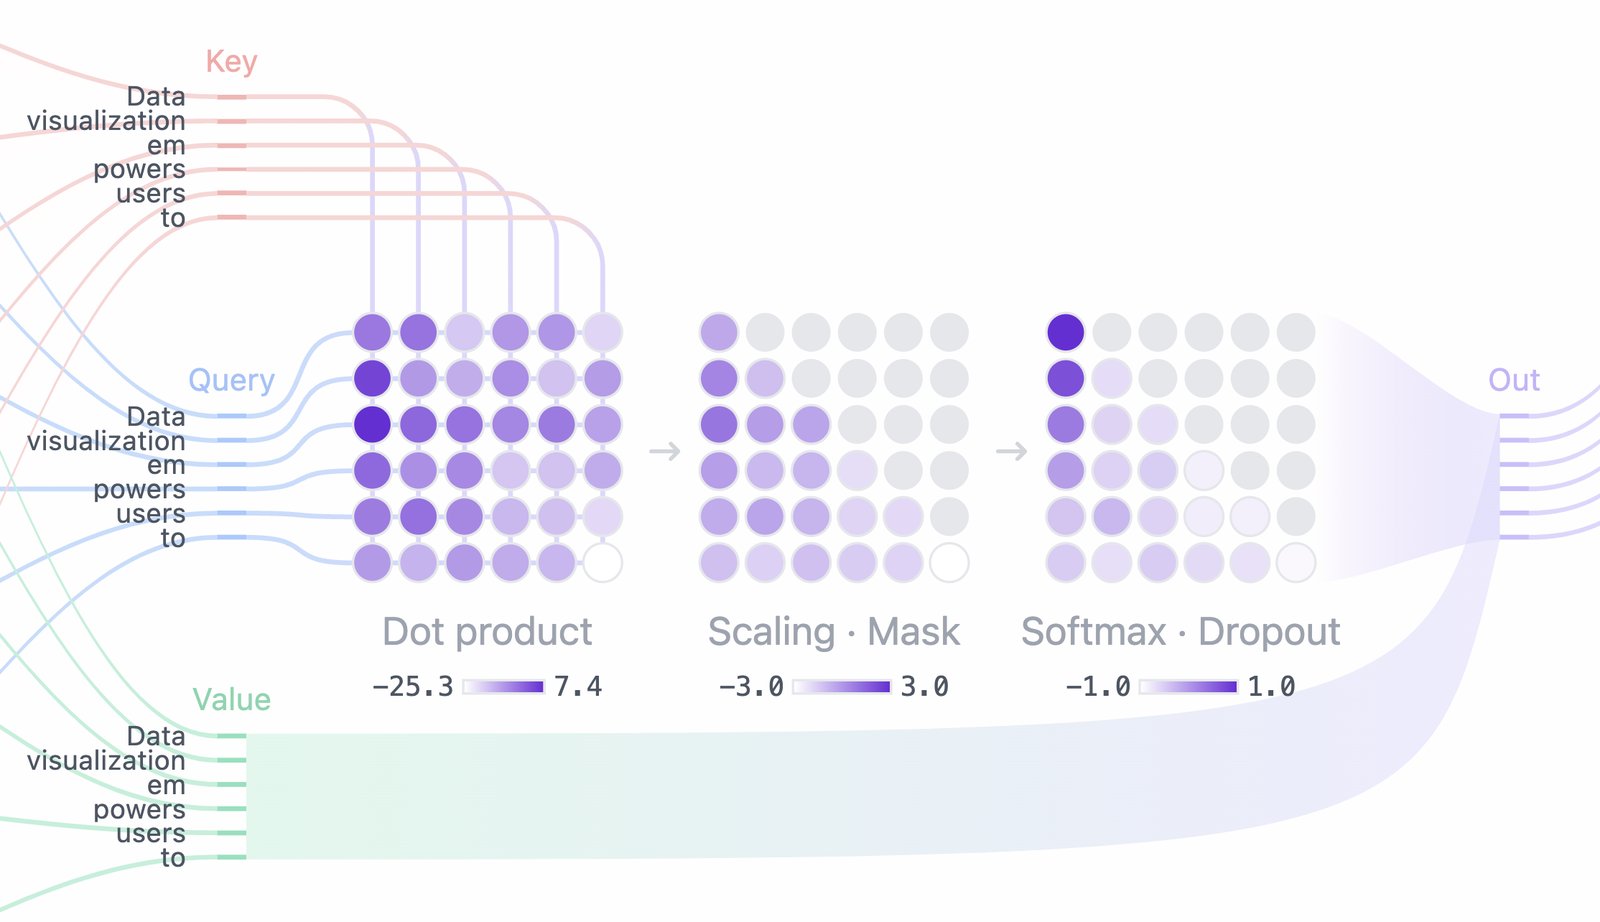
Query, Key և Value վեկտորները ստացվում են էմբեդինգներից։ Կայքը դրանք նմանեցնում է վեբ որոնման. հարցումը այն է, ինչ մուտքագրում եք, բանալիները՝ արդյունքների վերնագրերը, արժեքները՝ էջերի բովանդակությունը։ GPT-2 (small)-ը դրանք բաժանում է 12 գլխի. մեկը կարող է հետևել շարահյուսությանը, մյուսը՝ ավելի լայն իմաստին։ Սկալյար արտադրյալները սկալավորվում և դիմակավորվում են, ապա բազմապատկվում արժեքների մատրիցով։
MLP-ն յուրաքանչյուր թոքենի ներկայացումը 768-ից ընդարձակում է մինչև 3 072 չափի՝ գծային շերտով և GELU ակտիվացիայով, ապա կրկին սեղմում 768-ի։ Վերջին գծային շերտը արդյունքը նախագծում է 50 257 թոքենանոց բառարանի վրա որպես լոգիտներ, իսկ softmax-ը դրանք վերածում է հավանականությունների բաշխման, որից ընտրվում է հաջորդ թոքենը։
Սահիկներ, ընտրություն և իրականացում
Այցելուները կարող են տեղափոխել temperature-ի սահիկը. 1-ից փոքր արժեքները սրում են բաշխումը և արդյունքը դարձնում ավելի կանխատեսելի, 1-ից մեծերը՝ հարթեցնում և ավելացնում բազմազանություն։ top-k և top-p կարգավորումները ընտրությունը սահմանափակում են ամենահավանական թեկնածուներով։
Դեմոն ամբողջությամբ աշխատում է դիտարկիչում. nanoGPT նախագծի PyTorch-ային GPT իրականացումը փոխարկվել է ONNX Runtime-ի, իսկ ինտերֆեյսը կառուցվել է Svelte-ով և D3.js-ով։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։