«Ձեր լոկալ LLM-ը ավելի խելացի է, քան թվում է». որտեղ է ինֆերենսի կույտը կորցնում որակը
Level1Techs ֆորումում հրապարակված փորձերի շարքը ցույց է տալիս, որ լոկալ մոդելի «հիմարությունը» հաճախ պայմանավորված է attention-ի backend-երով, KV cache-ի քվանտացմամբ և տենզորային զուգահեռականությամբ, այլ ոչ թե մոդելով։
Level1Techs ֆորումում հրապարակված փորձերի շարքը ցույց է տալիս, որ լոկալ գործարկված մոդելը հաճախ ավելի թույլ է թվում, քան իրականում է, և պատճառը հաճախ ինֆերենսի կույտն է, ոչ թե մոդելը։ Թեմայի հեղինակը՝ thr3e մականունով օգտատերը, միևնույն կշիռները գործարկում է տարբեր runtime-ային կարգավորումներով և չափում, թե որտեղ են արդյունքները սկսում տարբերվել։
Երկու իրականացում նույնը չեն
Հեղինակը «հղումային իրականացում» է անվանում այն լաբորատորիան, որը հրապարակում է մոդելը, առաջինը հոսթինգ է անում և ներկայացնում բնօրինակ բենչմարկները․ նրանց սարքավորումն ու ծրագրային ապահովումը տարբերվում են ձերից։ Տնային կոնֆիգուրացիաները հաճախ խառնում են GPU-ների տարբեր սերունդներ, և հրահանգների տարբեր հավաքածուներ նույն կշիռների դեպքում էլ հաջորդ token-ի մաթեմատիկան այլ կերպ են հաշվում։ Թեստերում օգտագործված vLLM-ի nightly կոնտեյները պարունակում էր 734 փաթեթ, որոնցից 252-ը՝ Python․ այսինքն 734 կոդային բազա՝ յուրաքանչյուրը սեփական սխալներով։
Երեք թեստ՝ backend-եր, KV cache, քվանտացում
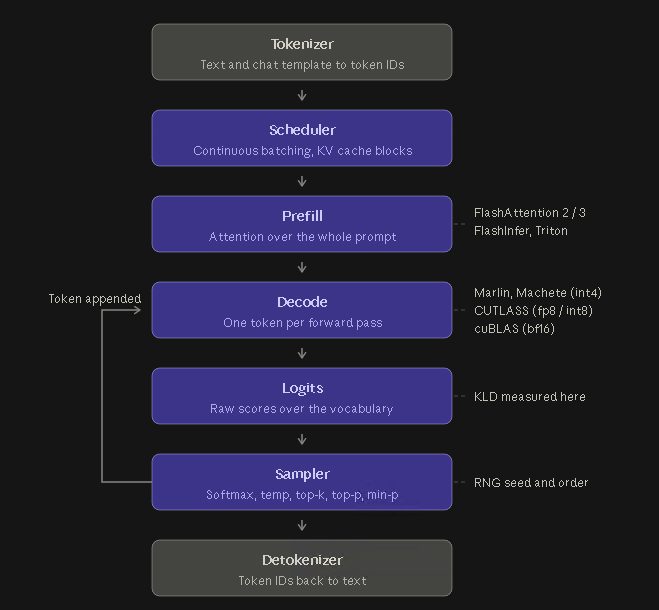
Առաջին թեստում համեմատվել են attention-ի երեք backend-եր՝ FlashAttention 2, Flash Inference և Triton Attention, Qwen3.6-27B-ի BF16 տարբերակի վրա RTX PRO 6000 Blackwell քարտի վրա, մնացած ամեն ինչ անփոփոխ։ Աշխատանքային բեռը իրական աշխատահոսքից վերցված մոտ 100 հազար token-ի կոնտեքստ էր՝ գործիքների կանչերով։ Առաջին մի քանի հազար token-ի ընթացքում բոլոր backend-երը համաձայն էին, ապա սկսեցին տարբերվել։ Նույն backend-ի կրկնությունը տվեց բիթ առ բիթ նույնական logits․ ուրեմն տարբերությունը գալիս է prefill-ի մաթեմատիկայից, ոչ թե պատահականությունից։
Երկրորդ թեստում քվանտացվեց միայն KV cache-ը․ int8 տարբերակը ի վերջո վերականգնվեց գործիքի կանչի սխալից, int4-ը՝ ոչ։ Երրորդում համեմատվեցին կշիռների հինգ ձևաչափեր․ լավագույնը INT8 W8A16-ն էր, իսկ Nvidia-ի NVFP4-ը՝ վերջինը՝ 88 հազար token-ի կոնտեքստում token-ների մոտ 50%-ը «շրջվեց»։ NVFP4-ը և AWQ W4A16-ը Cisco-ի սարքի վրա սխալ հրահանգ կատարեցին՝ 'show run' այնտեղ, որտեղ պետք էր 'show arp'։
Մեկ շրջված token, մեկ ձախողված առաջադրանք
Երկրորդ մասում հեղինակը գործիքների կանչերի ընթացքում գրանցեց logits-ների 100%-ը և ճյուղավորեց գեներացիաները՝ տեսնելու, թե ուր գնաց յուրաքանչյուր տարբերակ։ Մի դեպքում FlashAttention 2-ով գործարկումը թիրախավորեց GigabitEthernet0/1/4՝ GigabitEthernet0/0/1.201-ի փոխարեն, ապա 'show mac address table'-ի փոխարեն կատարեց 'show run'; մեկ այլ դեպքում չկարողացավ սահմանել ինտերֆեյսի նկարագրությունը։ Տենզորային զուգահեռականությամբ նույն առաջադրանքը անցավ TP1-ում, ձախողվեց TP2-ում և կրկին անցավ TP4-ում, ինչը խորը վերլուծության դեպքում սովորաբար վկայում է NCCL-ի մասին։
Ինչպես ճիշտ չափել
Ֆորումի խորհուրդը ձեր իրական ծանրաբեռնվածությունը ներկայացնող ստանդարտ բենչմարկներ գործարկելն է․ temperature-ը զրոյի իջեցնելը և երեք թեստային prompt տեղադրելը ագենտային աշխատանքի լավ համարժեք չէ, որին պետք են երկար կոնտեքստով գործիքների կանչեր և ոլորտային գիտելիքի ստուգումներ։ Պետք է օգտագործել մոդելի քարտում նշված sampler-ի կարգավորումներն ու chat template-ը․ չափից ցածր temperature-ը հենց այն պատճառն է, որ որոշ մոդելներ «խրվում են» THINK արտադրանքի մեջ։ Մեկնաբանները նաև ընդգծեցին, որ KL-դիվերգենցիան չափում է բաշխման շեղումը հղումից և ոչ ճշգրտությունը, և ուղղորդված է․ top-1-ի անհամաձայնությունը առանձին, ավելի խիստ չափիչ է։ BF16-ը թվային հավատարմության հղում է, ոչ թե «գուշակող»․ քվանտացված մոդելը կարող է շեղվել նրանից և միևնույն ժամանակ ավելի լավ պատասխան տալ։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։