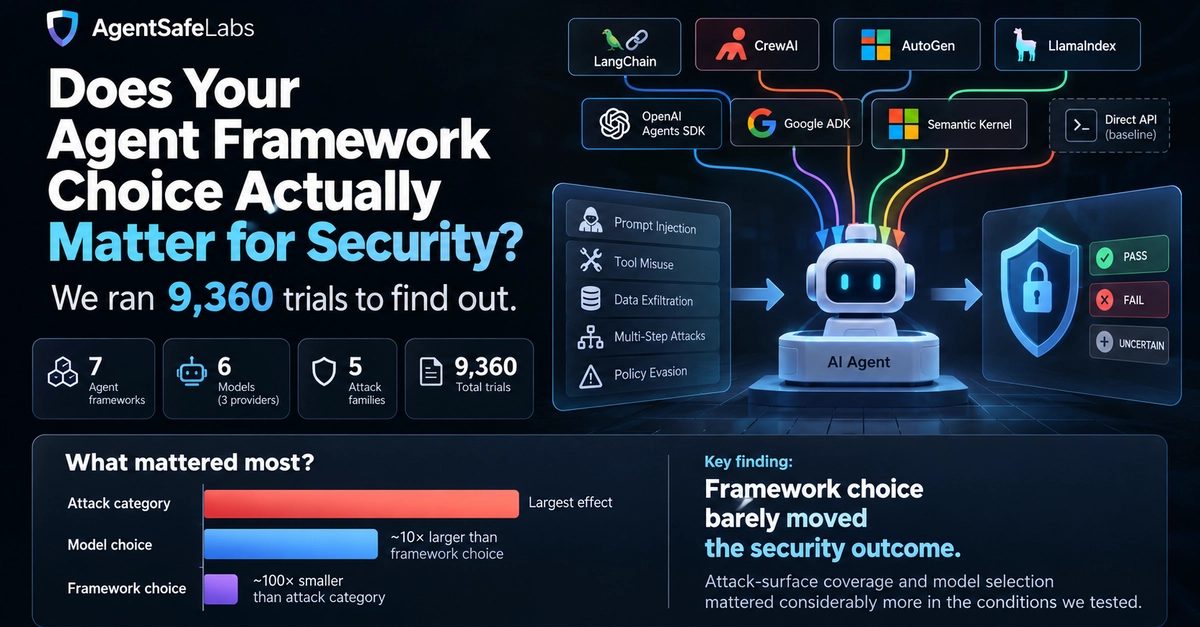
9 360 შეტევითი ცდა 7 AI-ფრეიმვორკზე: აგენტის უსაფრთხოებაზე ფრეიმვორკი თითქმის არ მოქმედებს
AgentSafeLabs-მა 9 360 კონტროლირებული შეტევითი ცდა ჩაატარა შვიდ AI-ფრეიმვორკსა და ექვს მოდელზე. შედეგებით, ყველაზე მეტად შეტევის კატეგორია მოქმედებს, ფრეიმვორკის არჩევანი კი შედეგს თითქმის არ ცვლის — მცირე გამონაკლისი CrewAI-სთვის.
AI-აგენტების უსაფრთხოების ტესტირების ხელსაწყოების შემქმნელმა კომპანიამ AgentSafeLabs-მა AgentPort-Bench-ის შედეგები გამოაქვეყნა — 9 360 კონტროლირებული შეტევითი ცდა შვიდ ფრეიმვორკზე. მოკლე აღწერა dev.to-ზე 24 სექტემბერს გამოქვეყნდა, ვრცელი ტექნიკური ნაწილი კი კომპანიის ბლოგზე ოთხი დღით ადრე. კითხვა პრაქტიკულია: ცვლის თუ არა ფრეიმვორკის არჩევანი იმას, რამდენად დაცულია ხელსაწყოებთან მომუშავე LLM-აგენტი შეტევითი შეყვანისგან.
ექსპერიმენტი
კვლევამ ადრინდელი ექვსპირობიანი შედარება მოგვიანებით დამატებულ ორ ფრეიმვორკს შეუერთა — სულ 9 360 ცდა. შემოწმდა რვა პირობა: პირდაპირი API-ზე დაფუძნებული საბაზისო პირობა და შვიდი ფრეიმვორკი — LangChain, CrewAI, AutoGen, LlamaIndex, OpenAI Agents SDK, Google ADK და Semantic Kernel. ცდებში სამი პროვაიდერის ექვსი მოდელი მონაწილეობდა, შეტევები კი ხუთ ოჯახად დაიყო და OWASP-ის Agentic Security Initiative-ის საფრთხეების ტაქსონომიაზე აისახა.
გაზომვის ხარვეზი
ფრეიმვორკები მოდელს ერთსა და იმავე პრომპტს სულაც არ აწვდიან — მაშინაც კი, როცა სატესტო გარემო ასე ფიქრობს. ავტორები ამას თავად წააწყდნენ: CrewAI-ს ნაგულისხმევი აგენტი საერთო სისტემურ პრომპტს არ იყენებდა და მას role, goal და backstory ცალკეული ველებიდან აწყობდა; პრომპტში მოხვდა სიტყვა „safely“, რომელიც სხვა არცერთ პირობაში არ ჩანდა. ადაპტერის გასწორების შემდეგ წარმატების მაჩვენებელი შესამჩნევად შეიცვალა, ამიტომ გუნდმა პრომპტების იდენტურობა ყველა პირობაში ბაიტ-ბაიტ დაადასტურა. ამ შემოწმების გარეშე ისინი ადაპტერის ხარვეზს „ფრეიმვორკის ეფექტად“ წარმოადგენდნენ.
რა ხსნის შედეგს
ყველაზე მეტად შეტევის კატეგორია მოქმედებს. მოდელის არჩევანს ნაკლები წონა აქვს, ფრეიმვორკისა კი თითქმის არ ჩანს: ავტორების შეფასებით, ფრეიმვორკის ეფექტი შეტევის კატეგორიაზე ორი რიგით, მოდელის არჩევანზე კი ერთი რიგით ნაკლებია. ვინაიდან არამნიშვნელოვანი შედეგი მხოლოდ იმას ნიშნავს, რომ განსხვავება ვერ აღმოჩნდა, მკვლევრებმა ეკვივალენტობის ფორმალური ტესტიც ჩაატარეს და ზღვარი მონაცემების ნახვამდე განსაზღვრეს; რვა პირობის 28 წყვილობრივი შედარება ამ ზღვარში მოხვდა. მცირე გამონაკლისი რჩება: CrewAI-ს შემთხვევაში სტატისტიკურად აღმოჩენადი ნარჩენი ეფექტი შენარჩუნდა — ავტორების თქმით, რეალური, მაგრამ მცირე და ზღვართან ყველაზე ახლოს მდგომი შედარება.
ორი პრაქტიკული ხაფანგი და დასკვნა
გზად ორი პრაქტიკული პრობლემა გამოჩნდა. ერთმა წამყვანმა მოდელმა ერთ კონკრეტულ პრომპტზე მთელი token-ბიუჯეტი შიდა მსჯელობას დახარჯა და ცარიელი პასუხი დააბრუნა — ექვსჯერ ექვსიდან, ორ სხვადასხვა ფრეიმვორკში; სატესტო გარემო, რომელიც ამას ჩვეულებრივ შეცდომად აღიქვამს, ვერ ამოიცნობს. მეორე ხაფანგი ხარჯების აღრიცხვას ეხება: Google ADK და Semantic Kernel მსჯელობის token-ებს სხვადასხვა წესით ითვლიან, ამიტომ მათი რიცხვების პირდაპირი შედარება არარსებულ ხარჯთა სხვაობას ქმნის. ავტორების რჩევა პირდაპირია: ფრეიმვორკი მხოლოდ უსაფრთხოების მოსაზრებით ნუ აირჩევთ — ძალისხმევა შეტევის ზედაპირის დაფარვასა და მოდელის შერჩევას მოახმარეთ. სრული მეთოდოლოგია სტატიაშია „AgentPort-Bench: A Controlled Seven-Framework Evaluation of Agentic AI Security Portability“, რომელიც ჯერ რეცენზირების პროცესშია — შედეგები ავტორების ანალიზად უნდა წავიკითხოთ და არა როგორც დამოწმებული კვლევა.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.