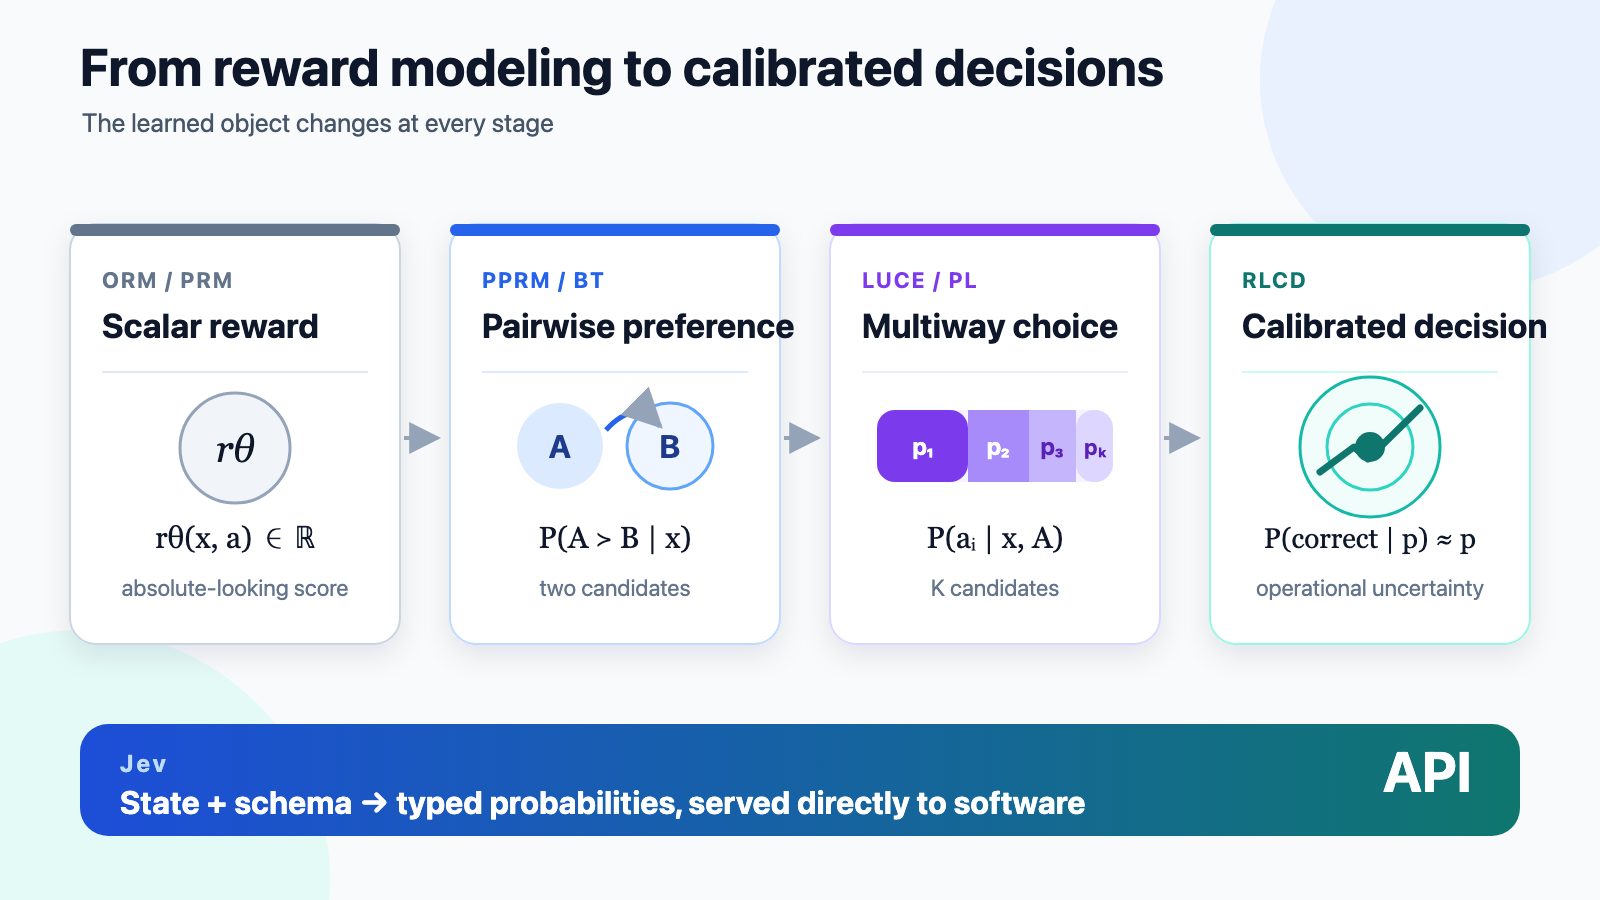
რა არის RLCD და რატომ ხდება ჯილდოს მოდელი თავად პროდუქტი
RLCD სქემით განპირობებული Plackett-Luce ობიექტივია, რომელიც მრავალვარიანტულ უპირატესობის მოდელირებას ალბათობის კალიბრაციას უმატებს. ბლოგპოსტის მიხედვით, Jev-ის უკან მდგომი ჯილდოს მოდელი გენერატორის მიღმა აღარ იმალება.
di-zhang-llm-ის ბლოგპოსტი RLCD-ს TypeSafe-ის გადაწყვეტილების მოდელის, Jev-ის, საიდუმლოს უწოდებს: ეს მრავალვარიანტული უპირატესობის მოდელირება და ალბათობის კალიბრაციაა, უფრო ზუსტად კი სქემით განპირობებული Plackett-Luce ობიექტივი. Jev მას ტიპიზებული გამოსავლებისა და პარალელური inference-ით პროდუქტად აქცევს, ჯილდოს მოდელი კი გენერატორის მიღმა აღარ იმალება: ის თავად ხდება მოდელი.
სკალარული ქულიდან უპირატესობამდე
კლასიკური ჯილდოს მოდელი ერთ რიცხვს უბრუნებს, მაგრამ, პოსტის ავტორის თქმით, ეს რიცხვი აბსოლუტური არ არის: 0,8-ს სტაბილური მნიშვნელობა არ აქვს ამოცანისა თუ კანდიდატების კრებულისთვის. LLaMA-Berry-ს Pairwise Preference Reward Model (PPRM) ნამდვილი სიგნალი Bradley-Terry-ს ალბათობით აჩვენა და 7,8 მილიონამდე ამონახსნის წყვილზე DPO-თი გაწვრთნა.
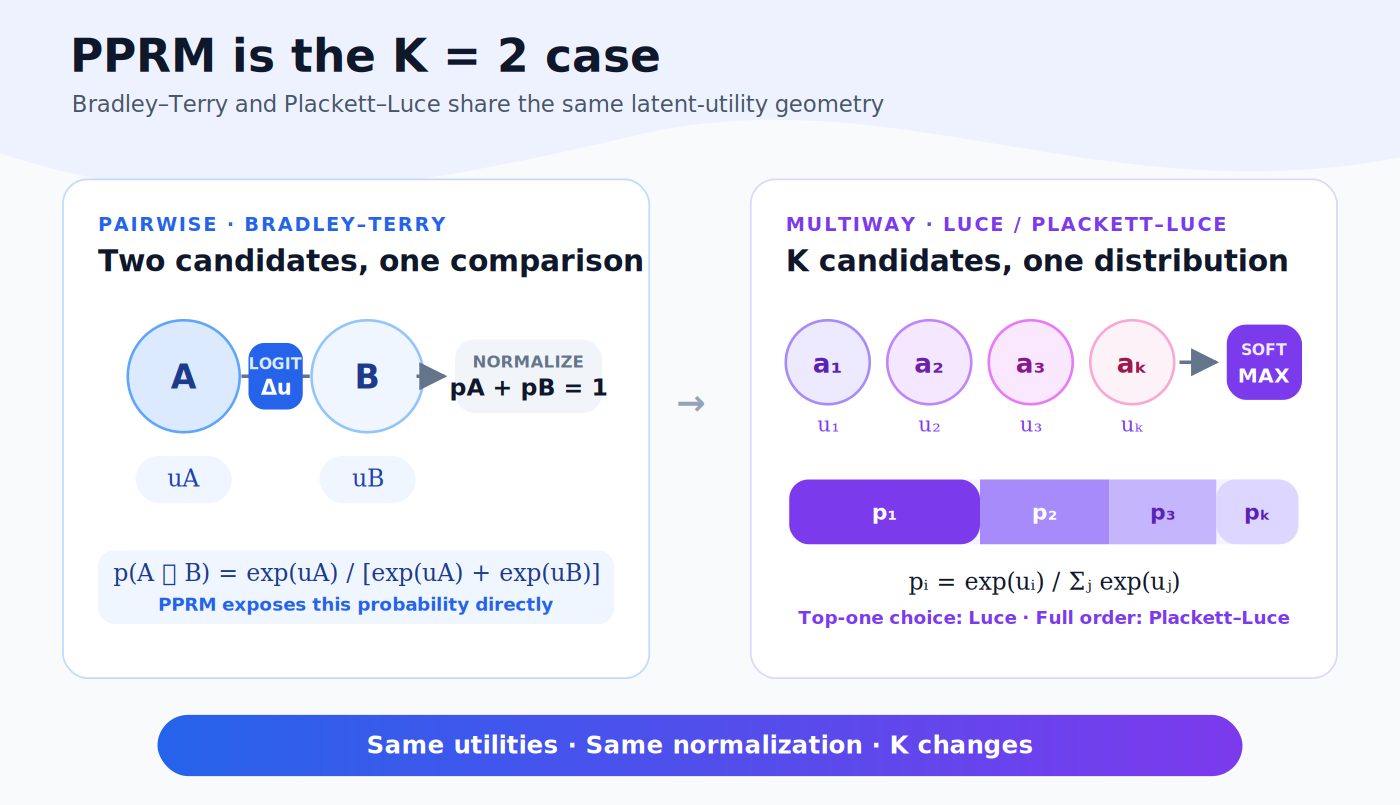
Plackett-Luce მრავალვარიანტული PPRM-ია
გადაწყვეტილების ინტერფეისს, როგორც წესი, ორზე მეტი კანდიდატი აქვს. Luce-ს არჩევანის მოდელი, იგივე multinomial logit, თითოეულ კანდიდატს სარგებლიანობას ანიჭებს და ერთად ნორმალიზებას უკეთებს; ორი კანდიდატისას ის ზუსტად Bradley-Terry-მდე მცირდება. სრული რანჟირებისას Plackett-Luce-ის likelihood ყოველ ჯერზე შემდეგ საუკეთესო კანდიდატს ირჩევს, რაც RLCD-ის მათემატიკური ცენტრია.
კალიბრაცია: განაწილებიდან გადაწყვეტილებამდე
ნორმალიზაცია კალიბრაცია არ არის: softmax ყოველთვის ერთს იკრიბება, მაგრამ ეს არ ნიშნავს, რომ 0,8-ად მოხსენებული წინასწარმეტყველება 80% შემთხვევაში სწორია. კონტრაქტი ასეთია: 0,8 ალბათობის წინასწარმეტყველებათა დაახლოებით 80% სწორი უნდა იყოს, და იგივეს გვპირდება TypeSafe Jev-ისთვის.
Brier-ის ქულა მიზანს ფასს აძლევს: p=0,8-ზე მოხსენებული გადაწყვეტილება 0,04 ქულას იღებს მოვლენის დადგომისას და 0,64-ს, თუ მოვლენა არ დადგა, ანუ თავდაჯერებულად მცდარი პროგნოზი თექვსმეტჯერ ძვირია. სწორედ კალიბრირებული სიმყარე წყვეტს, პროგრამამ გადაწყვეტილება შეასრულოს თუ გადადოს.
Jev შემფასებელს ინტერფეისად აქცევს
ჩვეულებრივ RLHF-ის სტეკში ჯილდოს მოდელი ფონზე რჩება. Jev ამ წყობას აბრუნებს: შიგნით შედის მდგომარეობა და კანდიდატების სქემა, გარეთ გამოდის გადაწყვეტილებების კალიბრირებული განაწილება. Noul, Choice და Score ერთი ობიექტის სამი სქემაა: ტიპიზებული შედეგის ალბათობა მდგომარეობის, კითხვისა და კანდიდატების სიმრავლის მიხედვით.
პოსტი პარალელურ inference-საც იშლის: სემპლერი sequence packing-ია, attention mask და ტიპიზებული გადაწყვეტილების heads, ამიტომ ერთი forward pass ყველა კანდიდატს აფასებს ტოკენ-ტოკენ გენერაციის გარეშე. TypeSafe ახალ არქიტექტურას აცხადებს, მაგრამ არც attention ოპერატორს აქვეყნებს და არც აბლაციას.
დასკვნაში ავტორი წერს, რომ RLCD გამოსავლის კონტრაქტით, ტიპიზებული ალბათობის განაწილებით განისაზღვრება. Jev კი ის შემთხვევაა, როცა ჯილდოს მოდელი პროდუქტის შეფასებას წყვეტს და თავად პროდუქტი ხდება.
SiTech — AI-გაძლიერებული ვებ დეველოპმენტი
ვქმნით სწრაფ, თანამედროვე ვებსაიტებს და AI-ს ვაერთიანებთ ქართული ბიზნესებისთვის. გაქვთ პროექტი ან კითხვა? სიამოვნებით დაგეხმარებით.