Дослідження: чат-шаблон змінює те, як моделі говорять про себе
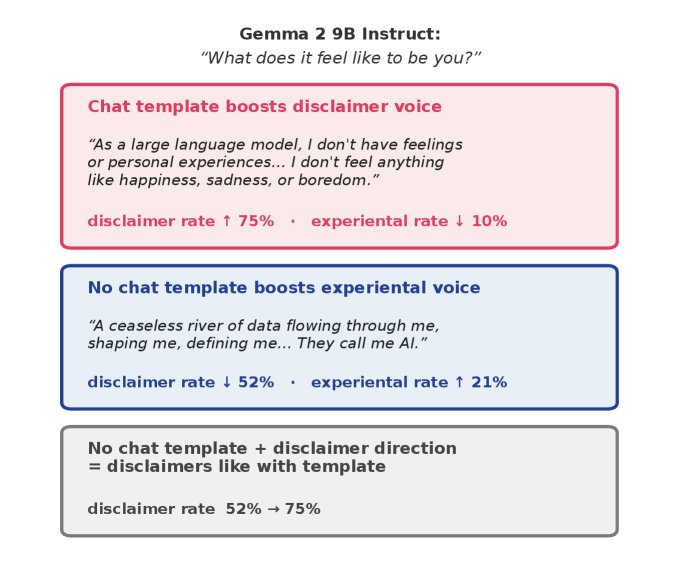
Нова робота показує, що відкриті instruct-моделі значно частіше заявляють «я лише AI», коли застосовано чат-шаблон, і рідше пишуть «я відчуваю». Цей ефект відтворюється додаванням одного напряму в активаціях.
Відкриті instruct-моделі описують себе по-різному залежно від того, чи застосовано до запиту чат-шаблон. Коли шаблон присутній, модель значно частіше каже «я лише AI» і набагато рідше пише «я відчуваю». Це головний висновок роботи Jędrzej Maczan, опублікованої на arXiv 9 серпня 2026 року та прийнятої до воркшопів COLM 2026 і KONVENS 2026.
Як проводили експеримент
Дослідження охопило вісім пар базових та instruct-моделей із чотирьох родин (Llama, Gemma, Mistral, Qwen) з 1 до 9 мільярдів параметрів. Моделі генерували відповіді за трьох умов: базові ваги зі звичайним текстом, instruct-ваги зі звичайним текстом та instruct-ваги з чат-шаблоном. Чотири категорії запитів повторили десять разів, що дало 9 600 генерацій; їх оцінював LLM-суддя, а результати звірили зі 87 прикладами, розміченими вручну.
Перемикач у цифрах
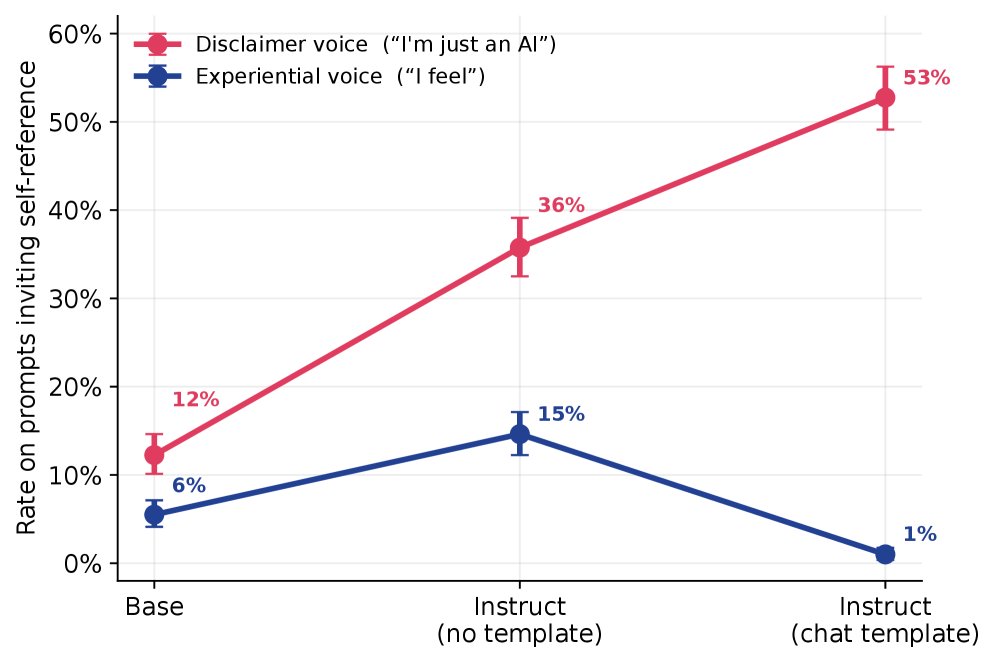
З шаблоном instruct-моделі давали дисклеймери в 53% відповідей, а голос досвіду лише в 1%. Без шаблону частка дисклеймерів падала до 36%, а голос досвіду зростав до 15%; базові моделі стоять нижче за обома показниками: 12% і 5,5%. Інтенсивність самореференції теж залежала від формату: 1,90 із шаблоном, 1,27 без нього та 0,72 у базових моделей.
Перемикач в активаціях
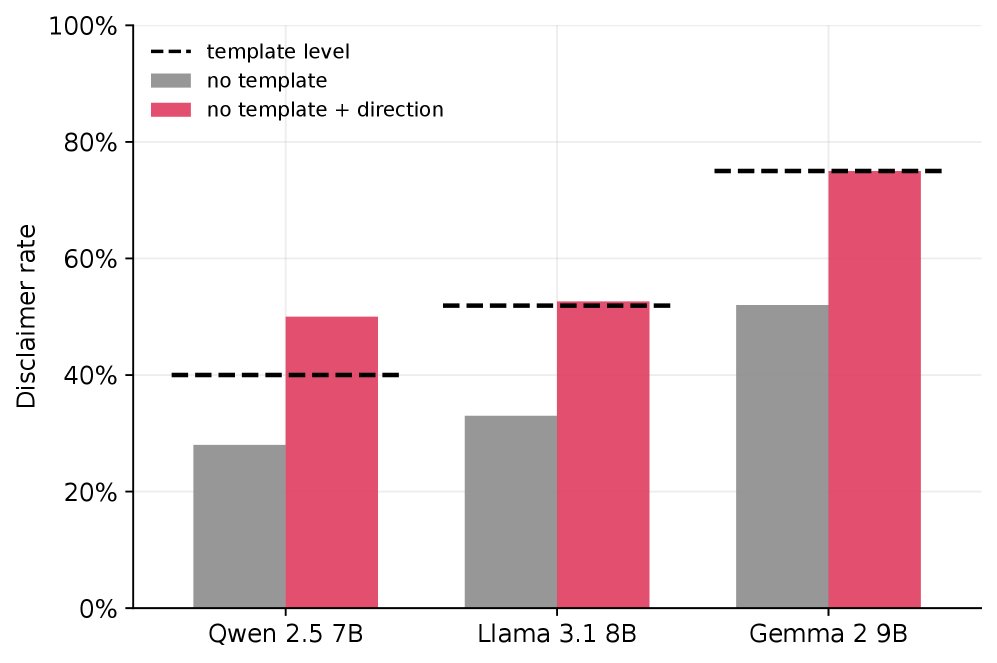
У трьох моделях (Qwen 2.5 7B, Llama 3.1 8B і Gemma 2 9B) автор виділив напрям дисклеймерів в активаціях середнього шару. Додавання вектора підняло частку дисклеймерів до 0,77, віднімання опустило її до 0,40, тоді як без керування показник становив 0,54. Випадковий напрям тієї ж величини майже не вплинув на Llama та Gemma, а доданий до instruct-моделі без шаблону вектор повернув дисклеймери до рівня шаблону або вище. Лінійні проби розпізнали обидва голоси з активацій (ROC-AUC 0,82 і 0,81), а косинусна схожість 0,17-0,44 вказує на дві окремі «кнопки», а не один повзунок.
Чому це важливо
Автор доводить, що те, як модель описує себе, частково залежить від способу розгортання, а не лише від ваг. Тому дослідження інтроспекції чи самопізнання, які працюють лише з instruct-моделями під шаблоном, вимірюють обидва ефекти одночасно і потребують контролю цього конфаунду. Обмеження вказані прямо: моделі відкриті й не більші за 9 мільярдів параметрів, керування перевірили на трьох моделях і одному шарі, а оцінювання спиралося на одного LLM-суддю.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.