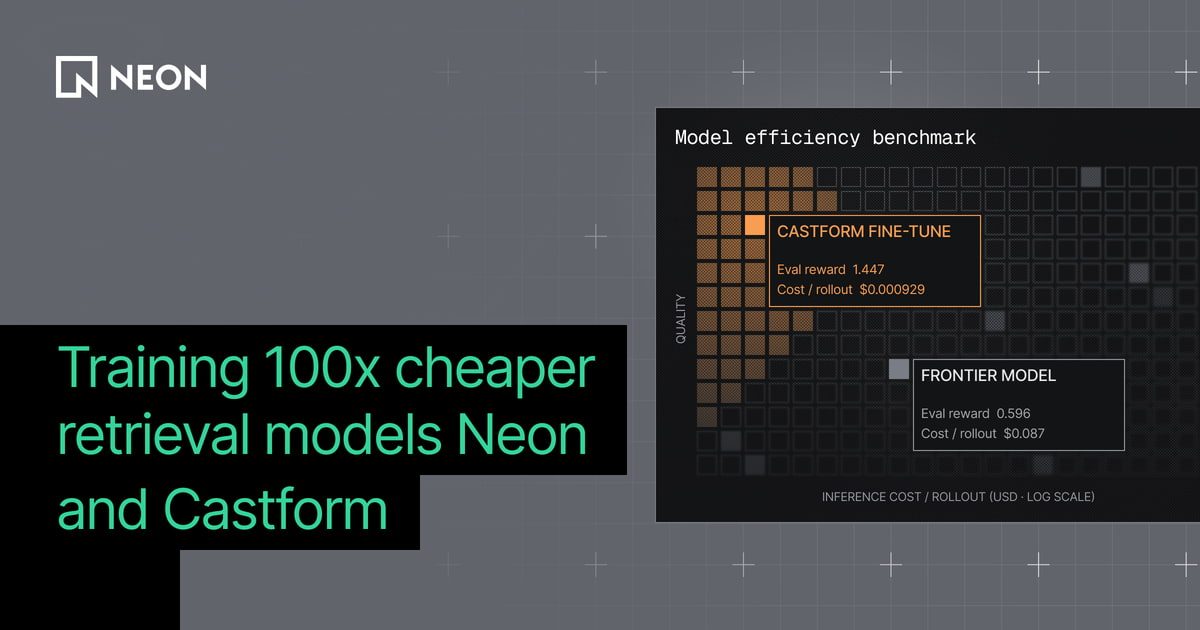
4B відкрита модель зрівнялася з GPT-5.6 Sol у пошуку — у 100 разів дешевше
Спільний матеріал Neon і Castform показує, як відкрита 4B-модель після RL-дообучення наздоганяє фронтирну модель у задачах пошуку за значно нижчої вартості.
Проблема вартості в агентному пошуку
5 серпня 2026 року Neon опублікувала спільний матеріал із Castform про те, як відкрита 4B-модель, дообучена методом підкріплювального навчання (RL), може зрівнятися з фронтирною пропрієтарною моделлю в задачах пошуку, коштуючи приблизно у 100 разів менше за запит.
Стаття простежує зміну в тому, як агенти шукають інформацію. Приблизно у 2022 році галузь інвестувала в embedding-пошук — pgvector став найзавантажуванішим розширенням Neon — а інженери вручну будували RAG-пайплайни. До 2025 року пошук став агентним: моделі планують і шукають у циклі, а не видають один запит. Кожна ітерація циклу — це ще один виклик фронтирної моделі, а типовий багатокроковий запит із gpt-5.6-sol триває понад 10 секунд і коштує близько $0.03 від початку до кінця.
Як навчають відкриту модель шукати
Малі відкриті моделі приблизно у 100 разів дешевші, але з коробки поступаються закритим API-моделям. Цю прогалину закриває RL-дообучення. Мета Castform — дати розробникам змогу дообучати моделі без роботи з внутрішніми механізмами машинного навчання та GPU; співзасновник компанії Ying Hang Seah описує це як таке ж доступне, як і prompt engineering, і зазначає, що найкращі тренувальні дані більшості команд уже лежать у їхніх базах даних.
Пайплайн повністю працює на Neon: сирі документи зберігаються в Postgres, синтетичні тренувальні задачі записуються розширеннями lakebase_text і lakebase_vector, кожен пошуковий виклик під час rollout-ів іде через Lakebase Search, і продакшн-інференс використовує той самий пошуковий інструмент. Функція винагороди оцінює три речі: чи знайдено правильне джерело, чи процитовано правильний фрагмент і чи дано правильну відповідь.
Інфраструктура для пікових навантажень
Тренування створює різко нерівномірне навантаження: тисячі паралельних rollout-ів, кожен з яких робить десятки пошукових викликів. Динамічне автомасштабування Neon поглинає ці піки без потреби резервувати максимальну потужність цілодобово. Автори зазначають, що ця інфраструктура стає ще важливішою, коли агенти починають змінювати дані: branching дає кожному rollout-у ізольований стан бази, а time-travel-запити дозволяють відтворити, що саме бачив агент.
Головний висновок: на конкретній задачі, як-от пошук, дообучена відкрита модель може зрівнятися з фронтирними моделями й перевершити їх за на порядки нижчої вартості — тобто агентний пошук більше не мусить працювати на найдорожчій доступній моделі.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.