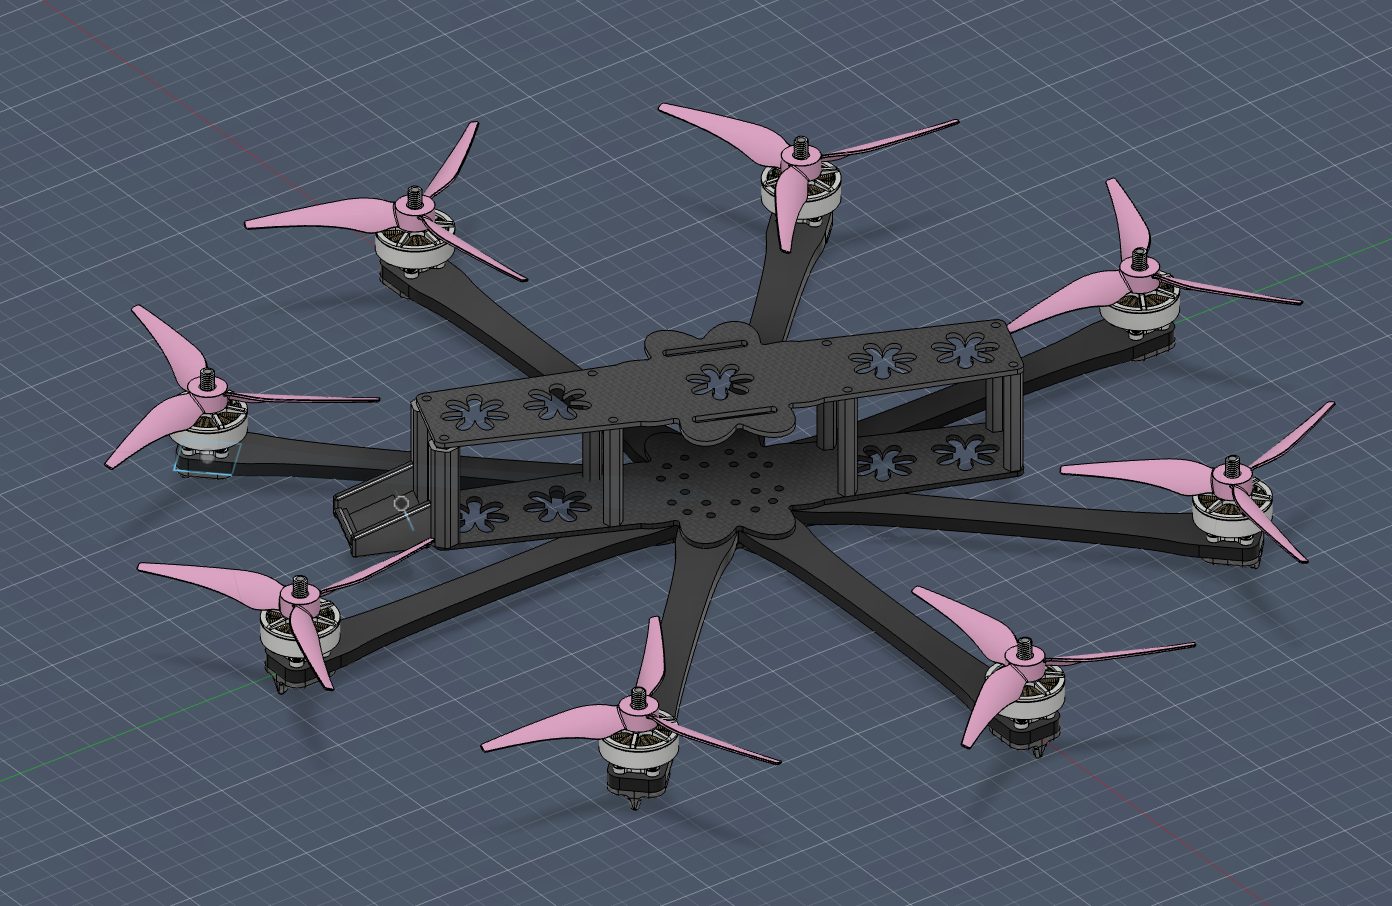
Інженерка зібрала октокоптер з нуля без досвіду в апаратному забезпеченні
Кароліна Дубєль зібрала власний октокоптер без досвіду в апаратному забезпеченні: від ідеї до першого польоту 2,5 тижня, до польоту під керуванням RL — менш ніж вісім. Політика витримала три й чотири відмови двигунів.
Програмна інженерка Кароліна Дубєль, яка раніше не мала жодного суттєвого апаратного проєкту, сама спроєктувала, обробила на верстаті, спаяла й підняла в повітря власний октокоптер — а потім навчила політику навчання з підкріпленням, яка тримає апарат у повітрі після відмови двигунів. Від ідеї до польоту без RL минуло два з половиною тижні, а до польоту під керуванням RL — менш ніж вісім.
Від Fusion 360 до корпусу, зібраного вручну
Корпус спроєктовано у Fusion 360 і вирізано на CNC-фрезері: промені зі склопластику G10, пластини корпусу з 5-міліметрового вуглеволокна, промені переплетені в центрі для жорсткості. Далі — чотири етапи: складання, підключення електроніки та політ як звичайного октокоптера, навчання політики для відмови двох двигунів і перехід sim-to-real.
Мережа на 43 000 параметрів із частотою 50 Гц
Фінальний контролер невеликий: двошарова MLP по 128 нейронів у шарі — близько 43 000 параметрів — працює на 50 Гц на власному польотному контролері дрона, вкомпільована в C++ ArduPilot на рівні змішування двигунів, без супутнього комп'ютера й без донавчання після симуляції. Вона читає останні десять кадрів стану (близько 0,2 с): орієнтація, кутові швидкості, позиція, швидкість і канал із восьми значень із тягою кожного двигуна.
Навчання відбувалося повністю в симуляції — MuJoCo з PPO через PufferLib — на фіксованій суміші епізодів із нулем, одним або двома мертвими двигунами (ваги 0,1, 0,2 і 0,7) і за курсом, що нарощує доменну рандомізацію від номінальної до повної. Один прийом — голова усереднення за симетрією: мережа проганяє ваги двічі, на справжньому стані й на тому ж стані, переозначеному поворотом корпусу на 180°, і усереднює результати, що робить політику точно еквіваріантною без додаткових параметрів.
Що вона витримала — і урок про reward hacking
Навчена лише на нуль, одну та дві відмови, політика утримувала позицію на реальному апараті навіть за трьох і чотирьох мертвих двигунів. Авторка визнає, що попередня версія була класичним прикладом reward hacking: зависання на чотирьох двигунах давало ті самі бали, що на восьми, тож агент глушив здорові двигуни й літав як квадрокоптер. Додавання винагороди за використання всіх доступних двигунів дало перенавчання, яке утримувало всі вісім двигунів у 20 із 20 епізодів зависання — на 3,6% менш точно — і краще переживало відмови поза межами тренувального розподілу: 99% проти 90% за трьох мертвих двигунів і 85% проти 64% за чотирьох.
Помилки, про які варто прочитати
Журнал збірки описує також три помилки ідентифікації системи, які зробили всі попередні цифри стійкості до відмов неправильними: відстань від центру мас до двигуна була вписана як 35,20 мм замість реальних 181,938 мм; у формулі інерції використовувалося 8π² замість 4π²; а розкладку двигунів змоделювали як «+», тоді як корпус — «X». Разом це залишило симульованому дрону приблизно у 2,6 раза менше керуючого впливу, ніж у реального. Після виправлень виживаність за подвійної відмови в умовах повної доменної рандомізації зросла з 71,7% до 95,8%, а найважчих пар із некомпенсовним рисканням — з 41,2% до 94,6%.
Октокоптер обрано свідомо: квадрокоптер, втративши двигун, мусить повністю віддати керування рисканням, аби втриматися в повітрі.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.