NVIDIA показала ефективний шлях навчання MoE для біологічних фундаментальних моделей
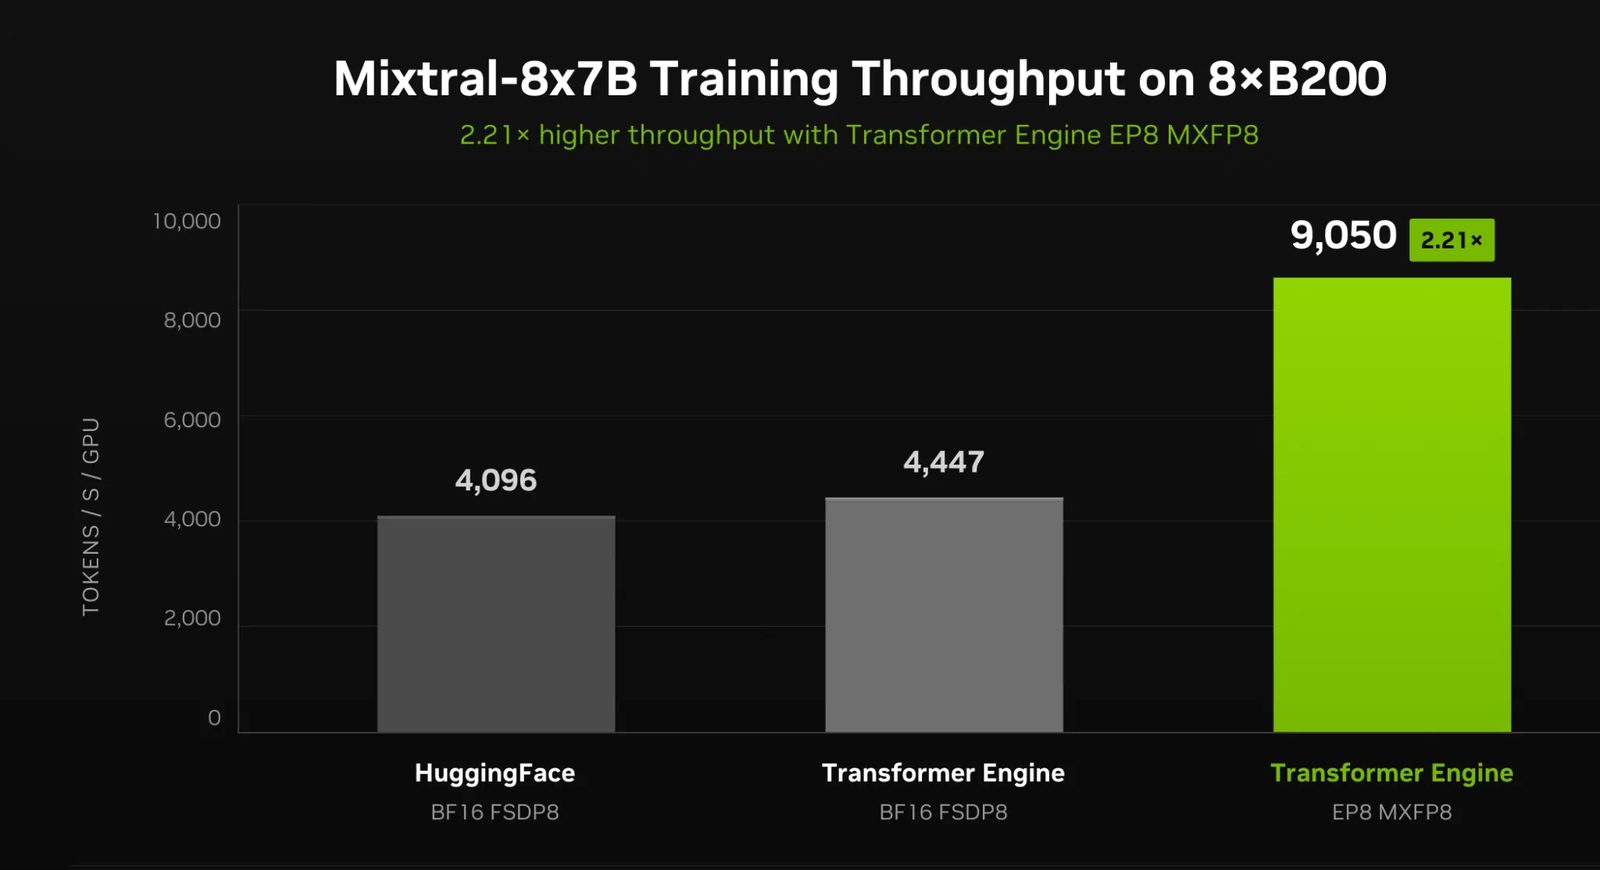
У новому технічному посібнику NVIDIA розповідає, як Transformer Engine і рецепт BioNeMo пришвидшують навчання MoE-моделей для біології: на восьми GPU B200 вдалося досягти у 2,21 раза вищої пропускної здатності за базовий варіант.
NVIDIA опублікувала технічний посібник про ефективніше навчання біологічних фундаментальних моделей за архітектурою суміші експертів (MoE). Автори матеріалу Faradawn Yang, Peter St John, Kyle Tretina і Zoey Zhang.
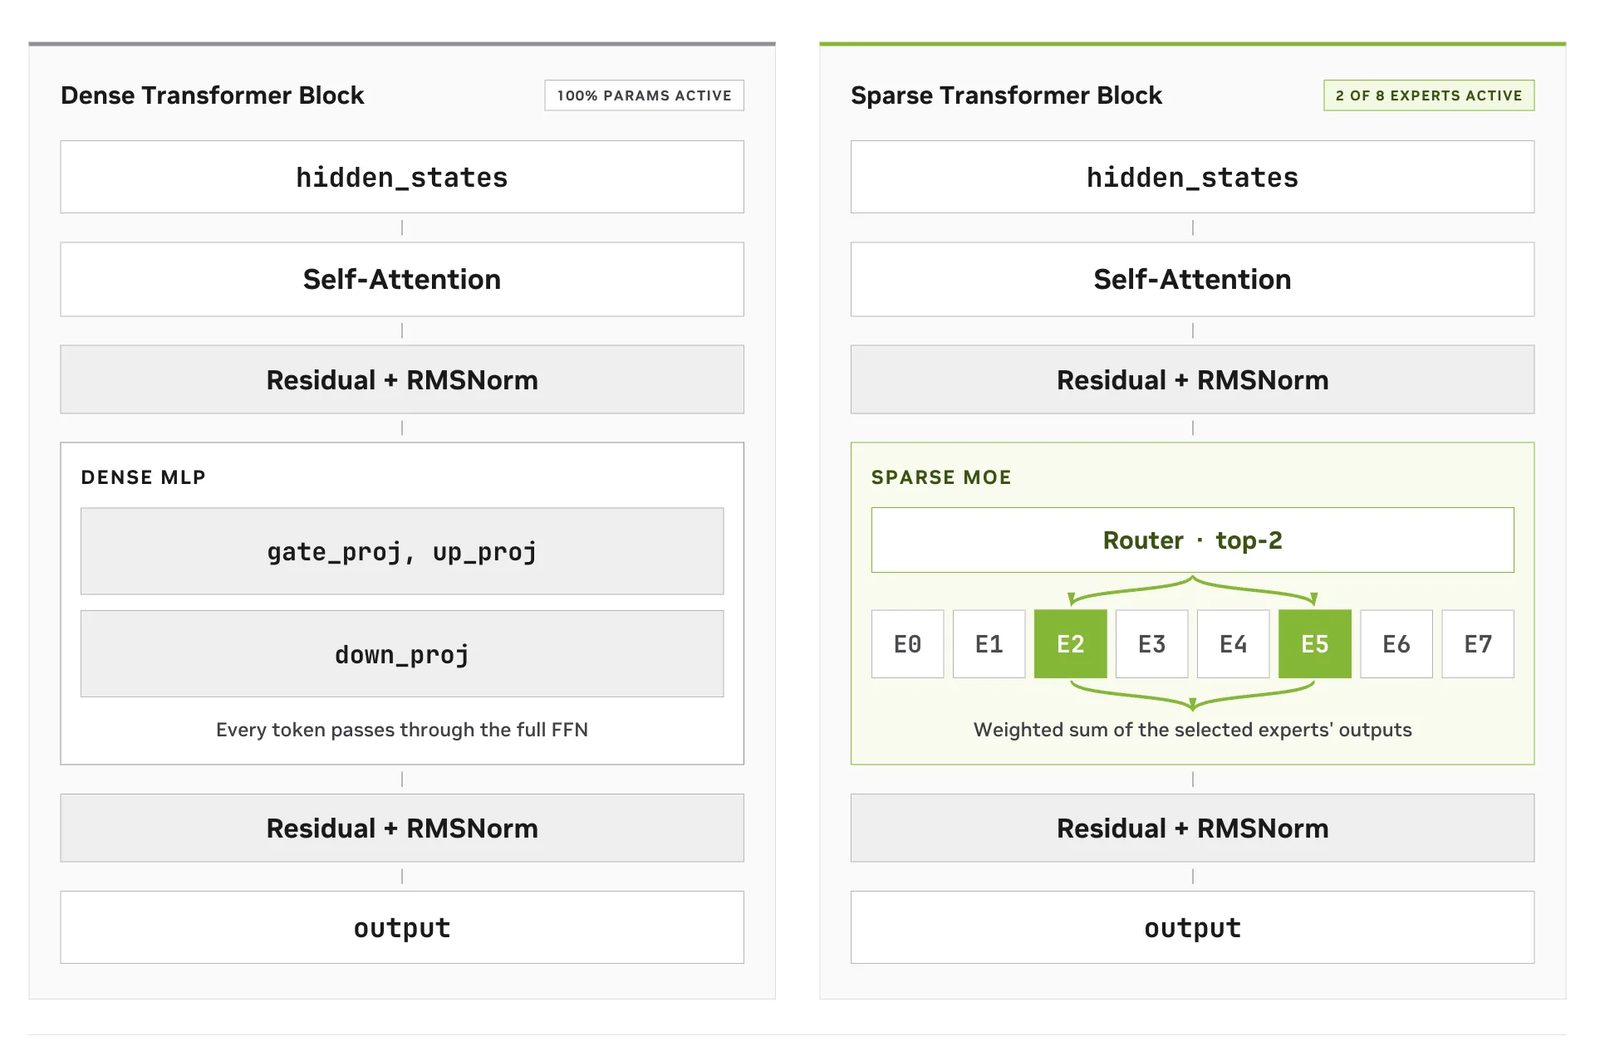
Щільні трансформери пропускають кожен токен крізь усі шари, тому додаткова ємність коштує дорого і в навчанні, і в інференсі. MoE-архітектури ділять блок feed-forward на багато експертів і активують лише частину з них для кожного токена. Результат залежить від реалізації: роздроблені обчислення експертів знижують завантаження GPU, маршрутизація додає витрат на комунікацію, а більша кількість параметрів тисне на пам'ять.
Згруповані експерти замість циклу Python
Перша проблема це фрагментація ядер. У базовій реалізації Hugging Face експерти виконуються по черзі в циклі Python, і кожен запускає окремі ядра. GroupedLinear у TE збирає ваги експертів та вхідні токени й виконує всі лінійні перетворення одним груповим викликом GEMM, приймаючи кількість токенів на експерта через аргумент split_sizes. Стек NVIDIA може об'єднати це проєктування з квантуванням MXFP8 в ядрі GroupedMLP.
Пам'ять і витрати на квантування
У MoE-моделей більше параметрів, а геномні задачі часто використовують довгі послідовності, що тисне на пам'ять активацій. BF16 зберігає кожне значення в 16 бітах, FP8 і MXFP8 у 8. MXFP8 призначає коефіцієнт масштабу на кожен блок із 32 послідовних значень, а на GPU Blackwell такі GEMM виконуються спеціалізованими інструкціями Tensor Core.
Навчання з низькою точністю все одно зберігає основні ваги моделі в 16 бітах, тож квантування й деквантування додають роботи. Послідовність GroupedLinear, ScaledSwiGLU і GroupedLinear через API Sequential у TE дозволяє замінити цей шаблон однією об'єднаною операцією: ForwardGroupedMLP_CuTeGEMMSwiGLU_MXFP8 для прямого проходу.
У 2,21 раза вища пропускна здатність на восьми GPU B200
У тесті з моделлю Mixtral-8x7B на восьми GPU NVIDIA B200 Tensor Core рецепт сягнув до 2,21 раза вищої пропускної здатності, ніж базова реалізація Hugging Face. Об'єднані ядра MXFP8 GroupedMLP потребують апаратного забезпечення Blackwell, а паралелізм експертів щонайменше двох GPU.
У посібнику наведено команди запуску: L0_sanity на двох GPU для перевірки середовища, далі L1_8x7B_ep із паралелізмом експертів (EP=8) і точністю MXFP8 на восьми GPU.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.