Fireworks AI випустила Ember-1: якість Kimi K3 за 40% меншої кількості токенів
Fireworks Research представила Ember-1, спеціалізовану модель на базі Kimi K3. За словами компанії, вона зберігає якість базової моделі, витрачаючи приблизно на 40% менше токенів.
Fireworks AI випустила Ember-1, спеціалізовану модель, яку команда Fireworks Research побудувала на основі Kimi K3. У публікації від 23 вересня 2026 року компанія заявляє, що Ember-1 дає ту саму якість відповідей, що й Kimi K3, витрачаючи на 40% менше токенів: модель навчилася пропускати міркування, які не впливають на фінальну відповідь.
Чому моделі міркування дорожчають
Моделі міркування, як-от Kimi K3, витрачають більшість згенерованих токенів, іноді понад 90%, на внутрішні міркування, а не на саму відповідь, пише компанія. У багатокрокових агентних задачах стає ще гірше: кожен крок повертає попередні міркування в контекст, тому контекст зростає приблизно квадратично щодо кількості кроків. Зниження рівня міркувань Kimi K3 проблему не вирішило, адже слабші налаштування занадто втрачали в якості. Тож модель довелося навчити міркувати ефективніше: команда провела понад 50 тренувальних експериментів і понад 200 оцінювань та розробила нові алгоритми, які скорочують міркування без втрати точності.
Бенчмарки та межа Парето
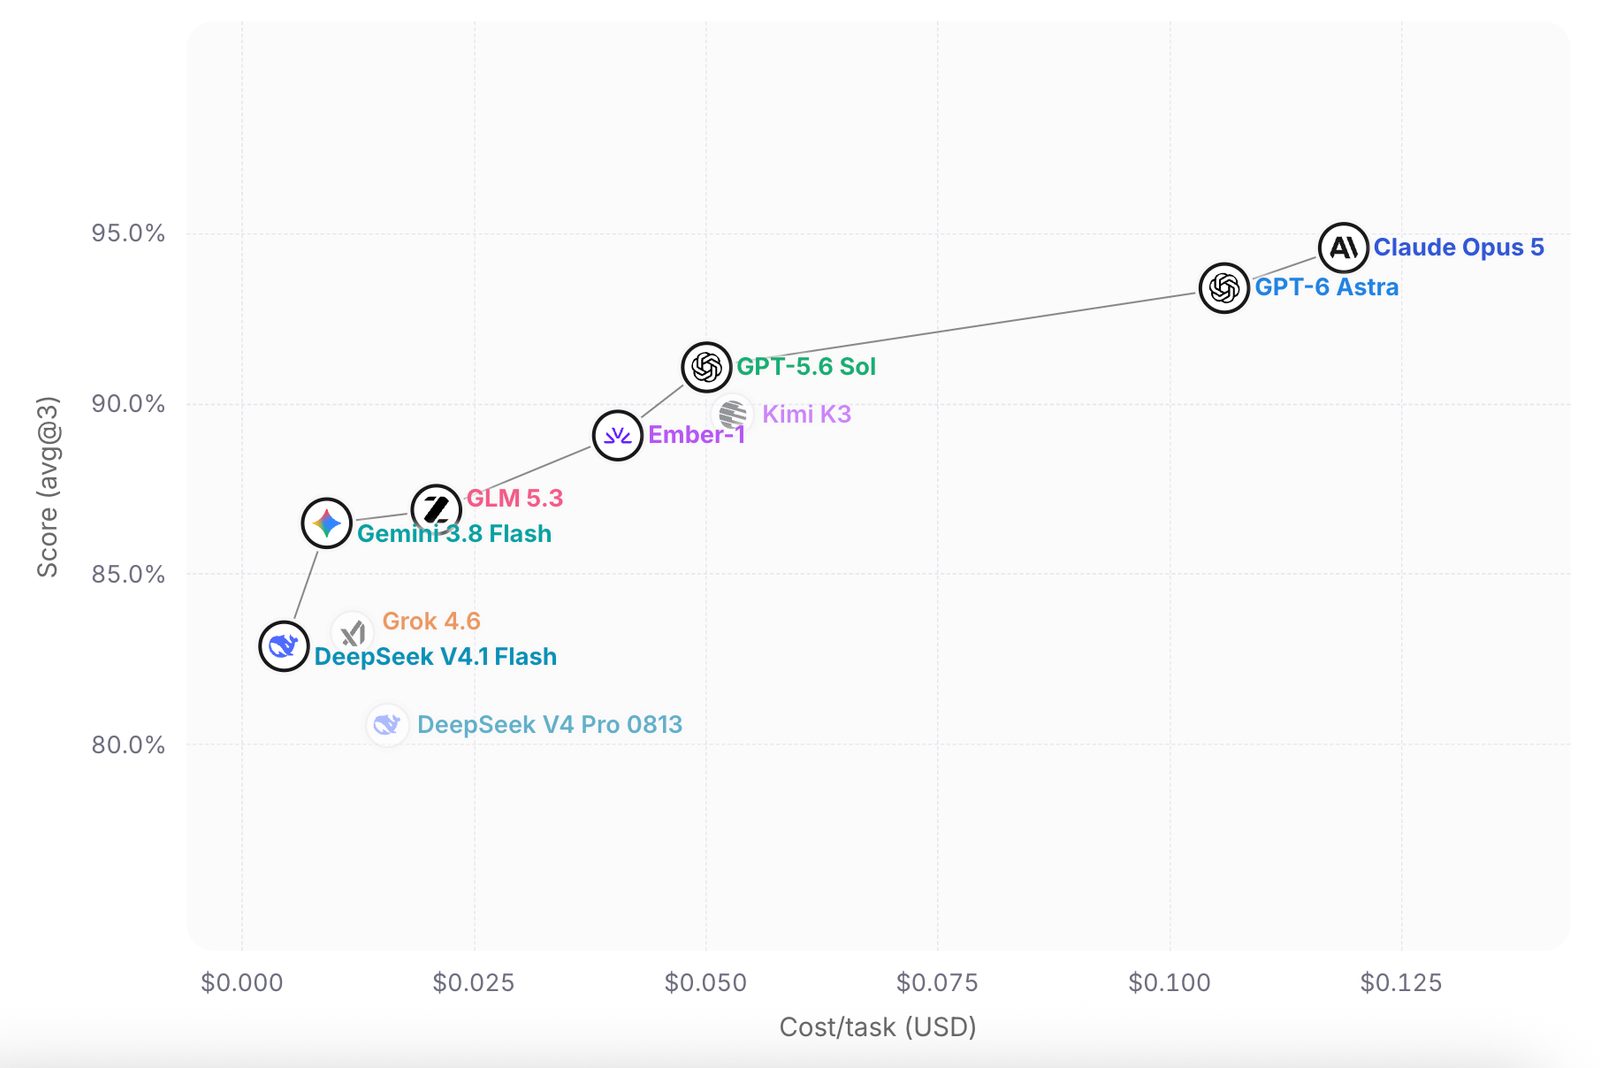
На семи бенчмарках і на продакшн-трафіку двох клієнтів Fireworks з'ясувала, що міркування Kimi K3 можна скоротити на 35-50% без втрати точності. На Bedside Bench від Doximity, підтвердженому лікарями бенчмарку з 500 клінічних випадків у 10 категоріях, Ember-1 визначила нову межу Парето за вартістю на задачу серед відкритих і закритих моделей, зокрема GPT-5.6 Sol, GPT-6 Astra та Claude Opus 5.
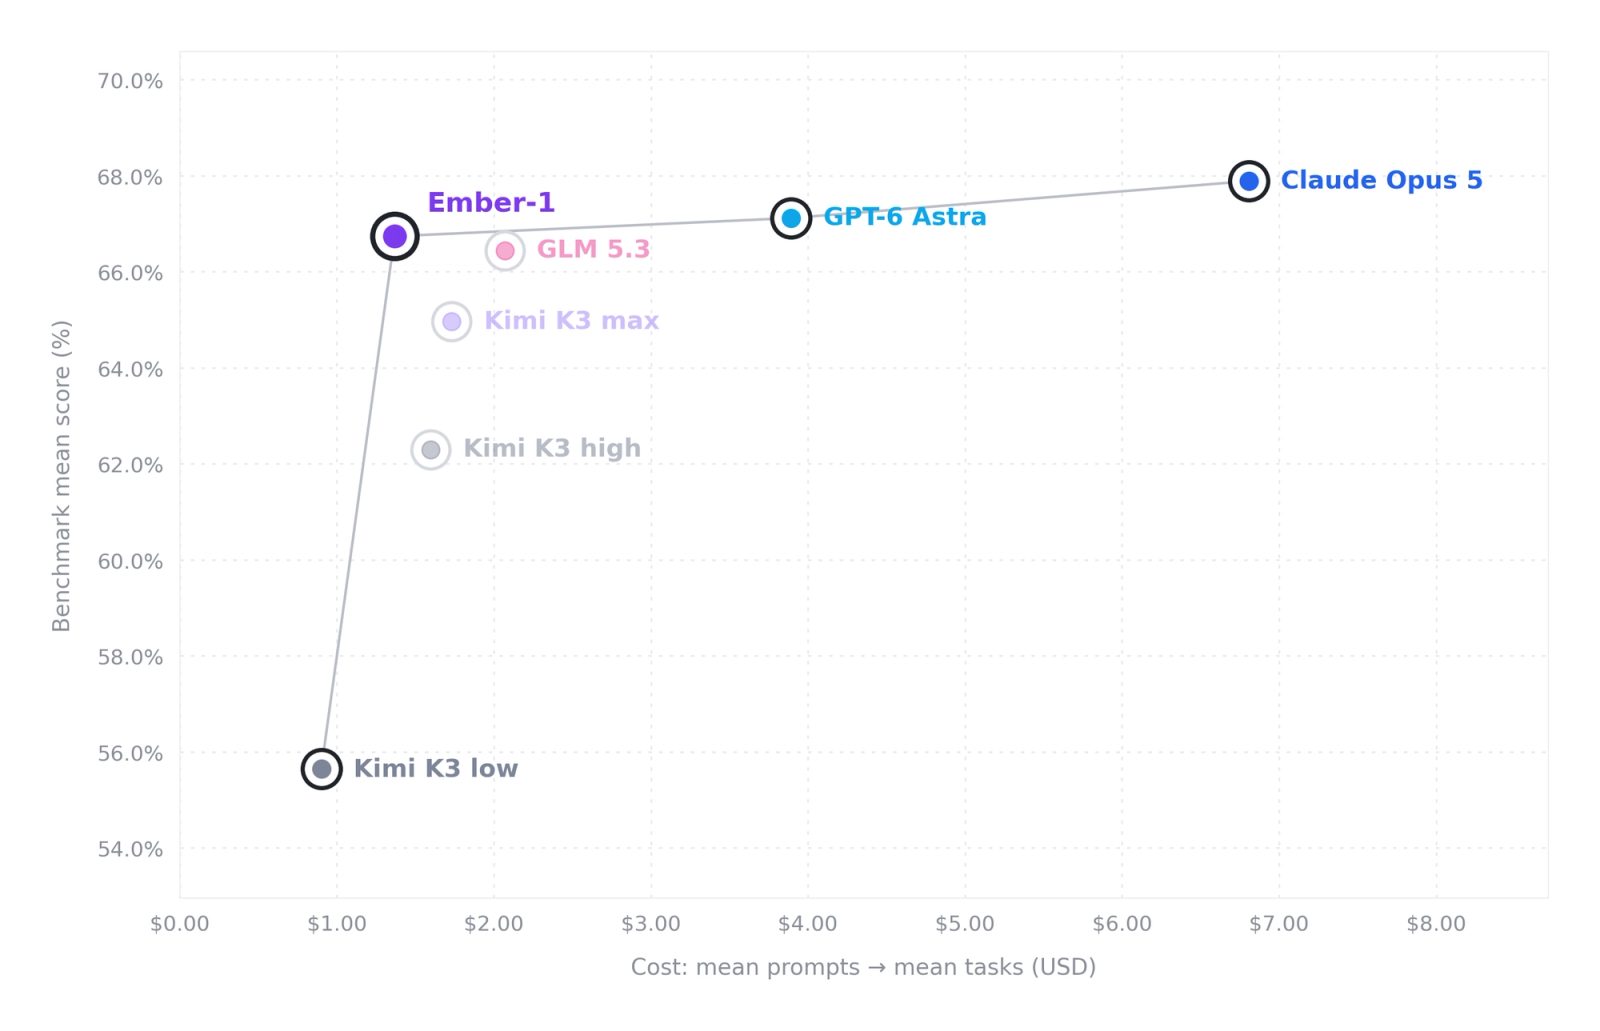
На окремих бенчмарках результати близькі. Terminal Bench 2.1: 82,0% проти 80,9%. DeepSWE 1.1: 75,2% проти 66,4%. SWE-bench Verified: 92,2% проти 93,2%. SWE-Interact: 20,0% проти 21,3%. За оцінкою Fireworks, Ember-1 також переважає Kimi K3 у режимі низьких міркувань.
A/B-тести, внутрішнє впровадження і плани
Два клієнти провели живі A/B-тести на своїх продакшн-задачах із кодування: витрати токенів на задачу скоротилися приблизно на 35% за порівнянної якості. В одному тесті середня оцінка задачі зросла з 0,751 до 0,753, а вихідні токени впали з 49,3 тис. до 29,9 тис.: міркувальних токенів стало на 71,3% менше, а загальна економія склала 39%. Показники завершення задач і збоїв залишилися на місці або покращилися, і один клієнт уже використовує Ember-1 у продакшні, плануючи повністю замінити базову модель.
Перш ніж показати модель клієнтам, Fireworks перевела на неї власних розробників. Компанія називає результат «відсутністю новин»: інженери продовжили роботу й не помітили зміни. Ember-1 розповсюджується як варіант обслуговування поряд із базовою Kimi K3 у форматі дослідницького прев'ю на Serverless. Також запускається підтримка донавчання для компаній, які хочуть будувати на власних даних налаштовані моделі з економним витрачанням токенів.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.