Конфіденційні обчислення NVIDIA зберігають 96% пропускної здатності AI-інференсу на Blackwell
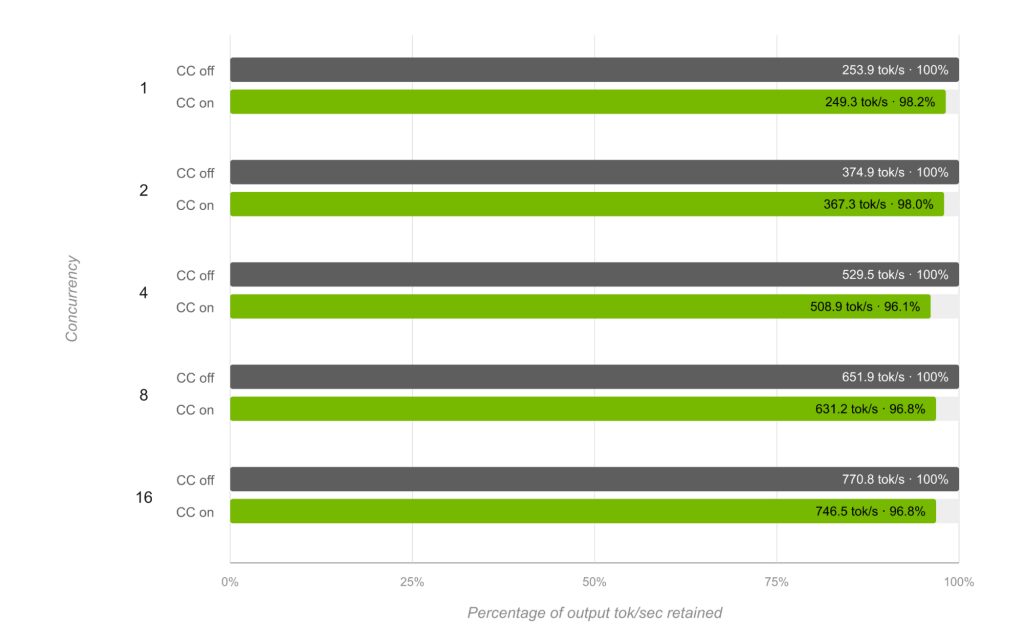
За даними технічного блогу NVIDIA, TensorRT LLM із увімкненими конфіденційними обчисленнями зберіг 96,1-98,2% пропускної здатності вихідних токенів на восьми GPU Blackwell B200.
NVIDIA опублікувала технічний розбір того, як конфіденційні обчислення (confidential computing, CC) впливають на інференс великих мовних моделей, і як адаптували TensorRT LLM, щоб зашифроване виконання на GPU Blackwell зберігало більшу частину швидкості.
Зашифрована пам'ять змінює припущення runtime
Конфіденційні обчислення виконують навантаження всередині віртуальних машин із зашифрованою пам'яттю, на конфіденційних GPU та із зашифрованим NVLink. Проте захищене виконання змінює припущення runtime щодо переміщення даних, вимірювання часу, планування та обміну між кількома GPU, і ці зміни коштують продуктивності, якщо фреймворк не адаптується.
Щоб зробити накладні витрати видимими, команда обрала довгий контекст, тривалу генерацію та низьку паралельність: DeepSeek-R1-0528-NVFP4 на PyTorch-backend TensorRT LLM, 32K вхідних і 1K вихідних токенів, від 1 до 16 одночасних запитів, TP=8 та FP8 KV-кеш.
96% пропускної здатності збережено
Змінювався лише стан CC: модель, обладнання, версії ПЗ, довжини послідовностей, паралельність і навантаження не змінювалися. Стенд: одна система NVIDIA DGX B200 з вісьмома GPU B200, Intel TDX, CUDA 13.2, NCCL 2.30 і TensorRT LLM 1.3.0rc22.
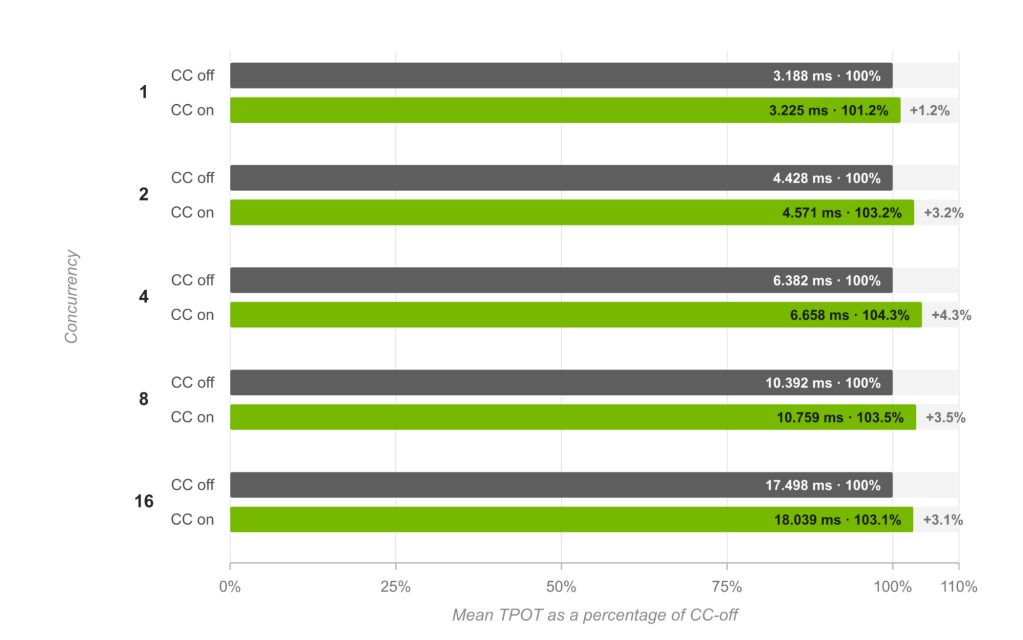
На рівнях паралельності 1-16 увімкнений CC зберіг 96,1-98,2% пропускної здатності вихідних токенів, а середній час на вихідний токен залишився в межах 1,2-4,3% від базового.
Три місця, які довелося адаптувати
Передавання host-to-device проходить через програмний зашифрований bounce buffer, бо GPU не має прямого доступу до захищеної пам'яті CVM. Через це pinned memory втрачає асинхронну перевагу, а деякі копіювання блокують потік; TensorRT LLM обирає тип пам'яті з урахуванням CC і переносить читання токенів в асинхронний воркер (PR #11573).
Автотюнер ядер порівнює тактики через CUDA events, але під CC сигнал часу виявився нестабільним; тепер він вимірює через GPU %globaltimer (PR #11657). Мультикаст NVLink SHARP недоступний у конфігураціях B200 CC, тому фреймворки мають перевіряти наявність NVLS і обирати алгоритми під розмір повідомлення та топологію.
Виміряйте власне навантаження
Порада NVIDIA — розглядати налаштування безпеки й оптимізацію інференсу як одну задачу розгортання: увімкніть конфіденційні обчислення, пройдіть атестацію середовища та порівняйте CC-on і CC-off на тому навантаженні, яке збираєтеся обслуговувати.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.