Сім плат ESP32-S3 запускають мовну модель на 1,58 біта як один кластер
Проєкт на GitHub розділяє квантований Qwen2-0.5B на 24 шари між шістьма обчислювальними вузлами ESP32-S3 і одним мастером, з'єднаними через SPI. Тернарні ваги тримають прошивку кожного вузла в межах 16 МБ флешпам'яті.
Опублікований на GitHub проєкт ESP32s3-LLM-Cluster показує, як сім плат ESP32-S3 разом обслуговують одну невелику мовну модель. Шість із них є обчислювальними вузлами, а сьома, мастер, виконує BPE-токенізатор, пошук у таблиці ембедингів, фінальну нормалізацію та LM Head. За основу взято Qwen2-0.5B, скорочений і квантований для мікроконтролерів.
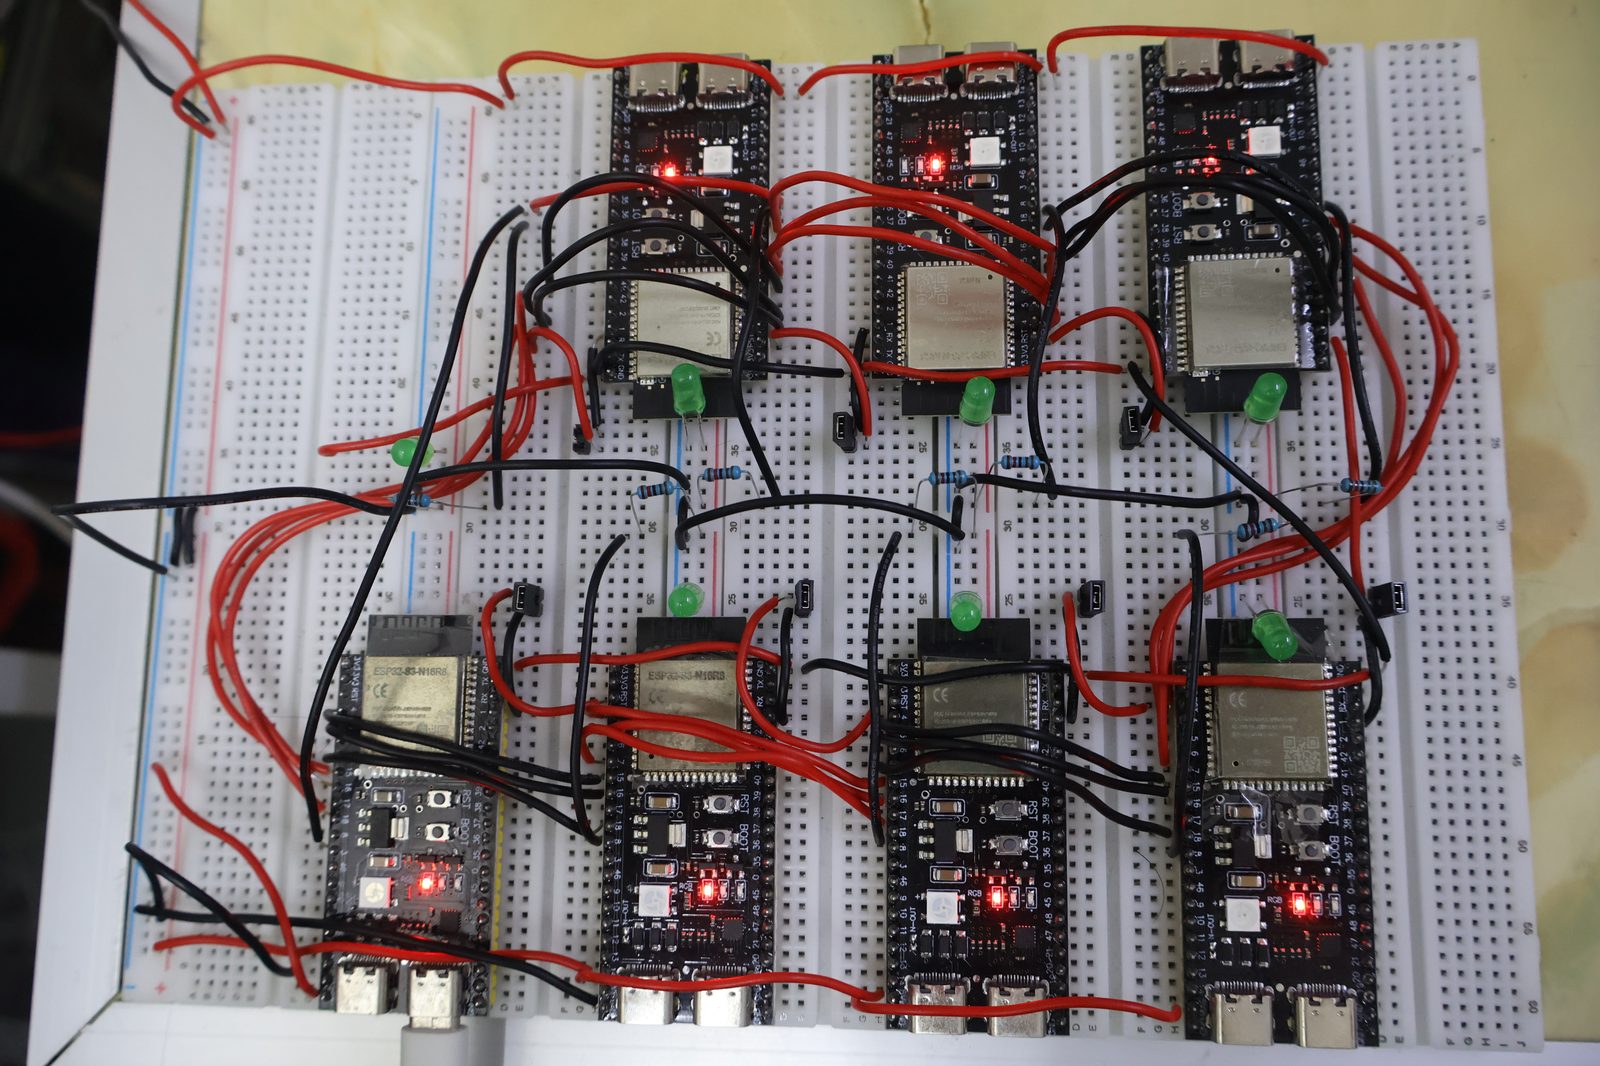
Кожен обчислювальний вузол отримує 4 з 24 блоків трансформера. Плати не спілкуються напряму: вони з'єднані в ланцюжок, тому прихований стан виходить із мастера, по черзі проходить усі вузли й повертається для останнього шару.
1,58 біта на вагу
Усі лінійні шари використовують тернарне квантування у стилі BitNet: вага може набувати лише значень -1, 0 або 1. Три значення вміщуються у два біти, тож в один байт запаковуються чотири ваги, і саме це дозволяє моделі поміститися на таких малих чипах. Таблицю ембедингів зберігають окремо у форматі INT4.
За даними README, один шар займає приблизно 3,82 МБ, а чотири шари на вузлі близько 15,3 МБ, що вміщується в розділ флешпам'яті на 16 МБ. Мастеру потрібно близько 14 МБ під INT4-ембединги та 64 КБ під фінальну норму. Вікно контексту становить 512 токенів, а KV-кеш зберігається в PSRAM кожного вузла.
Ланцюжок SPI
Кожна плата має два канали SPI: один передає (CS 4, MOSI 5, CLK 7), другий приймає (CS 15, MOSI 16, CLK 18). Канал передачі першого вузла з'єднаний із каналом прийому другого, а останній вузол повертає результат мастеру. Окремі лінії відповідають за перезавантаження та готовність: GPIO 1 мастера скидає вузли, а GPIO 3 повертає сигнал із кінця ланцюжка про те, що всі плати піднялися. Світлодіод на GPIO 8 світиться під час роботи.
Живлення та обмеження
За вимірами автора, у простої кластер споживає 5 В і 0,23 А, тобто близько 1,17 Вт, а під час інференсу приблизно 1,53 Вт. Кожному вузлу потрібно близько 1,3 секунди на власну частину обчислень, тому із додаванням плат затримка зростає лінійно: одна ESP32-S3 відповідає за 4 шари.
Проєкт відкрито говорить про слабкі місця. Скрипт квантування навчали лише частково, loss зупиняється близько 8,0, і модель часто видає випадкові токени або повторює одне слово під час greedy-вибірки. README також попереджає: якщо порядок 2-бітного пакування в Python не збігається з розпакуванням у коді C та асемблера, усі ваги тихо псуються. Код поширюється за ліцензією MIT, а серед джерел натхнення вказані Microsoft BitNet і два ранні проєкти на ESP32.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.