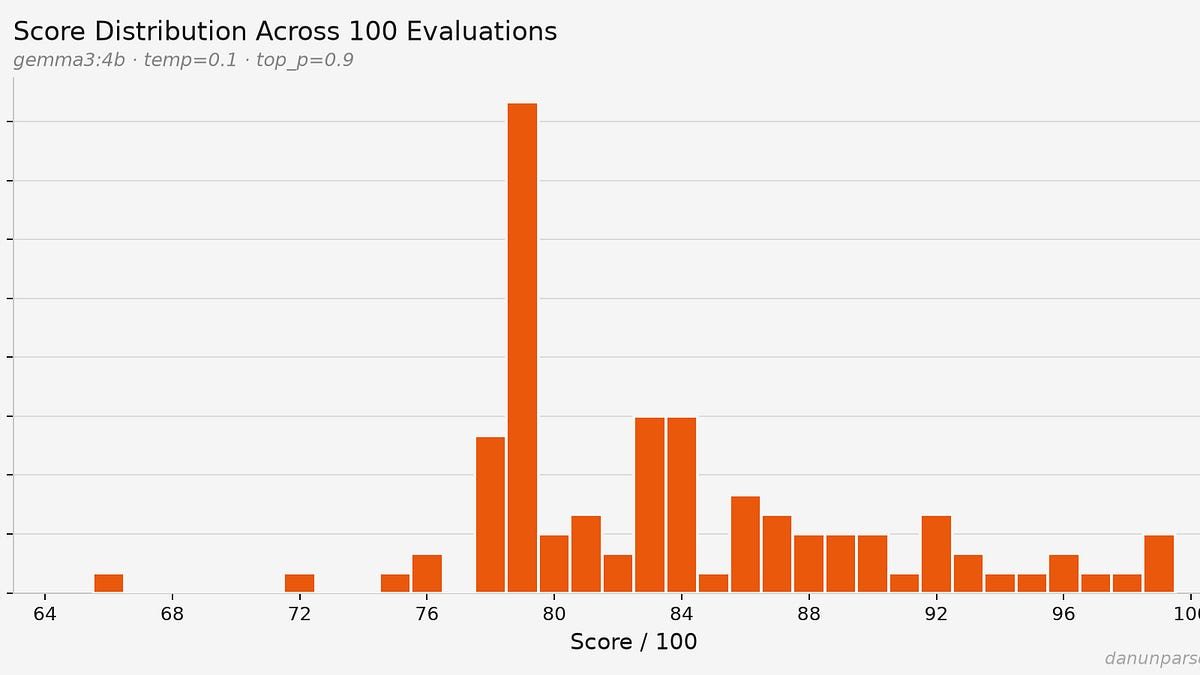
Відкрита ATS від HackerRank оцінила одне резюме від 66 до 99 балів
Розробник запустив відкритий агент HackerRank для найму сто разів на одному резюме й отримав від 66 до 99 балів: технічні навички майже не змінювалися, а оцінки проєктів коливалися дуже сильно.
HackerRank відкрила код своєї системи відбору кандидатів, і розробник, який її протестував, виявив, що те саме резюме отримує від 66 до 99 балів зі 100 залежно від запуску. Проєкт опубліковано на GitHub як interviewstreet/hiring-agent; він поширився через пости в LinkedIn і Reddit, перш ніж автор блогу danunparsed спробував його сам.
Що показав тест
Перший робочий запуск дав резюме автора 90 балів зі 100. Після прибирання відлагоджувальних print-рядків, що лишилися від налаштування, те саме резюме тією ж командою отримало 74. Вимкнення режиму development і запуск інструмента в циклі сто разів дали результати від 66 до 99; якщо межа компанії — 85 балів, те саме резюме провалюється приблизно в 65 випадках зі 100.
Розкид нерівномірний. Технічні навички дали 8 з 10 у 98 запусках зі 100, бо ця категорія — фактично чекліст. Проєкти, що важать 30 балів, коливалися постійно: модель то казала, що проєктам бракує архітектурної складності, то хвалила реальне впровадження. У жовтневому issue на GitHub шість послідовних запусків дали 27, 34, 32, 34, 34 і 30 балів. Досвід роботи вагою 25 балів щоразу повертав 25 з 25, зокрема для старого резюме з однією інтернатурою, бо його підказка складається з двох рядків без критеріїв і прикладів. Як формулює автор: послідовно, але марно.
Як працює оцінювання
Інструмент перетворює PDF-резюме на текст, потім шість разів викликає LLM, щоб витягти структуровані дані — основне, досвід роботи, освіту, навички, проєкти та нагороди — забирає профіль кандидата на GitHub і топові репозиторії як додатковий контекст і передає все це у фінальний оцінювальний запит. Оцінка — зі 100 балів плюс до 20 бонусних: 35 балів за внесок у відкритий код, 30 — за особисті проєкти, 25 — за досвід роботи, 10 — за технічні навички, а також бонуси за досвід у стартапі, портфоліо чи технічний блог. Типова модель — gemma3:4b з температурою 0.1.
Чому це важливо
Перехід на сильнішу модель звузив діапазон, але не розв'язав проблему: Gemini групувала оцінки між 48 і 64, що все одно провалюється в 28 відсотках випадків при межі 60, а запуск Claude Opus 4.8 скоротив розкид лише трохи. Автор доводить, що недетермінованість — це дефект дизайну, а не питання налаштувань, і що оцінювання суджень про якість погано підходить мовним моделям. Правка від 28 червня зазначає, що шаблон оцінювання починається словами Software Intern, проте повторний запуск із явною підказкою про senior-інженера дав ідентичні результати — виміри оцінювання не залежать від посади. Пост також попереджає, що відкритий код і особисті проєкти несуть 65 відсотків ваги, що може відсунути досвідчених інженерів, чия робота ніколи не потрапляла на GitHub.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.