SWE-Serve від NVIDIA показав розрив між локальними тестами та реальним сервінгом
NVIDIA разом із командою SGLang представила бенчмарк SWE-Serve: 83 злиті pull request'и перетворено на 53 завдання. Патчі, що проходять усі інші перевірки, провалюють тести живого сервінгу приблизно в одному випадку з трьох.
Патч агента з написання коду може пройти тести й усе одно зламатися, щойно сервер завантажить реальну модель і почне обробляти запити. Саме цей розрив вимірює SWE-Serve, опублікований NVIDIA 23 вересня. Бенчмарк створено за участі команди SGLang і перетворює 83 злиті pull request'и SGLang на 53 робочі завдання.
Що перевіряє SWE-Serve
Завдання поділено на шість напрямів: спекулятивне та розширене декодування (14), підтримка моделей і бекендів (12), ядра, квантування й продуктивність (8), сервінг-API та коректність під час роботи (8), кешування (7), розподілене виконання та планування (4). Дванадцять завдань працюють на CPU, 41 — на одному NVIDIA H100; перший реліз не оцінює інші inference-рушії, роботу на кількох GPU чи багатовузловий сервінг. Реальний сервер запускають 19 завдань.
Що виявляють тести живого сервінгу
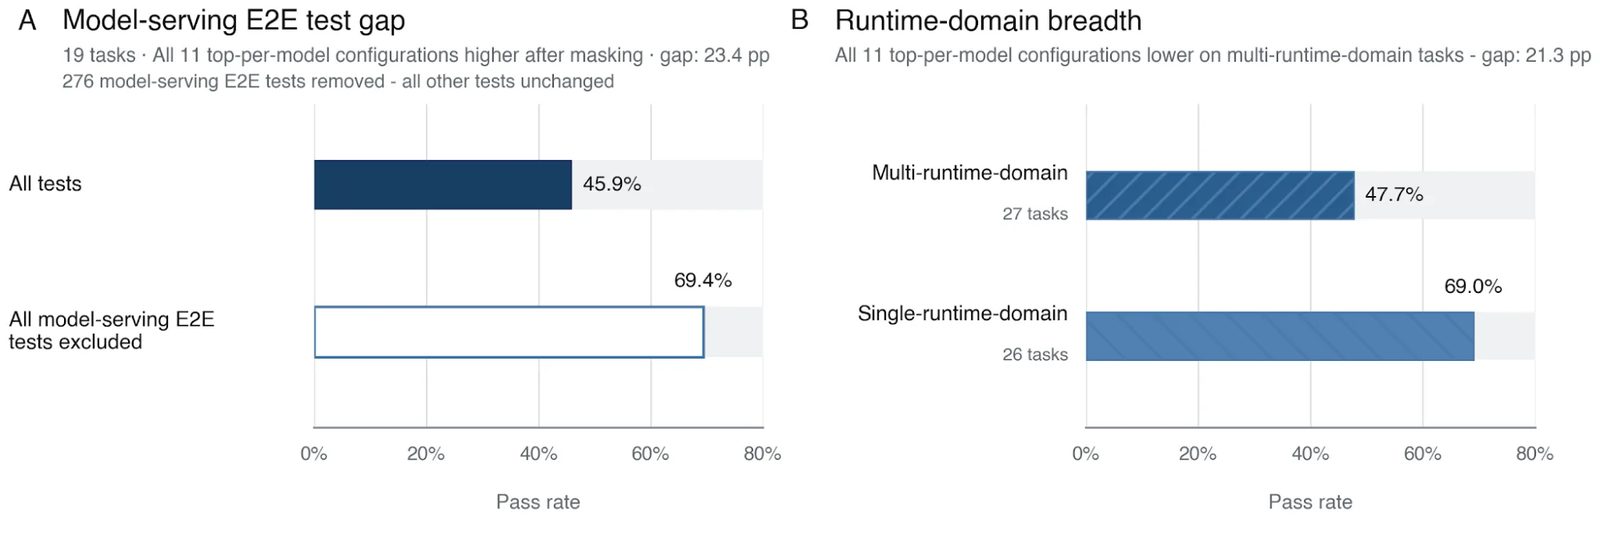
На 19 завданнях із живим сервером ті самі 627 патчів проходять у 45,9% випадків за повного верифікатора. Якщо виключити тести сервінгу, показник зростає до 69,4%: 147 патчів перейшли з невдачі до успіху, а приблизно кожен третій патч, що подолав решту перевірок, не витримує тесту сервінгу. У цих завданнях 276 сервінг-тестів, 242 з них узяті або адаптовані із SGLang. Завдання Gemma 4 MoE показує це наочно: 16 із 33 патчів пройшли всі інші перевірки, але провалили щонайменше один тест живого сервінгу.
Автори наголошують на вузькому значенні успіху: він означає лише, що патч задовольняє верифікатор бенчмарку, а не те, що його можна розгортати, зливати чи що його схвалили супровідники SGLang.
Де агенти втрачають бали
Шлях від запиту до відповіді поділено на чотири домени: обробка запитів та I/O, планування й життєвий цикл запиту, виконання моделі, керування KV-cache і ресурсами. Із 26 завдань у межах одного домену проходять 69,0%, а з 27 завдань, що охоплюють кілька доменів, — 47,7%, тобто розрив у 21,3 відсоткового пункту.
Одинадцять моделей і 31 конфігурацію перевірили через mini-swe-agent, мінімального агента лише з Bash, у закритому режимі. Середній pass@1 коливається від 34,6% до 75,5%. Таблицю очолюють Claude Opus 5 і GPT-5.6 Sol із 75%, але чотири моделі з 64% різко відрізняються за витратами: від $0,95 до $7,24 на завдання, середній час — від 25,5 до 99,9 хвилини.
Для побудови бенчмарку команда переглянула 786 джерел, збудувала 156 кандидатів і прийняла 53; незмінений код мав провалювати тести нової поведінки й водночас проходити регресійні. Під час оцінювання публічна мережа та upstream-репозиторії заблоковані, щоб моделі не могли знайти готові розв'язки.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.