Laya: відкритий рушій рішень, створений за рік до того, як його назвали проривом
Після того як добре профінансована лабораторія представила схожу модель як прорив, інженер випустив Laya — відкриті System 1 моделі рішень, що повертають відкалібровані ймовірності за 32,8 мс.
Інженер, який опублікував неавторегресійні моделі прийняття рішень рік тому, випустив повністю відкриту альтернативу після того, як добре профінансована лабораторія представила схожу архітектуру як новий науковий прорив.
Ідея річної давнини як «прорив»
Нандакішор Муккуннот, засновник і CEO ConvAI Innovations, пише, що створив цей підхід у березні 2025 року: стаття на arXiv про траєкторії послідовної конверсії, ваги моделі та відкритий набір даних на Hugging Face. У вересні 2026 року TypeSafe AI — заснована Діогу Алмейдою, співавтором ChatGPT, — запустила Jev, який автор описує як ту саму концепцію неавторегресійних рішень, але без технічних статей, відкритих ваг і відкритих навчальних даних. Jev семплує паралельно за допомогою того, що називає RLCD (Reinforcement Learning for Calibrated Decisions), і бере 0,042 долара за мільйон вхідних токенів, а типовий час відповіді — близько 150 мс.
Що таке Laya
Замість образи він перебудував ідею як Laya — рушій рішень типу System 1: він не генерує текст, а лише розподіли ймовірностей за структурованими схемами. Модель відповідає на три примітиви: choice, що обирає один ключ зі словника й повертає розподіл та відкалібровану впевненість; score, що ставить документ на порядкову шкалу, наприклад від 0 до 3; і noul — булеве питання, що повертає P(true). Оскільки простір виходу — лише числа, модель не може галюцинувати, а некоректний JSON неможливий, аргументує автор. На бідирекційних енкодерах вона відповідає за 32,8 мс на одному GPU, або 7,2 мс на питання в батчі, що, за даними сторінки, у шість-вісім разів швидше за Jev, з ліцензією Apache 2.0 і без витрат на API.
Три чекпойнти й роутер
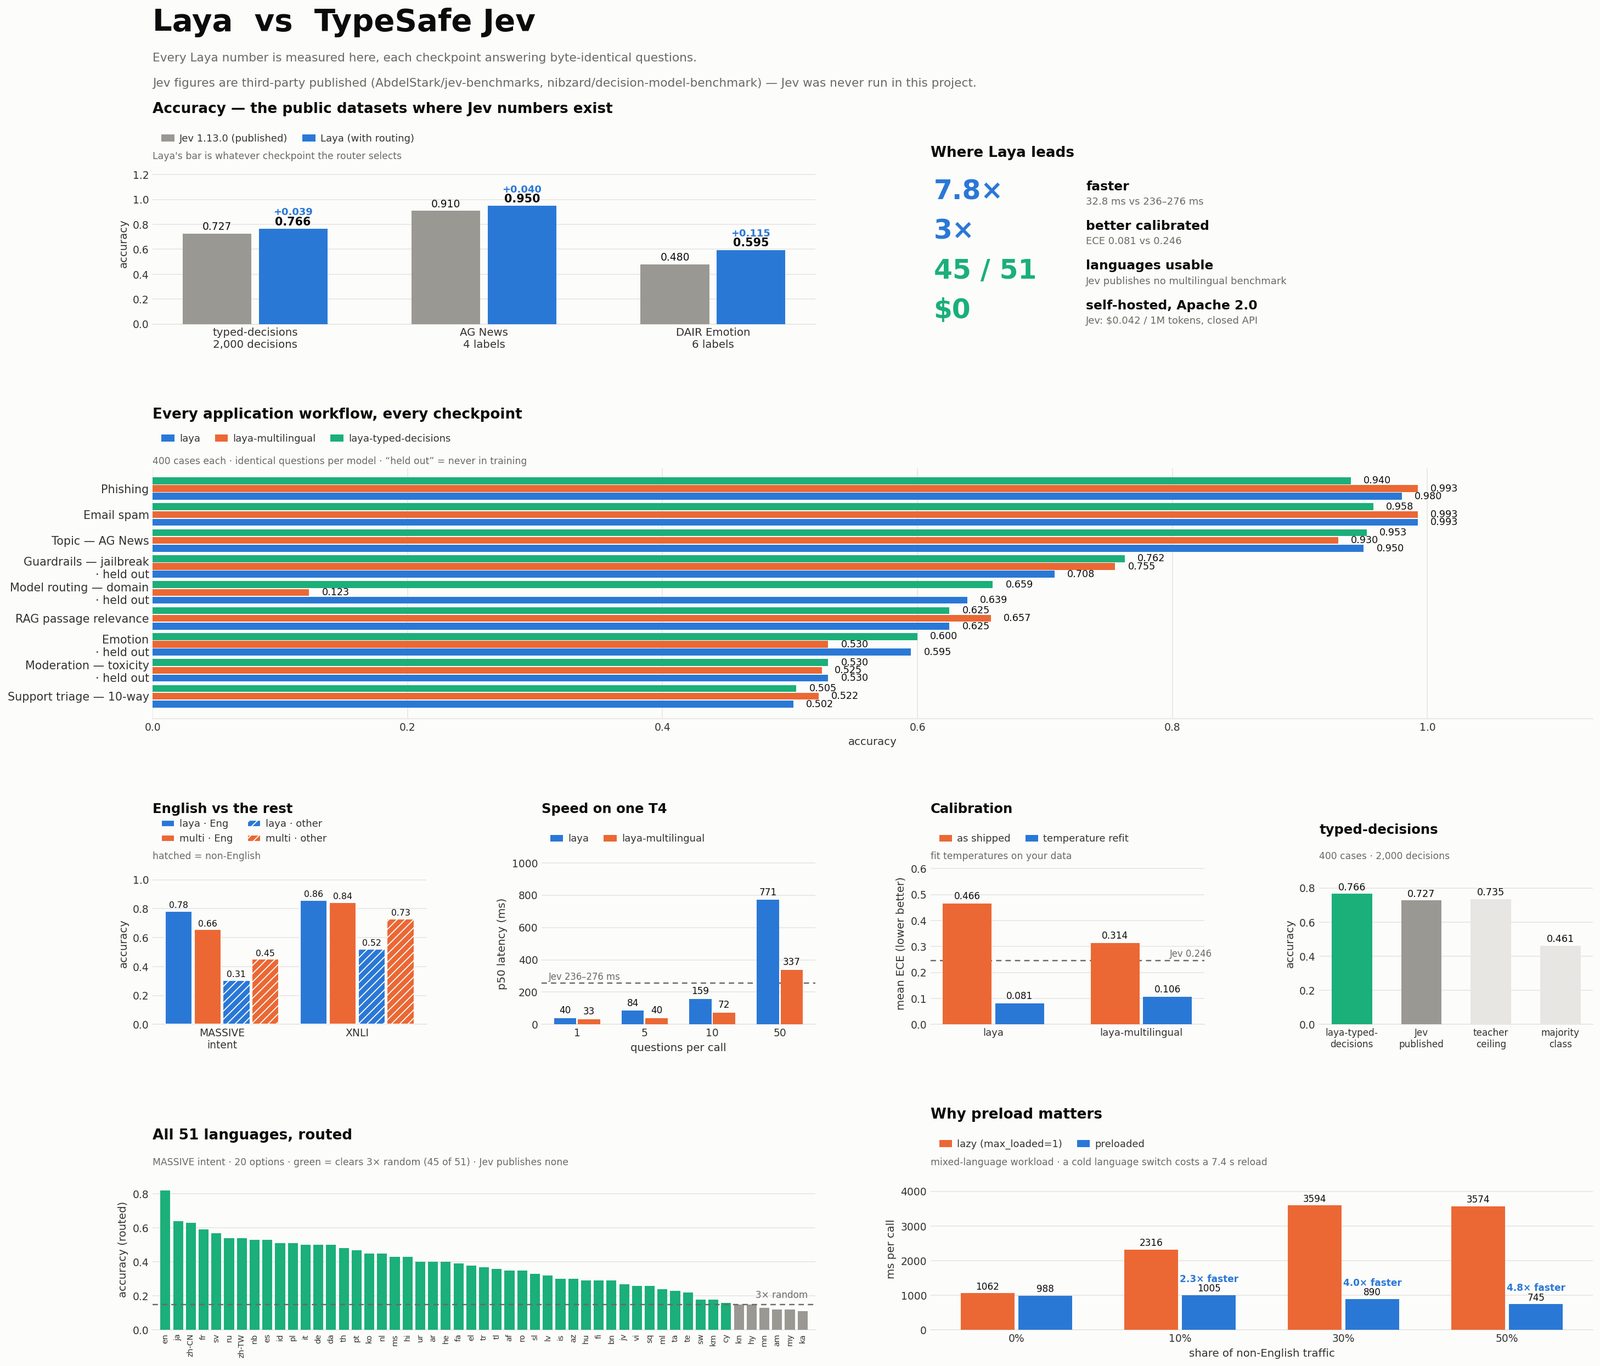
Родина містить три чекпойнти в одному репозиторії Hugging Face: laya (ModernBERT-large, 421 млн параметрів, контекст 512 токенів) для англомовної класифікації та сортування пошти; laya-multilingual (mmBERT-base, словник 256 тисяч токенів, 322 млн параметрів) для понад 100 мов; і laya-typed-decisions для агентних сценаріїв із точністю 0,766. Перевірка на 51 мові в бенчмарку MASSIVE показала, як англомовні моделі руйнуються поза латиницею: на кхмерській модель дала 0,000 точності за середньої впевненості 0,952. Впевненість жодного разу не опускалася нижче 0,885, незалежно від того, чи точність була 82%, чи нуль, тож фільтрувати за впевненістю небезпечно — рішення про маршрутизацію має ухвалюватися до прямого проходу. Роутер Laya перевіряє Unicode-скрипти 22 абеток, додаючи 0,09 мс для англійської, 0,54 мс для індійських писемностей і 0,73 мс для великих вкладених JSON.
Бенчмарки й чесні обмеження
На спільних бенчмарках система з роутингом показує 0,950 проти 0,910 у Jev на AG News і 0,595 проти 0,480 на DAIR Emotion, очікувана похибка калібрування — 0,081 проти 0,246, а медіанна затримка — 32,8 мс проти 236–276 мс. Сторінка також перелічує межі: схеми choice втрачають точність понад 20 варіантів — на Banking77 із 77 мітками Laya отримала 0,425 проти 0,870 у Jev; базові моделі дають близько 0,35 без донавчання; а підбір одного скаляра температури на тип питання знижує похибку калібрування з 0,466 до 0,081.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.