Модель на 125 млн параметрів, яка дописує гру на фортепіано просто на пристрої
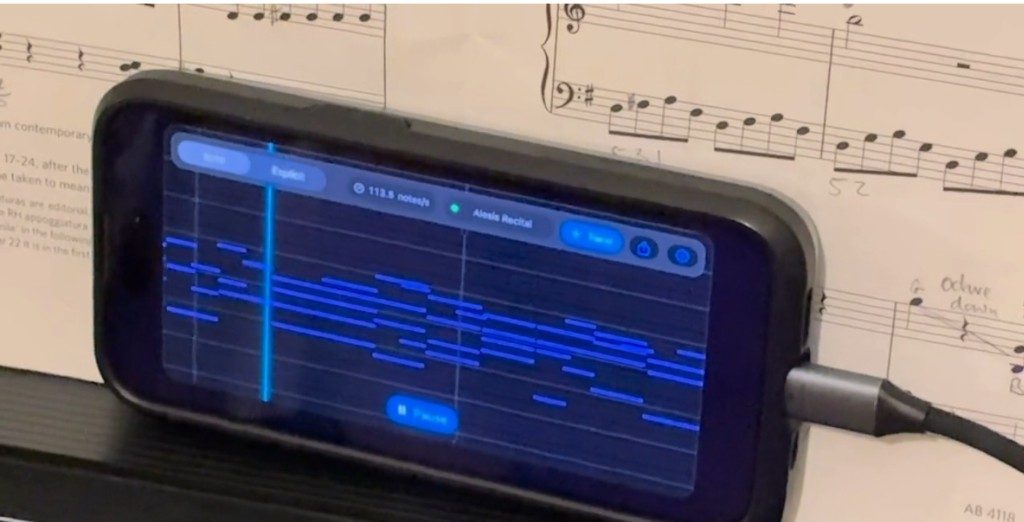
Автор блогу навчив трансформер на 125 мільйонів параметрів, який у реальному часі продовжує MIDI-гру на фортепіано. Модель працює повністю на пристрої — близько 108 нот за секунду на iPhone 15.
Автор блогу під псевдонімом SimEdw навчив трансформер на 125 мільйонів параметрів, який у реальному часі продовжує гру на MIDI-піаніно. Модель працює повністю на пристрої та видає близько 108 нот за секунду на iPhone 15 — цього більш ніж достатньо для живої гри. Застосунок RollTab, побудований на ній, безкоштовно доступний в App Store для власників MIDI-клавіатури та iPhone чи iPad. Проєкт тривав близько року і вимагав 14 експериментів.
Подання нот
MIDI-файл зберігає не записаний звук, а події: натискання клавіші з висотою та динамікою, відпускання, зміну стану педалі. Окремий токен на кожну подію швидко роздуває словник — лише для натискання й відпускання виходить до 16 512 комбінацій, адже 128 висот множаться на 128 значень динаміки.
У фінальному форматі один такт — це один крок: NOTE(pitch, delta_onset, duration, velocity). Окремої події TIME_SHIFT немає: пауза міститься в delta наступної ноти, а акорди — це кілька нот з нульовою delta. Ефект педалі sustain вшито в тривалість ноти ще на етапі підготовки даних, тож модель передбачає лише висоту, початок, тривалість і динаміку. Трансформеру більше не потрібні чотири проходи на одну ноту — він просуває музику цілою нотою за раз.
Дані та навчання
Набір даних налічує кількасот тисяч MIDI-файлів — приблизно 300 мільйонів нотних подій — переважно старої класики із суспільного надбання. Очищення виявилося важливішим за масштаб: автор відібрав фортепіанний матеріал, відфільтрував його за щільністю, виконав дедуплікацію за відбитками, які ігнорують транспозицію та темп, і зібрав альтернативні версії одного твору в один розділ. Збільшення набору приблизно вп’ятеро погіршило результати.
Навчання — це крос-ентропія за п’ятьма головами (тип, висота, delta, тривалість, динаміка). Заплановане семплювання, коли модель під час навчання іноді спирається на власний прогноз, погіршило валідаційну втрату (2.9998 проти 2.9495), але покращило продовження: у попарних порівняннях від Gemini 3.5 Flash таку модель обирали в 64,3% випадків. На цих перевагах потім провели донавчання через DPO.
На пристрої та обмеження
Архітектура — стандартний декодерний трансформер: RMSNorm, роторні позиційні ембединги, причинна self-attention і блоки SwiGLU. Навчено три розміри — приблизно 33, 64 і 125 мільйонів параметрів; інференс через Core ML відбувається повністю на пристрої.
Автор відкрито називає недоліки: модель іноді зациклюється, а короткі промпти залишаються складними. За його словами, це «GPT-2, але для фортепіано».
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.