44% на ARC-AGI-1 за 67 центів: малий трансформер, навчений за 1,5 години
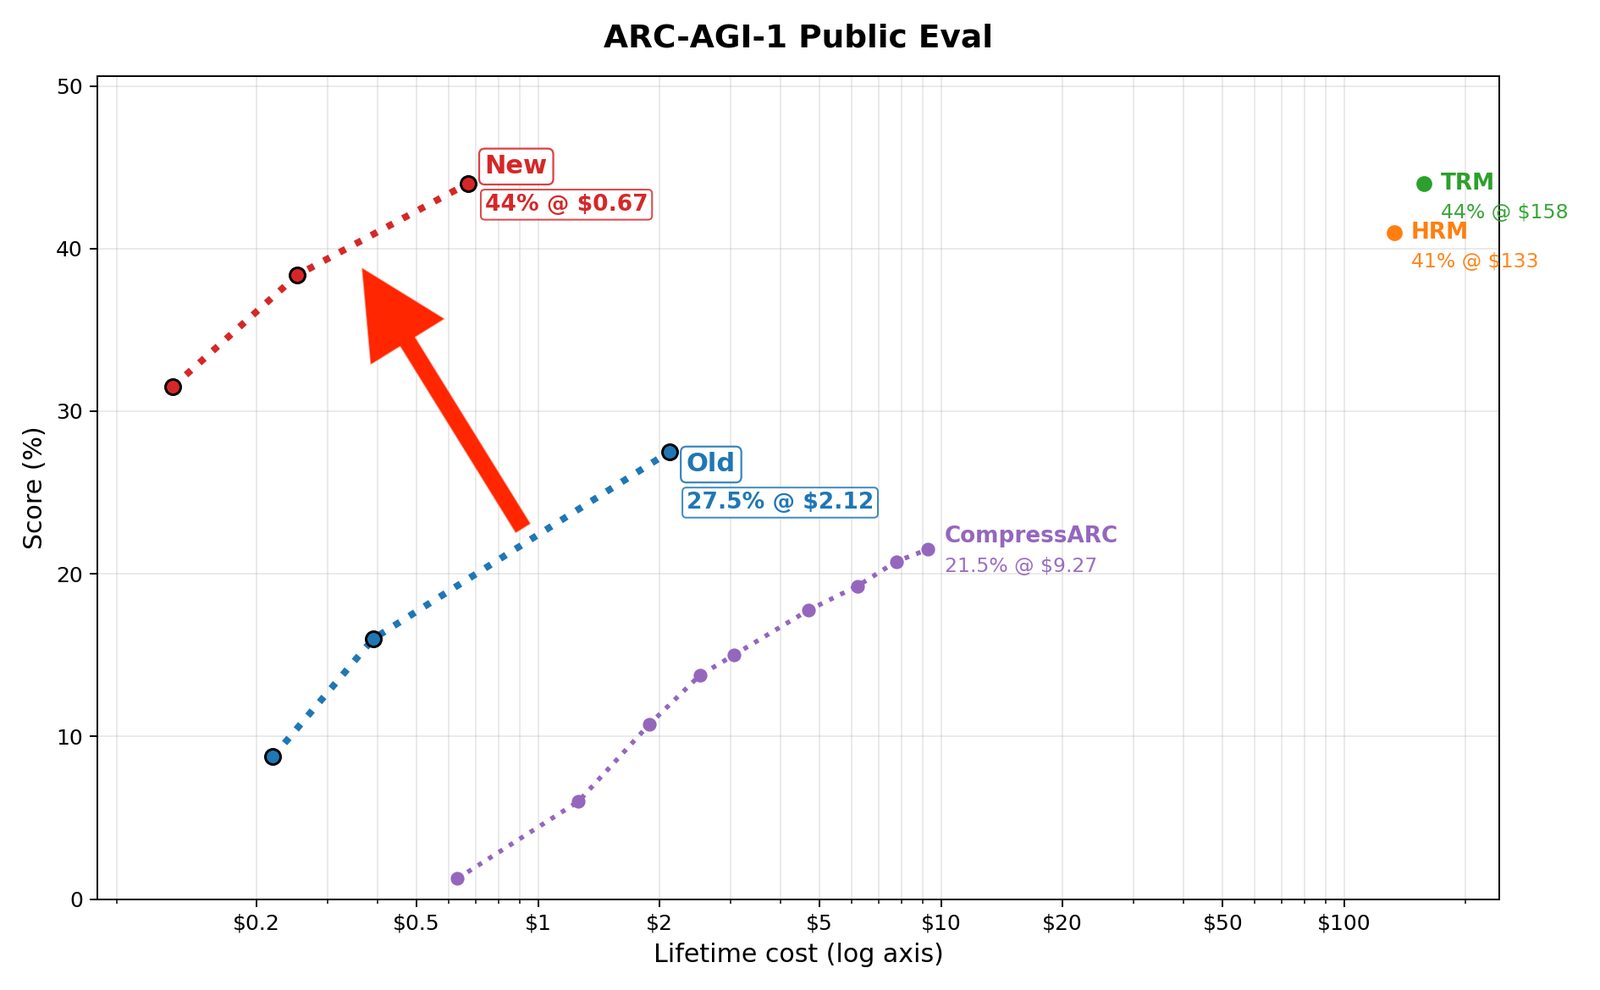
Мітіл Вакде навчив невеликий трансформер з нуля на одній RTX 5090 приблизно за 1,5 години. Він показує 44% на публічному наборі ARC-AGI-1, а вся вартість обчислень — 67 центів.
Дослідник Мітіл Вакде опублікував третій матеріал у своїй серії про ARC-AGI. Цього разу він навчив невеликий трансформер з нуля, який показує 44% на публічному оцінювальному наборі ARC-AGI-1 і 7% на ARC-AGI-2. За словами автора, повна вартість обчислень за весь життєвий цикл — навчання від ініціалізації плюс інференс на всіх завданнях — становить 67 центів.
Запуск триває близько 1,5 години на одній відеокарті RTX 5090, а результат збігається з оцінками TRM і HRM — тих моделей, з якими він тепер порівнюється. Вакде наголошує, що порівнює лише підходи з подібним навчанням під час тестування. Код відкритий.
Як працює підхід
Кожна пара «вхід — вихід» у головоломці перетворюється на послідовність токенів, і невеликий трансформер авторегресивно навчається на цих послідовностях просто під час тестування — на головоломках бенчмарку, при цьому правильні тестові відповіді приховані. Для перенесення знань між завданнями кожна головоломка отримує власний навчений адитивний ембединг, а позиційну інформацію обробляють 3D RoPE-ембединги, адже кожна послідовність містить дві 2D-сітки.
Навчальні дані доповнюються кольоровими та дієдральними перестановками. Під час інференсу тестові входи теж доповнюються, до отриманих відповідей застосовують зворотне перетворення, а на фінал подають дві найчастіші відповіді.
Що змінилося порівняно з попередньою версією
Найбільший приріст дала модернізована архітектура — SwiGLU замість GELU та RMSNorm замість LayerNorm, — а також різноманітніші й краще перемішані дані та масштабування з 4 до 8 шарів. Витрати впали завдяки значно меншій кількості аугментацій, переходу від оптимізатора AdamW-only до NorMuon з допоміжним AdamW і застосуванню flash attention на упакованих послідовностях змінної довжини.
Чому це важливо
Вакде називає ефективність за вибіркою (sample efficiency) найважливішою невирішеною проблемою ШІ, а ARC — зручним полігоном: близько 1000 головоломок, кожна з власним правилом, і мінімум апріорних знань. Його мета — з'ясувати межі сучасних методів глибокого навчання та зробити ітерації настільки дешевими, щоб над проблемою міг працювати будь-хто у світі.
Абляційний аналіз показав, що значна частина результату зберігається навіть без аугментацій і синтетичних даних, а об'єднання розв'язаних завдань із кількох запусків сягає 55%. Автор вважає, що 65% досяжні в межах звичайного трансформера, а ще десятикратне скорочення витрат можливе з написаними вручну GPU-ядрами.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.