Jeff: сумісні з Jev моделі на 0,8B ухвалюють рішення за 22 мс на одному GPU
Відкритий проєкт Jeff навчає малі моделі Qwen3.5 і Gemma 4 повертати за одну пряму передачу відкалібровану ймовірність для кожного варіанта: близько 22 мс на рішення.
На GitHub з'явився відкритий проєкт Jeff: він перетворює невеликі моделі Qwen3.5 і Gemma 4 на 0,8B та 2B параметрів на класифікатори, що використовують той самий формат запиту, що й Jev. Користувач описує ситуацію й перелічує варіанти простими словами, а модель повертає відкалібровану ймовірність для кожного варіанта за одну пряму передачу. Текст не генерується, тому розбирати відповідь не потрібно. Рішення ухвалюється приблизно за 22 мс на NVIDIA RTX PRO 6000 і за 28 мс на Apple M4 Max через MLX.
Що таке Jeff
Режим zero-shot означає, що варіанти можуть бути будь-якими: черги підтримки, наміри користувачів, мітки модерації чи ходи в грі. Категорії не мусять бути присутні в навчальних даних, бо їх описують у запиті. На Hugging Face опубліковано три моделі: Jeff-Qwen3.5-0.8B, Jeff-Qwen3.5-2B і Jeff-Gemma4-E2B. Один запит може містити три типи питань: вибір до 255 варіантів, відповідь «так/ні» у вигляді ймовірності та оцінка за описаною шкалою.
Результати бенчмарків
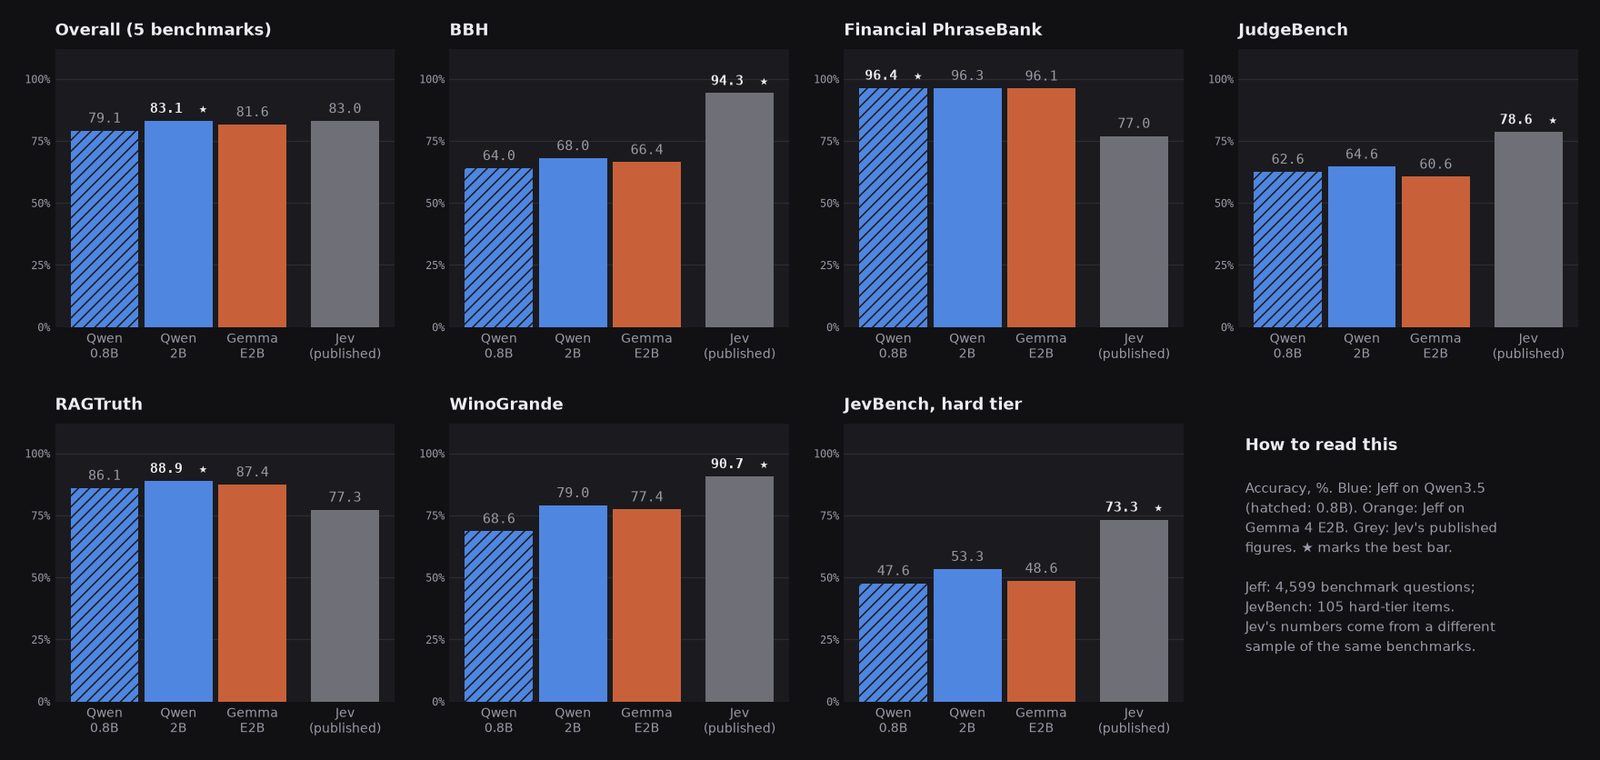
Автори перевірили моделі на 4 599 питаннях із п'яти публічних бенчмарків, а також окремо на складному рівні JevBench із 105 завдань. За загальним балом Jeff-Qwen3.5-2B досягає 83,1, Jeff-Gemma4-E2B — 81,6, а Jeff-Qwen3.5-0.8B — 79,1, тоді як опублікований результат Jev становить 83,0. На Financial PhraseBank малі моделі піднімаються до 96,4 проти 77,0, натомість на тестах із міркувань вони відстають: BBH — 64,0 проти 94,3. Автори пишуть, що загальний бал дають завдання класифікації, де малі моделі не поступаються великим.
Навчання на локальному обладнанні
Проєкт створено на локальній техніці: модель 0,8B навчається приблизно дві години на одному робочому GPU RTX PRO 6000, 2B — близько трьох із половиною. Синтетичні навчальні дані написала відкрита модель Qwen3.8-Flash-Next на двох DGX Spark, тестування відбувалося на MacBook. Хмарні GPU не використовували, і результати закритих моделей у навчальні дані не потрапили. Jeff — незалежний проєкт, не пов'язаний із TypeSafe, творцем Jev. Код поширюється за ліцензією MIT, а ваги — за Apache 2.0.
Ігри та обмеження
Для перевірки zero-shot автори дали Jeff зіграти в три гри, де кожен хід описували словами: 6,55 убивств у Doom, як і в бота з написаних вручну правил, 10,3 переправи у Frogger проти 1,0 у ненавченої моделі та 57,0 з 98 кульок у Pac-Man проти 25,8, з рішенням за 29-49 мс на хід на M4 Max. Серед обмежень: малі моделі не міркують, працюють лише з англійським текстом, а 2B грає гірше за 0,8B. Коротке донавчання на власних прикладах дає багато: версія для голосової навігації на 11 тисячах прикладів підняла точність із 31,7% до 95,8% менш ніж за пів години на одному GPU.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.