LensVLM-9B від Apple читає документи як стиснені зображення та розгортає лише потрібні сторінки
Apple опублікувала LensVLM-9B — мовно-візуальну модель із 9 мільярдів параметрів, яка читає документи як стиснені зображення сторінок і розгортає лише ті сторінки, які їй потрібні.
Apple опублікувала LensVLM-9B — мовно-візуальну модель із 9 мільярдів параметрів, яка читає документи як стиснені зображення сторінок і розгортає лише ті сторінки, які їй потрібні. Картку моделі викладено на Hugging Face разом з репозиторієм коду та статтею, опублікованою на arXiv 7 травня 2026 року.
Як це працює
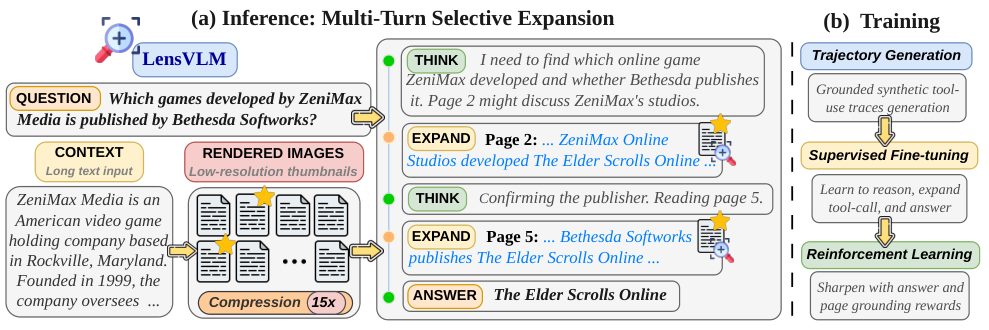
Мовно-візуальні моделі можуть читати текст, відрендерений у зображення, замість токенізації у довгі послідовності: енкодер перетворює зображення фіксованого розміру на фіксовану кількість візуальних токенів, тож роздільна здатність рендерингу працює як точний регулятор стиснення. Проблема в тому, що зі зростанням стиснення точність швидко падає — символи стають меншими за ефективну роздільну здатність енкодера, і модель перестає їх розрізняти.
LensVLM — це метод післянавчання та інференс-фреймворк, що обходять це обмеження. Модель сканує документ, відрендерений у стисненому вигляді (режими 5x, 10x і 15x), після чого навченими інструментами, як-от read_page, крок за кроком відновлює лише потрібні сторінки в нестисненому вигляді. Apple навчала модель у три етапи: фільтрація складних прикладів, синтетичні траєкторії роботи з інструментами для SFT і навчання з підкріпленням (RL). LensVLM-9B побудовано на Qwen3.5-9B-Base.
Що показують цифри
За даними статті, при 4,3x ефективного стиснення LensVLM зберігає точність, порівнянну з верхньою межею повного тексту, а на семи текстових QA-бенчмарках перевершує методи на основі пошуку, текстового та візуального стиснення аж до 10,1x. Модель також переноситься на мультимодальне розуміння документів і коду, а перевага над базовими методами зростає разом зі стисненням.
Аналіз пояснює чому: після навчання візуальне стиснення стає стійким до вибору параметрів рендерингу, а на високих коефіцієнтах модель більше покладається на розгорнутий вміст, а не на читання зменшених пікселів. Автори додають практичну пораду: для відрендерованого тексту краще розгортати текст, а для документів, де макет несе важливу для завдання інформацію, — зображення у високій роздільній здатності.
Демо та реліз
Демо коротке: модель сканує 15 стиснених зображень сторінок, визначає, що релевантною є сторінка 10, читає її інструментом read_page і за два кроки пов'язує Shirley Temple, Corliss Archer і Chief of Protocol. Репозиторій також містить підготовку даних для HotpotQA, NQ та Musique і код оцінювання.
Ваги випущено за ліцензією Apple Machine Learning Research Model License, а код — за Apple Sample Code License. Hugging Face вказує 9B параметрів у BF16, 233 завантаження за минулий місяць і дві квантовані версії спільноти.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.