SiTech AI Team2 წთ. საკითხავი
Обрізання LLM по-фізичному: видалення блоків як задача оптимізації Ізінга
Нова стаття Multiverse Computing переформульовує вибір блоків трансформера як обмежену бінарну оптимізацію, що зводиться до скла Ізінга, і за глибокого стиснення випереджає найсильніший базовий метод майже на 23 пункти MMLU.
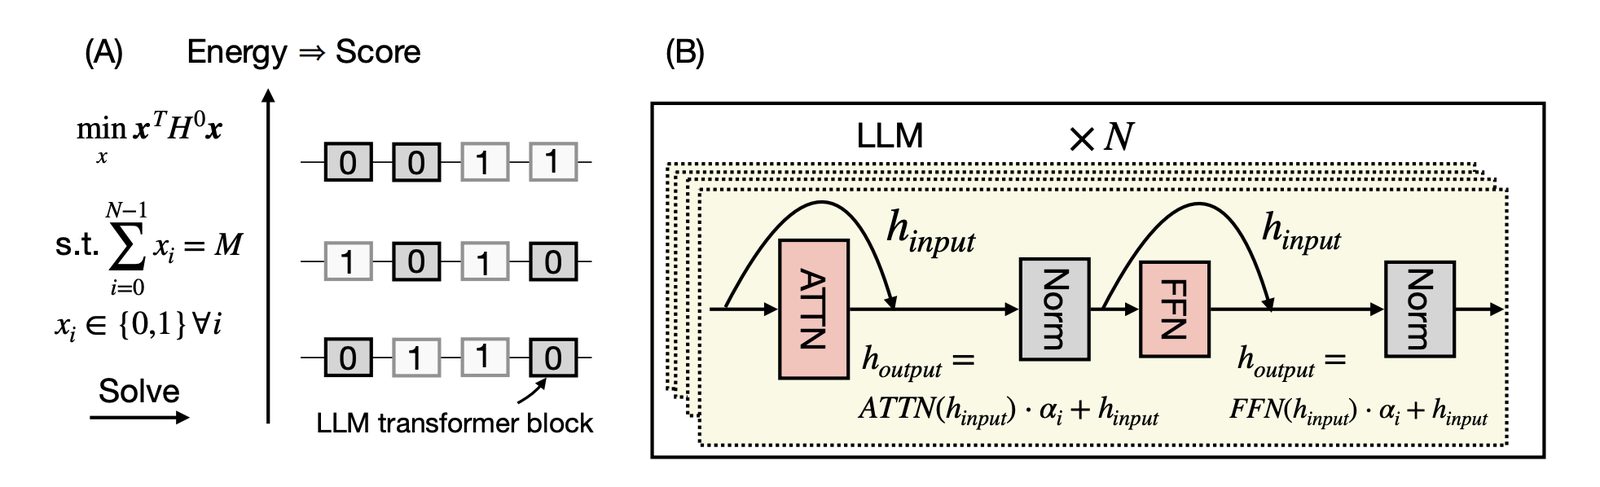
Видалення цілих блоків трансформера — дешевий спосіб прискорити велику мовну модель: модель буквально коротшає, тож block removal (depth pruning) дає передбачуване прискорення інференсу поверх економії пам'яті та добре поєднується з квантуванням. Складність у тому, які блоки різати: ефект від видалення одного блоку залежить від того, які інші блоки видалили разом із ним. У роботі LLM Compression by Block Removal with Constrained Binary Optimization (блог Hugging Face, 21 вересня 2026 року) вибір блоків переформульовано як обмежену бінарну оптимізацію (CBO), що відображається на скло Ізінга; його енергія — дешевий показник якості моделі.
 Матрицю Гессе обчислюють лише раз, із прямого та зворотного проходів на невеликому калібрувальному наборі даних; далі будь-яку конфігурацію оцінюють одним дешевим розрахунком енергії, без запуску моделі. Одна матриця обслуговує багато значень M.
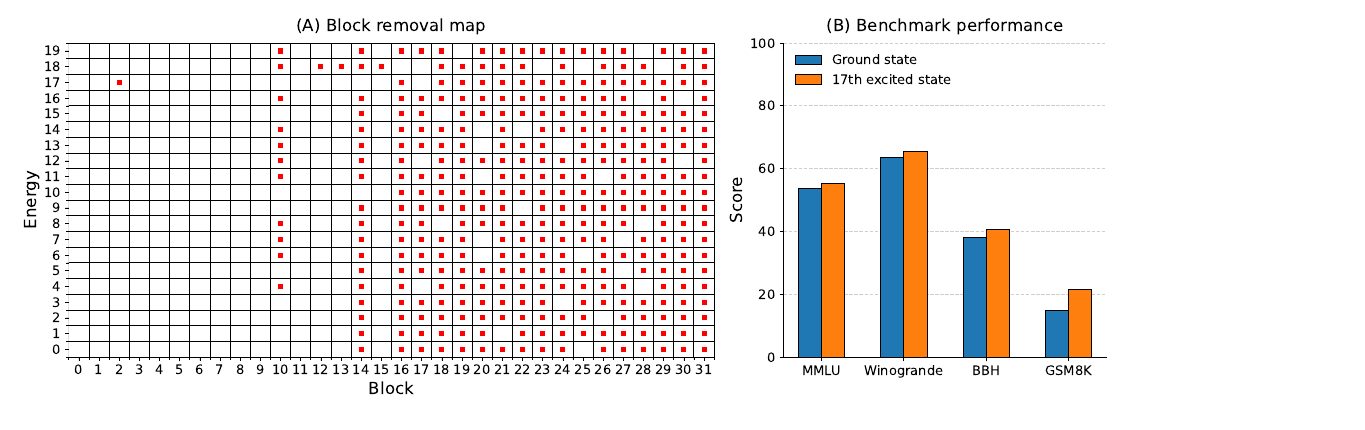 Для Llama-3.1-8B-Instruct із 16 видаленими блоками з 32 17-й збуджений стан першим пропонує видалити блок на початку моделі й після легкого перенавчання перевершує основний стан. Без перенавчання Llama-3.3-70B-Instruct сягає 76,6 і 76,9 MMLU за 32 і 40 видалених блоків із 80 проти 59,3 і 54,0 у block influence; Qwen3-14B за 12 із 40 має перевагу близько 10 пунктів. Метод переноситься і на гібридну модель NVIDIA-Nemotron-3-Nano-30B-A3B-FP8, перевершуючи block influence на AIME25 і GPQA. Код відкритий.
Чому блоки не незалежні
Наявні методи оцінюють кожен блок окремо — за величиною, чутливістю чи евристикою block influence — і видаляють найменш важливі: це наближення середнього поля, яке вважає внесок блоку незалежним від інших. Насправді видалення 20-го блоку шкодить лише тоді, коли разом із ним прибрали 19-й або 24-й, а кількість комбінацій зростає експоненційно.Від вибору блоків до мінімізації енергії
Кожному блоку приписують бінарну змінну: 0 — залишити, 1 — видалити. Розклад функції втрат у ряд Тейлора другого порядку дає наближену матрицю Гессе: діагональ показує важливість кожного блоку окремо, а позадіагональні елементи — парні зв'язки, які методи середнього поля ігнорують. Задача — знайти M блоків із N, видалення яких мінімізує енергію.
Матрицю Гессе обчислюють лише раз, із прямого та зворотного проходів на невеликому калібрувальному наборі даних; далі будь-яку конфігурацію оцінюють одним дешевим розрахунком енергії, без запуску моделі. Одна матриця обслуговує багато значень M.
Рішачі, спектр і результати
На одному GPU автори перебирають десятки мільярдів конфігурацій; найважчий доступний випадок — 8 із 80 блоків Llama-3.3-70B (близько 29 мільярдів конфігурацій) — зайняв приблизно два дні. Далі задача у формі QUBO переходить до класичних, квантових і квантово-інспірованих рішачів — відпалювання, QAOA, tabu search, branch-and-bound; відкритий tabu-рішач досягає найнижчих енергій за секунди. Справжній основний стан не потрібен: достатньо кількох хороших низькоенергетичних станів.
Для Llama-3.1-8B-Instruct із 16 видаленими блоками з 32 17-й збуджений стан першим пропонує видалити блок на початку моделі й після легкого перенавчання перевершує основний стан. Без перенавчання Llama-3.3-70B-Instruct сягає 76,6 і 76,9 MMLU за 32 і 40 видалених блоків із 80 проти 59,3 і 54,0 у block influence; Qwen3-14B за 12 із 40 має перевагу близько 10 пунктів. Метод переноситься і на гібридну модель NVIDIA-Nemotron-3-Nano-30B-A3B-FP8, перевершуючи block influence на AIME25 і GPQA. Код відкритий.
Поділитися цифровим досвідом
SSiTech
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.