Qwen 3.8 27B: чудовий у 17 ГБ, але за замовчуванням надто довго «думає»
Лабораторія Qwen від Alibaba випустила 27-мільярдну модель із підтримкою зору під ліцензією Apache 2.0. Вона працює на звичайному обладнанні, проте стандартний параметр reasoning витрачає зайві ресурси.
14 серпня дослідницька лабораторія Qwen компанії Alibaba опублікувала Qwen 3.8 27B — мовну модель на 27 мільярдів параметрів із підтримкою зору, випущену під ліцензією Apache 2.0. Ваги доступні на Hugging Face, а запускати модель локально можна через LM Studio або llama.cpp.
Показники та перші враження
Заявлені самою Qwen результати помітно випереджають попередника Qwen 3.6 27B і навіть закритий Qwen 3.7-Plus — модель, яка ще в травні була однією з найсильніших у лінійці Qwen незалежно від розміру. Незалежних оцінок поки немає. Розробник Саймон Віллісон, який тестував модель на MacBook Pro M5 Max зі 128 ГБ пам'яті та на NVIDIA DGX Spark, назвав 27B чудовим розміром для запуску потужної моделі на звичайному ноутбуці.
Надмірні роздуми за замовчуванням
Модель має параметр reasoning_effort, стандартне значення якого — «xhigh», і збірка GGUF у LM Studio його зберігає. На практиці навіть найпростіші запити з'їдають тисячі токенів міркувань: стандартний контекст LM Studio у 8 192 токени швидко вичерпувався, і проблема зникла лише після завантаження повного контексту на 262 144 токени.
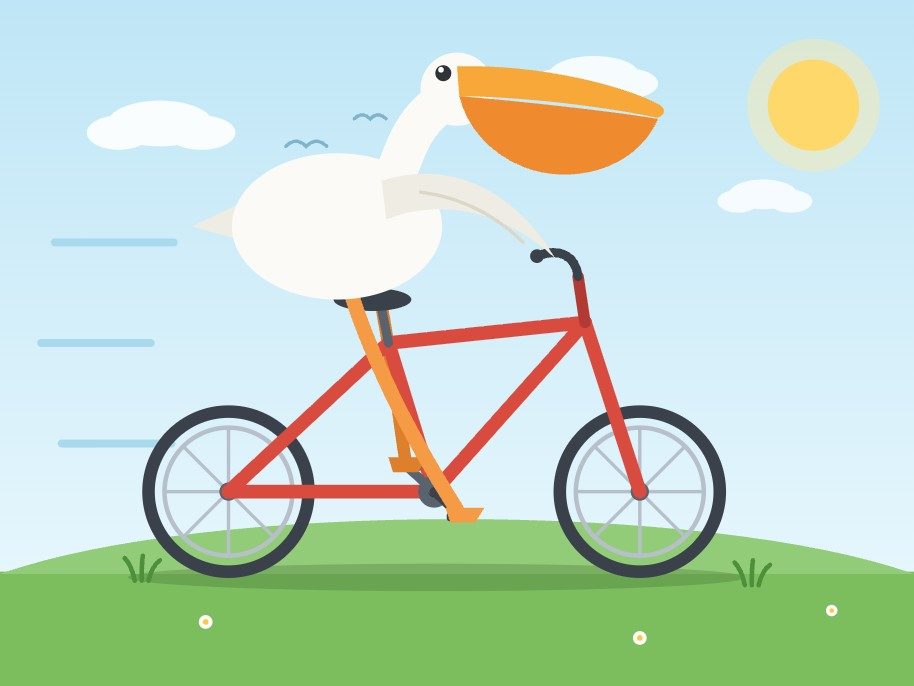
У тесті моделі знадобилося 21 хвилина та 22 276 токенів міркувань, щоб видати 3 223 токени SVG — пелікана на велосипеді. З вимкненим режимом міркувань той самий запит завершився за 137 секунд і 3 715 токенів. На просте прохання «намалюй SVG кола» модель відповіла складною анімованою композицією. Практична порада автора — спершу запускати модель на низькому рівні міркувань або зовсім без них.
Зір, інструменти та швидкість
Модель виявилася сильною у візуальному розпізнаванні: на запит повернути JSON-рамки в масштабі 0–1000 для пеліканів на фотографії вона видала координати, що точно збіглися з об'єктами. За одним запитом вона також зібрала невеликий HTML-інструмент для нанесення таких рамок на зображення, який працює повністю офлайн; результат вийшов надмірно складним, але робочим.
Головний недолік — швидкість. LM Studio видавав приблизно 15–30 токенів за секунду, тоді як, за вимірюваннями Artificial Analysis, хмарні OpenAI 5.6 Sol та 5.6 Luna показують 74 і 184 токени за секунду. Часткове рішення вже є: Qwen підтримує Multi-Token Prediction, і сервер llama.cpp із режимом спекулятивного декодування draft-mtp випередив стандартну збірку LM Studio приблизно на 72% у тесті на DGX Spark.
Головний висновок — у тому, що демонструє файл на 17 ГБ: довгий контекст, виклик інструментів, зір і цілком придатну генерацію коду на обладнанні, яке вже є в розробника. Відкритим залишається питання, чи наздожене ці можливості швидкість інференсу.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.