Qwen3.8-Flash-Next: команда Qwen показала архітектуру, що ляже в основу Qwen4
Команда Qwen опублікувала Qwen3.8-Flash-Next — модель із відкритими вагами на 125 млрд параметрів, з яких активні лише 6 млрд, гібридною увагою та контекстом у 262 144 токени.
Команда Qwen від Alibaba 26 серпня опублікувала Qwen3.8-Flash-Next — експериментальну модель з відкритими вагами, яка, за словами компанії, задає архітектуру для Qwen4. Ваги викладено на Hugging Face під ліцензією qwen-community-1.0; вони сумісні з Transformers, vLLM, SGLang і TokenSpeed.
Гібридна увага та QSA
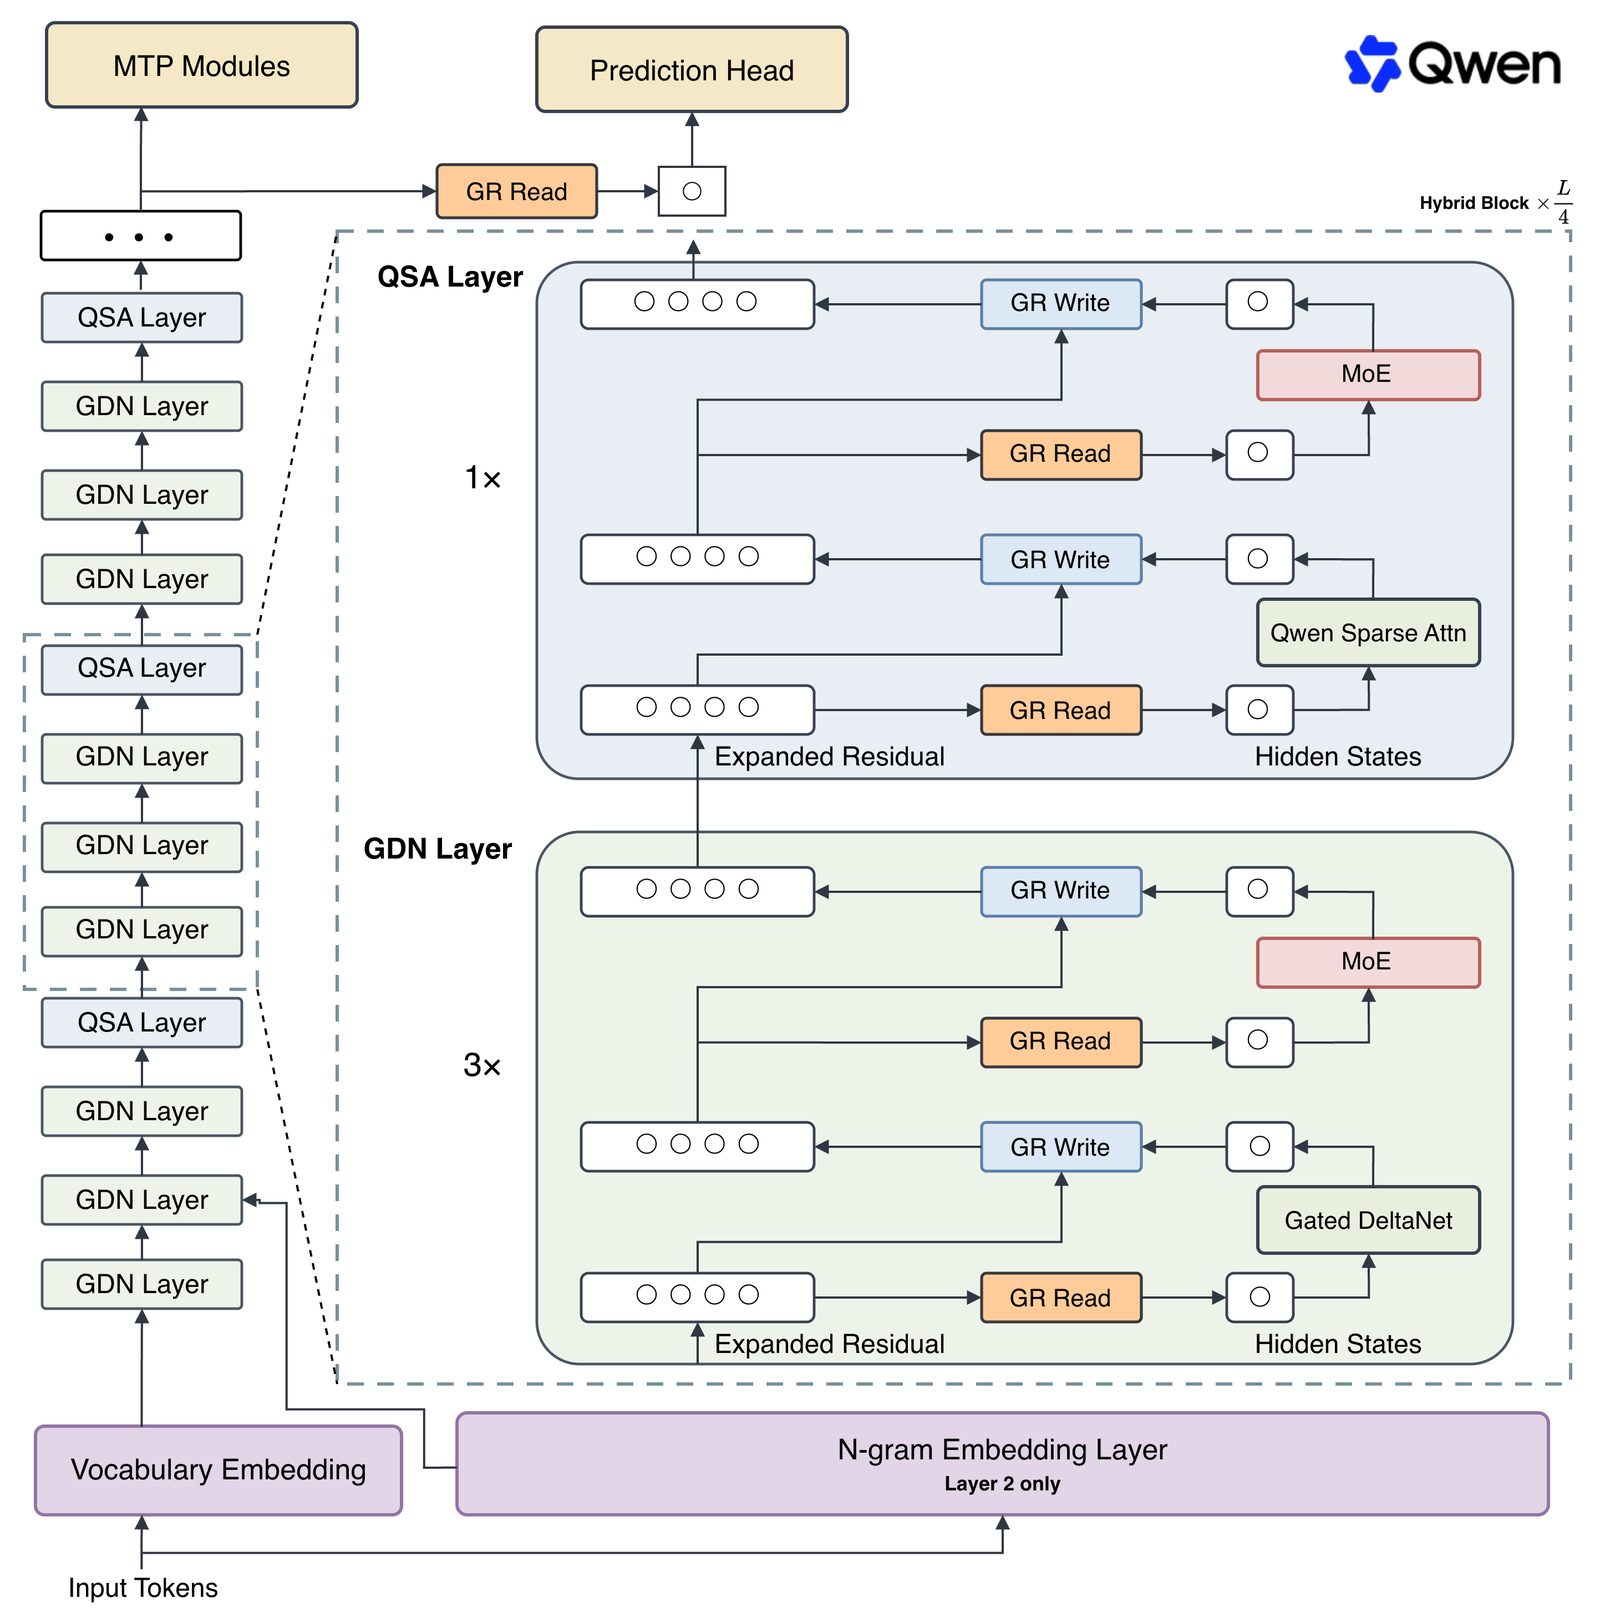
Головна зміна — архітектурна: пару Gated DeltaNet і Gated Attention переробили на Gated DeltaNet та Qwen Sparse Attention (QSA). Замість вибору окремих токенів QSA працює на рівні мікроблоків, що суттєво знижує затримку на довгих контекстах — критично важливо для агентних навантажень, які дедалі частіше домінують у реальному використанні.
Gated Residual і n-gram-вбудовування
Gated Residual регулює потік інформації у розширених residual-потоках: поелементний шлюз читання, що залежить від даних, і скалярний шлюз запису для кожної гілки зберігають стабільність навчання й додають виразності. N-gram-вбудовування дає окрему вісь масштабування параметрів: воно потребує менше обчислень, ніж mixture-of-experts, і легше виноситься на зовнішню пам'ять, що допомагає на прискорювачах з обмеженою пам'яттю.
Масштаб і результати тестів
Модель має 125 мільярдів параметрів, з яких одночасно активні лише 6 мільярдів, плюс 51 мільярд параметрів n-gram-вбудовування та 4 мільярди параметрів MTP. Це 48 шарів і 512 експертів (10 маршрутизованих і один спільний). Контекстне вікно — 262 144 токени, розширюване до мільйона. У опублікованих результатах Qwen3.8-Flash-Next отримує 62,5 бала на SWE-bench Pro, 58,7 на DeepSWE 1.1, 81,0 на SWE-bench Multilingual, 48,1 на NL2Repo-Bench і 73,9 на CoWorkBench.
Що це означає для розробників
Щодо навчання Qwen зазначає, що оптимізатори Muon і AdamW застосовуються до конкретних категорій ваг, а традиційне розігрівання розміру батчу скасовано — навчання стартує одразу з цільового розміру. Продакшн-версія Qwen3.8-Flash працює у хмарі з контекстом на мільйон токенів за замовчуванням і вбудованими інструментами, тоді як відкриті ваги залишаються для самостійного розгортання. Технічний звіт опубліковано в репозиторії Qwen на GitHub.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.