AWS прискорила RL-навчання MoE-моделей на EKS з EFA і DeepEP: пропускна здатність на 40% вища
AWS опублікувала референсну архітектуру для великомасштабного RL-доучування MoE-моделей на Amazon EKS з EFA та DeepEP. На 48 інстансах P5en вмикання DeepEP поверх EFA підвищило пропускну здатність rollout на 40 відсотків.
AWS опублікувала референсну архітектуру для великомасштабного RL-доучування моделей Mixture-of-Experts (MoE) на Amazon EKS з EFA та DeepEP. Публікація AWS Machine Learning Blog від 25 вересня 2026 року повідомляє про зростання сукупної пропускної здатності rollout на 40 відсотків завдяки DeepEP поверх EFA.
Цикл rollout, обмежений комунікацією
Розрідженіші архітектури MoE дешевші в інференсі, але роблять навчання обмеженим комунікацією, а не обчисленнями. Головне джерело цих витрат це Expert Parallelism (EP): до схем Tensor, Data і Pipeline Parallelism додається динамічна маршрутизація токенів all-to-all між пристроями.
Асинхронне RL-завдання виконує дві роботи одночасно: генерація rollout це розподілений інференс, що максимізує сукупну пропускну здатність, а навчання політики потребує синхронних, тісно зв'язаних воркерів, де один відстаючий зупиняє все завдання або спричиняє таймаути NCCL. За межами однієї інстанції трафік переходить від NVLink усередині вузла до повільніших міжвузлових ліній.
Як DeepEP передає токени через EFA
DeepEP замінює звичайні all-to-all колективи двома ядрами: dispatch надсилає токени до віддалених експертів, combine збирає результати; усередині вузла вони використовують NVLink, між вузлами libfabric. AWS внесла в upstream зміни, які переносять примітиви DeepEP на libfabric, тож DeepEP v2 отримав нативну підтримку EFA, а NCCL 2.31 додає найновіші оптимізації EFA. На інстанціях P5 і P6 EFA разом із NVIDIA GPUDirect RDMA передає дані безпосередньо між буферами пам'яті GPU, оминаючи CPU.
Що показує бенчмарк і що потрібно для запуску
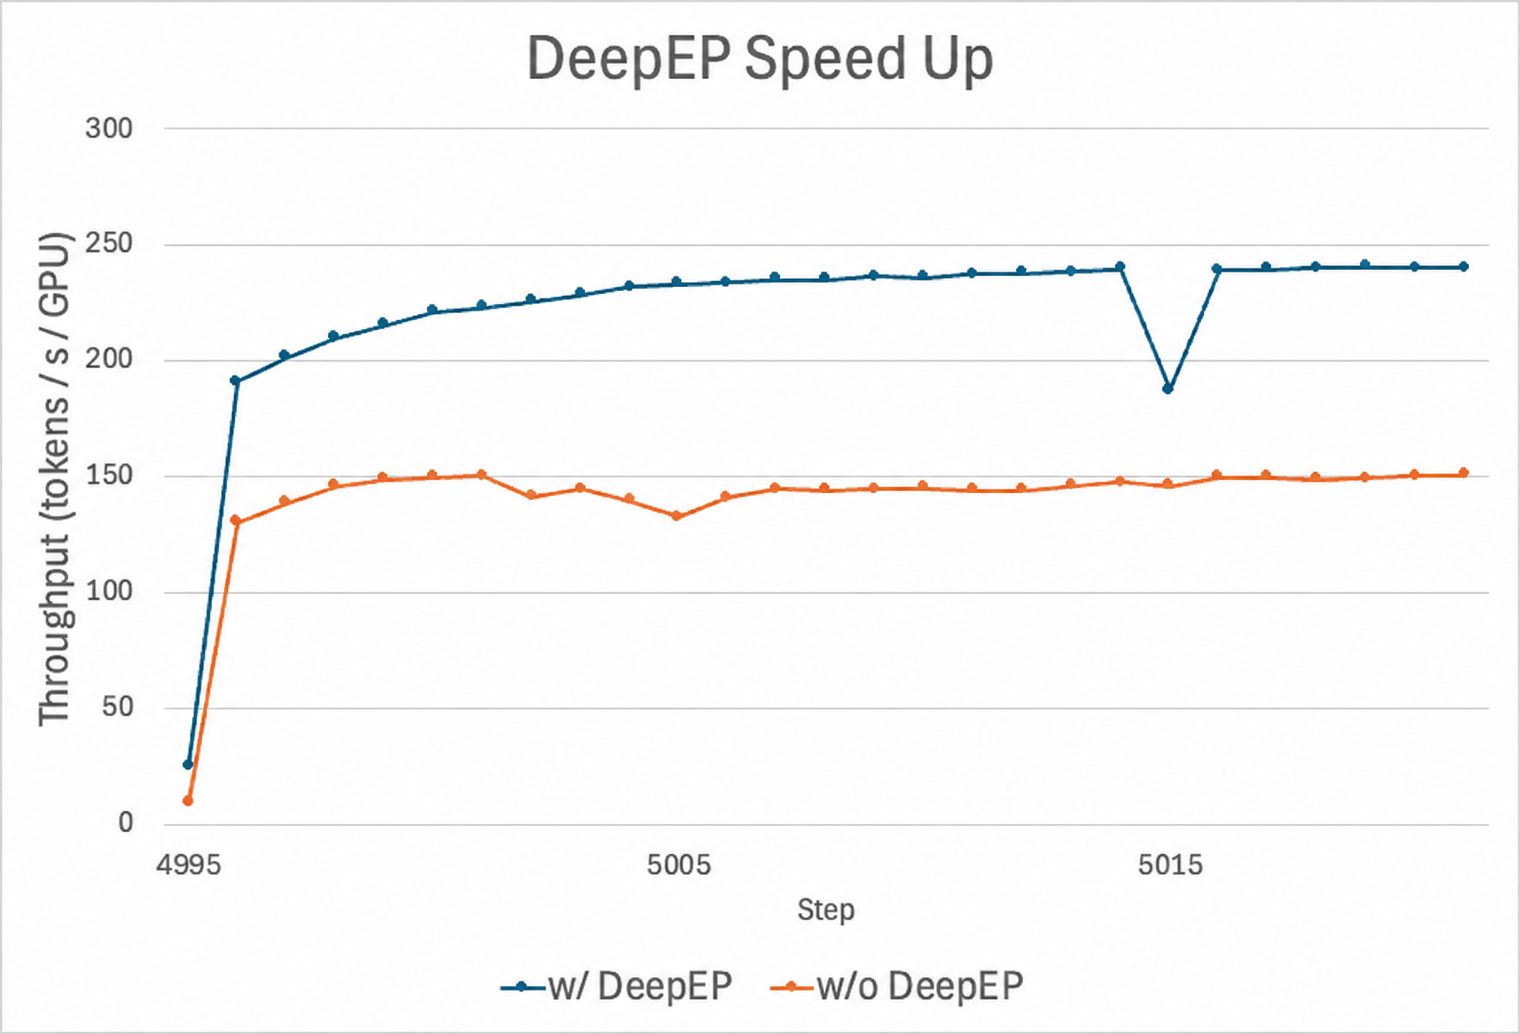
На 48 інстанціях P5en, з яких 16 для навчання і 32 для інференсу, на одній надрозрідженій моделі MoE DeepEP поверх EFA підвищив пропускну здатність rollout на 40 відсотків, а масштаб сягнув приблизно тисячі прискорювачів. Базою був стек на Slime (CUDA 12.9, PyTorch 2.9.1, NCCL 2.27, SGLang 0.5.9, Slime 0.2.4), покращеним варіантом стек DeepEP-over-EFA (CUDA 13.0, PyTorch 2.12, NCCL 2.31, EFA 1.49, DeepEP 2.0, SGLang 0.5.17, Miles 0.1.0).
У публікації перелічено Amazon EKS 1.31 або новіший, EFA installer 1.49 з плагіном AWS OFI NCCL та інстанції p5.48xlarge чи p6-b200.48xlarge; вузли мають бути в одній Availability Zone. Для rollout підходять Spot-інстанції Amazon EC2: незавершені задачі повертаються в чергу, а навчання політики зберігає стабільну потужність. Завдання надсилають через TorchX, чекпойнти зберігають в Amazon S3.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.