Есе: AI-розробка нормалізує збої, причин яких ніхто не шукає
Есе на блозі ihatethefuture.com твердить: LLM-прискорена розробка привчає і творців, і користувачів приймати «іноді просто все погано» замість того, щоб доходити до конкретних причин збоїв.
Есе, опубліковане на блозі ihatethefuture.com (автор публікується під псевдонімом patrickxia), очолило Hacker News. Його автор твердить, що культура LLM-прискореної розробки поступово нормалізує збої, які ніхто не намагається пояснити.
«Stupid thing sucks»
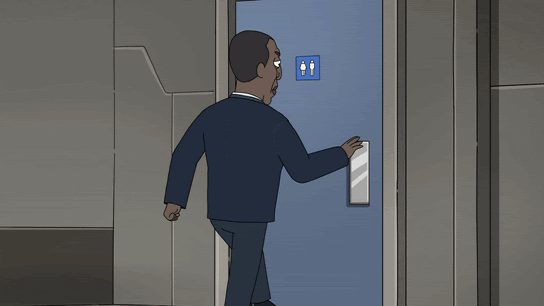
Текст відкривається двома кадрами з мультфільму, де персонаж намагається пройти крізь двері, які не відчиняються. Перешкода цілком конкретна: спершу на шляху тіло людини, згодом золото приблизно на мільярд доларів. В обох сценах роздратований персонаж бурмоче «stupid thing sucks» (щось на кшталт «дурна річ, та й годі») і йде далі. Автор називає це «не розумною моделлю дверей»: у збою була конкретна причина, а докір дістався не тому об'єкту.
Jev і галочка «AI-powered»
Далі есе звертається до Jev, моделі від TypeSafe AI, яка повертає типізовані значення разом з оцінками ймовірностей. Автор перелічує її переваги: швидкість і дешевизну, на ній легко щось збудувати. Питання в тому, що відбувається після. За словами автора, покупці майже не запускають оцінювання (evals): вони ставлять Jev непрозорі питання й отримують непрозорі відповіді, а тоді можуть поставити галочку «AI-powered». Коли ламається логіка на нижчому рівні, все списують на «ну, AI помиляється», а бюджети помилок, режими відмов і тестові набори відкладають. Частоту відмов зрештою виявляє сам користувач.
Есе передбачає очевидне заперечення: Jev повертає оцінки впевненості. А що ви з ними зробите? Щоб ухвалити на їх основі розумне рішення, треба розуміти, наскільки добре вони відкалібровані, і мати модель вартості невизначеності. У найкращому разі, пише автор, люди використовують оцінки впевненості «за принципом карго-культу», у найгіршому посилаються на них як на виправдання невдалого виклику, ніби відповідь «впевнений на 73%» автоматично означає бюджет помилки в 27%.
Відповідальність і межа розслідування
Коли на сайті ламається кнопка, в інженера зазвичай є модель того, що мало статися: порушено контракт, збій у DNS, хтось випустив скрипт із синтаксичними помилками на одному зі шляхів, обробник кинув виняток, якого не чекали. Доступу до налагодження «голого» HTTP 500 може й не бути, але є людина, чия робота зрозуміти, чому ендпоінт не працює. Для багатьох користувачів реальність інша: «іноді просто все погано».
Головний страх есе не в тому, що LLM-керована розробка дасть більше збоїв. Дасть, і вже дає: це частина ціни будівництва по-новому. Страх у тому, що «іноді просто все погано» дедалі частіше стає прийнятною кінцевою точкою самого розслідування. Автор вважає це втратою, адже прискорена робота може й допомагати: автоматизовані процеси перевірки якості не пишуть через брак часу інженерів, а те саме оцінювання, яке замінило б Jev або виправдало його використання, «може бути за кілька промптів». Есе завершується метафорою: ми будуємо системи, де ні користувач, ні творець не зацікавлені перевірити, чи є за дверима тіло.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.