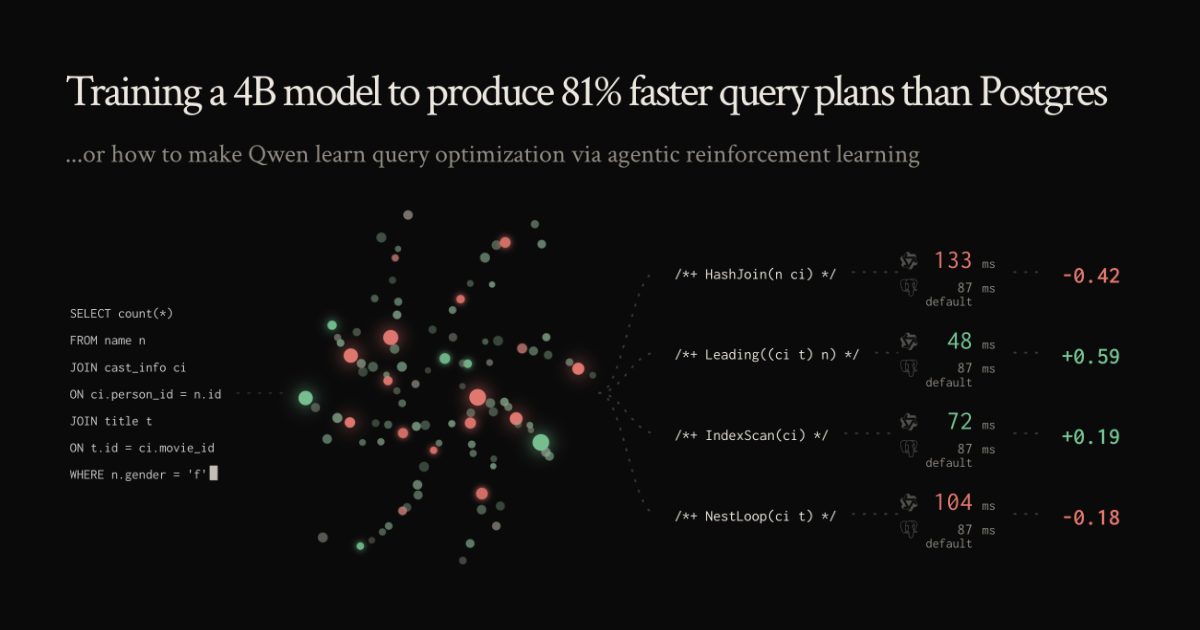
Модель на 4B параметрів після RL-навчання будує плани запитів на 81% швидші за Postgres
Рохан Бансал навчив відкриту модель на 4 мільярди параметрів керувати планувальником PostgreSQL підказками pg_hint_plan. На 113 запитах із багатьма з'єднаннями сумарна затримка впала на 44,7%.
Мала модель проти планувальника Postgres
Рохан Бансал опублікував експеримент, який показує, що невелику відкриту мовну модель можна дообучити так, щоб вона будувала для PostgreSQL кращі плани запитів, ніж сама база даних. На Join Order Benchmark (JOB) — 113 насичених з'єднаннями SQL-запитів до набору даних IMDb — навчена модель на 4B параметрів після вибору найкращого кандидата досягла середнього геометричного прискорення 1,81x, а сумарна затримка всього навантаження зменшилася на 44,7%. Той самий чекпойнт дав 68 перемог і жодної регресії.
Початковий стан був невтішним: ненавчена модель не змогла побудувати придатний план для 99 із 113 запитів, і лише 14 спроб дали валідного кандидата. Автор пояснює це тим, що оптимізатори запитів — складна задача: порядок з'єднань є NP-складною проблемою, а планувальник оцінює кардинальність за статистикою, а не підрахунком рядків. Натомість перевірити план легко, бо єдиний критерій — час виконання. Саме ця асиметрія робить задачу зручною для навчання з підкріпленням.
Підказки, середовище агента й дистиляція
Модель не замінює планувальник, а керує ним. Бансал використав pg_hint_plan — стороннє розширення, яке приймає структуровані підказки в SQL-коментарях, — і побудував агентне середовище qo-agent із шістьма інструментами. Агент оглядає таблиці та статистику стовпців, читає типовий план і надсилає кандидатні дії; кожен кандидат компілюється в підказки, виконується й оцінюється за часом.
Навчання відбувалося у два етапи. Спочатку — кероване дообучення методом off-policy дистиляції з 500 агентних траєкторій GPT-6 Astra, де оновлювався лише LoRA-адаптер розміром 42,5 МБ із 21,2 мільйона параметрів поверх 4,66-мільярдної похідної Qwen. Дві епохи покращили результат, а третя його зіпсувала, хоча валідаційна втрата вже не змінювалася.
Винагороди в умовах шуму
Другий етап — агентне навчання з підкріпленням із модифікованим варіантом GRPO. Прискорення обчислювали як медіану трьох вимірювань типового плану, поділену на медіану трьох вимірювань кандидата, і вимірювальний стенд довелося будувати особливо ретельно: чотири контейнери PostgreSQL на одній машині створюють конкуренцію за page cache, що спотворює виміри. Навчання розділили між двома місцями — vLLM і тренер на орендованому вузлі 2x H100, а контейнери з базою — на столі автора. Початкова формула винагороди штовхала модель повертати типовий план Postgres; рішенням було порівнювати rollout між собою, а не оцінювати їх абсолютно.
Чого навчилася модель
Аналіз фінального чекпойнта після 1200 оновлень показує, що більшість пошуків спершу оглянули таблицю, статистику стовпців або типовий план. Проєкт коштував близько 1200 доларів: приблизно 95 годин вузла 2x H100 у Lambda та 400 доларів на API OpenAI для демонстраційних траєкторій. Висновок Бансала не в тому, що великі моделі застаріли — саме дистиляція з Astra дає малій моделі працювати — а в тому, що малі моделі заслуговують на серйозну увагу у вузьких задачах із легким способом перевірки результату.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.