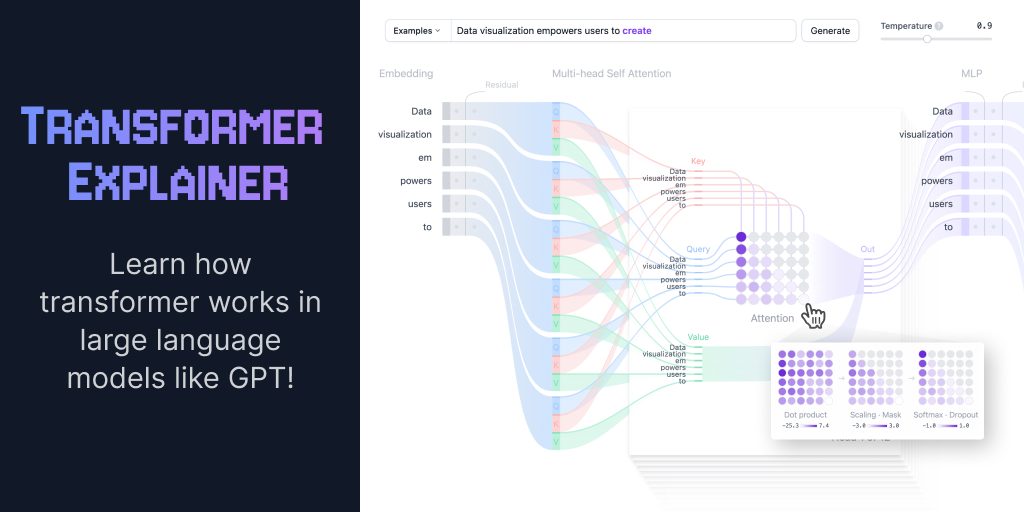
Transformer Explainer: інтерактивний погляд усередину мовної моделі GPT-2
Інтерактивний інструмент дослідників із Технологічного інституту Джорджії запускає GPT-2 просто в браузері та показує, як токени, увага й вибірка перетворюють запит на наступне слово.
Transformer Explainer — це інтерактивний сайт, який показує, як трансформерна мовна модель перетворює запит на наступне слово. Просто в браузері працює модель GPT-2 (small) на 124 мільйони параметрів, тож усі графіки на сторінці реагують на введений текст. Проєкт створила команда з восьми дослідників Технологічного інституту Джорджії, серед них Aeree Cho, Grace C. Kim і Polo Chau; його супроводжують стаття в ACM Digital Library та відеоурок.
Від токенів до ймовірностей
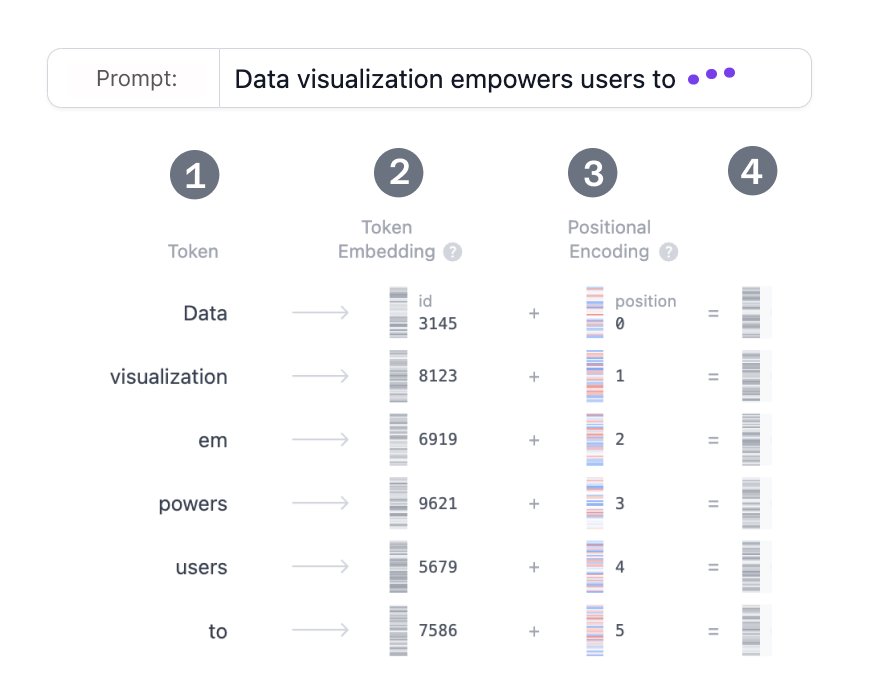
Вхідний текст розбивається на токени — слова або частини слів, — і кожен токен перетворюється на вектор розмірності 768. Словник GPT-2 містить 50 257 токенів, тож сама лише матриця ембедингів зберігає близько 39 мільйонів параметрів. Позиційна інформація додається окремо, бо архітектура не має вбудованого відчуття порядку слів.
Далі вектори проходять через 12 однакових трансформерних блоків. Кожен поєднує багатоголову самоувагу, яка дозволяє токенам обмінюватися інформацією, з багатошаровим перцептроном, що доопрацьовує кожен токен окремо. Оцінки уваги маскують так, щоб позиція бачила лише токени ліворуч — саме це уможливлює передбачення наступного токена без підглядання наперед.
Усередині уваги та MLP
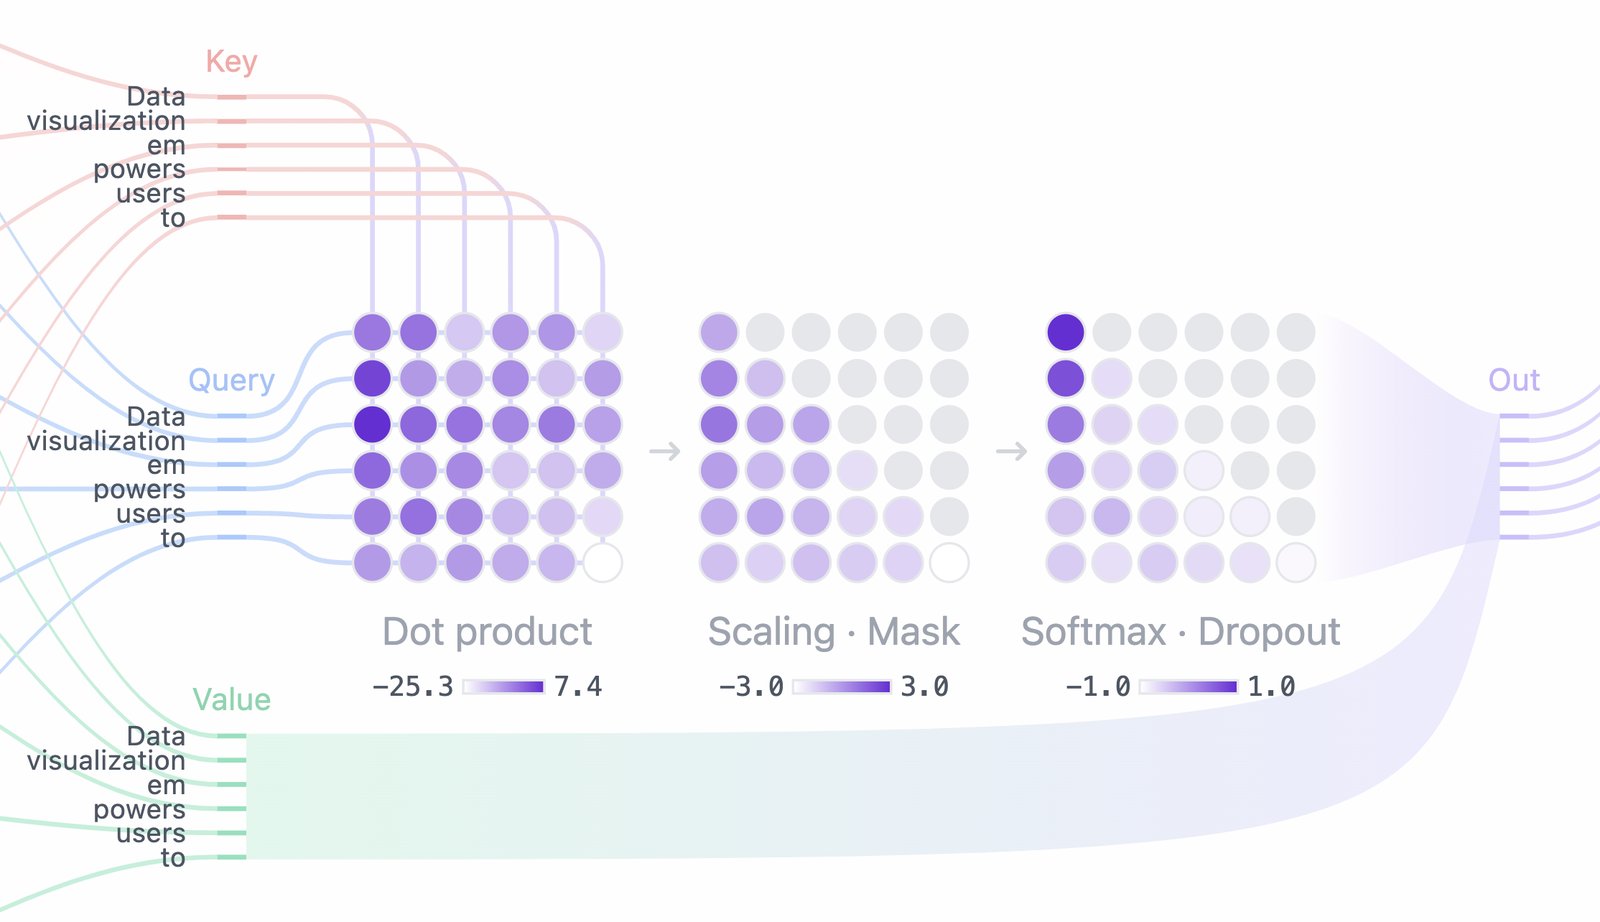
Query, Key і Value будуються з ембедингів за допомогою навчених матриць ваг. Сайт порівнює їх із вебпошуком: запит — це те, що ви вводите, ключі — заголовки результатів, значення — вміст сторінок. GPT-2 (small) розділяє їх на 12 голів: одна може відстежувати синтаксис, інша — ширше значення. Скалярні добутки масштабують, маскують і пропускають через softmax, після чого множать на матрицю значень.
MLP розширює подання кожного токена з 768 до 3 072 вимірів лінійним шаром і активацією GELU, а потім стискає назад до 768. Останній лінійний шар проєктує результат на весь словник із 50 257 токенів як логіти, а softmax перетворює їх на розподіл імовірностей, з якого вибирають наступний токен.
Повзунки, вибірка та реалізація
Відвідувачі можуть рухати повзунок температури, яка ділить логіти: значення менше 1 загострює розподіл і робить вивід передбачуванішим, більше 1 — розрівнює його та додає різноманітності. Налаштування top-k і top-p обмежують вибірку найімовірнішими кандидатами.
Демо працює повністю в браузері: реалізацію GPT на PyTorch з проєкту nanoGPT від Andrej Karpathy конвертовано в ONNX Runtime, а інтерфейс побудовано на Svelte та D3.js.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.