NVIDIA відкрила код NVCRE, щоб перевіряти GPU-кластери до запуску навантажень
Контролер для Kubernetes під ліцензією Apache 2.0 запускає справжні розподілені навантаження на топологічних групах вузлів і називає проблемні GPU ще до старту продакшн-задач.
Здоровий на папері, але не під навантаженням
GPU-кластер може пройти всі перевірки стану й усе одно не впоратися з AI-навантаженням: навіть коли кожен GPU, лінк і pod звітують про справність, завдання навчання на 512 GPU може втратити продуктивність. Причина — один повільний GPU, лінк, що деградує під навантаженням, або конфігурація, яка тихо веде трафік повільнішим шляхом.
NVIDIA Cluster Readiness Engine (NVCRE) — контролер для Kubernetes з відкритим кодом, який звужує пошук до конкретних вузлів. Він запускає реальні розподілені навантаження на групах вузлів, сформованих за топологією, і повідомляє, які вузли не пройшли кожен тест, тож готовність стає доведеною властивістю кластера, а не припущенням.
Багаторівневий API і вбудований каталог
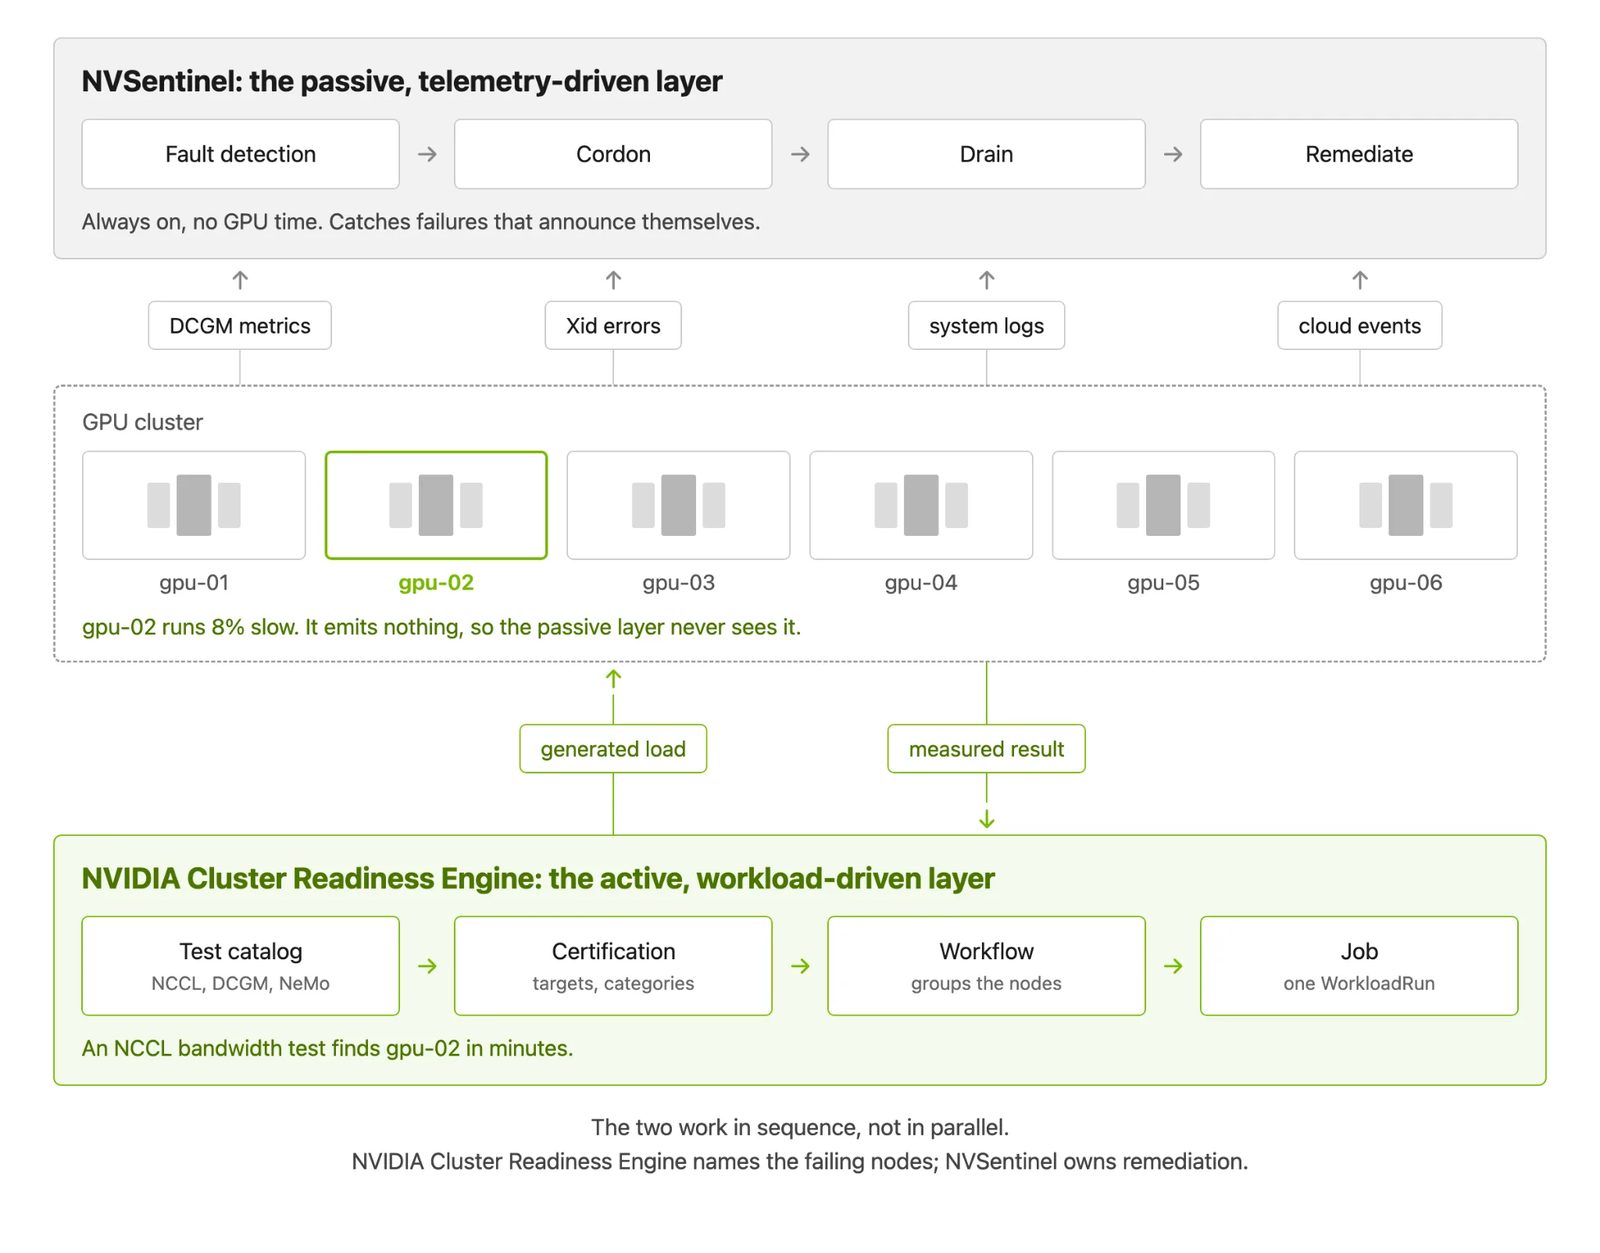
В API є три ресурси: Certification визначає вузли й категорії для перевірки; кожну категорію веде Workflow, який застосовує налаштування платформи та GPU і створює дочірній Job; Job запускає навантаження, стежить за станом вузлів і приписує збої конкретним вузлам.
Каталог охоплює п'ять варіантів NCCL-комунікації, діагностичний набір NVIDIA DCGM рівня 4 і попереднє навчання NVIDIA NeMo з моделями Nemotron 5. Критерії проходження описують мовою Common Expression Language, і завдання, яке завершилося, але не досягло мети, однаково вважається невдалим.
Тестування в тому масштабі, де з'являються збої
Поле testScale вибирає стратегію групування: intra-node, intra-rack (за міткою nvidia.com/gpu.clique), full-scale або diagnose. У режимі diagnose NVCRE ділить групи, що зірвалися, і перезапускає половини, доки не назве кількох підозрюваних вузлів замість цілої групи.
WorkloadRun запускає багатовузлові завдання з образу контейнера, вибору фреймворку (torch, mpi або exec) і кількості вузлів. Параметр spec.gangScheduler підключає pod'и до gang-aware планувальника, наприклад KAI Scheduler, і уникає глухого кута на завантажених кластерах.
Виявити, підтвердити, усунути
NVCRE — один із шарів NVIDIA DSX OS: AICR зберігає перевірену конфігурацію й виявляє дрейф, NVCRE генерує навантаження, щоб знайти збої, невидимі в телеметрії, а NVSentinel стежить за метриками DCGM, помилками Xid і системними логами.
NVCRE фіксує вузли, що зірвалися, та причини, але сам не робить cordon, taint і не змінює стани вузлів; Certification Monitor у NVSentinel перетворює невдалу сертифікацію на подію стану. Проєкт ліцензовано за Apache 2.0; потрібні Kubernetes 1.29 або новіший, kubectl, Helm 3.x і NVIDIA GPU Operator.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.