«Ваш локальний LLM розумніший, ніж здається»: де стек інференсу втрачає якість
Серія експериментів на форумі Level1Techs показує, що уявна «дурість» локальної моделі часто походить від attention-бекендів, квантування KV-кешу та тензорного паралелізму, а не від самої моделі.
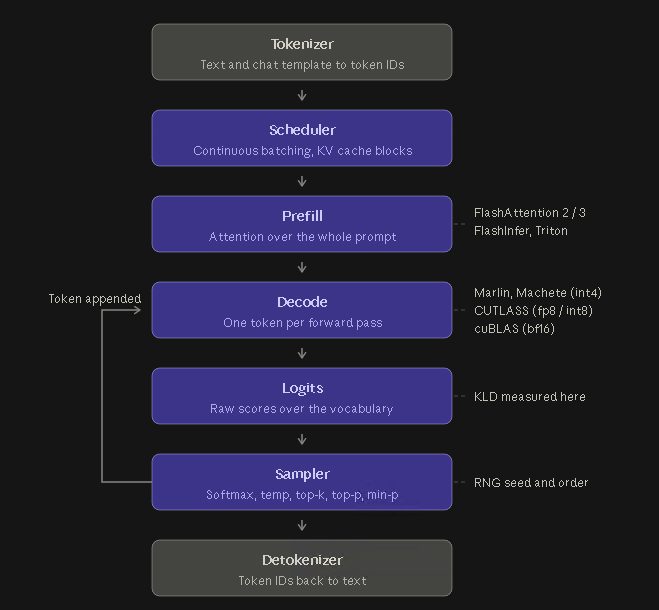
Серія експериментів, опублікована на форумі Level1Techs, показує, що локально запущена модель часто виглядає слабшою, ніж є насправді, — і причиною нерідко є сам стек інференсу, а не модель. Автор теми, користувач під ніком thr3e, запускає ті самі ваги з різними налаштуваннями середовища й вимірює, де саме результати починають розходитися.
Жодні дві реалізації не однакові
Автор називає «референсною реалізацією» лабораторію, яка публікує модель, першою її хостить і заявляє оригінальні бенчмарки: її обладнання та програмне забезпечення відрізняються від ваших. Домашні конфігурації часто змішують різні покоління GPU, а різні набори інструкцій обчислюють математику наступного токена по-різному навіть з ідентичними вагами. Контейнер vLLM nightly, який використовували в тестах, містив 734 пакети, з них 252 — Python: 734 кодових бази, кожна з власними помилками.
Три тести: бекенди, KV-кеш, квантування
У першому тесті порівняли три attention-бекенди — FlashAttention 2, Flash Inference і Triton Attention — на Qwen3.6-27B у BF16 на RTX PRO 6000 Blackwell, не змінюючи нічого іншого. Навантаженням був контекст приблизно на 100 тис. токенів із реального робочого процесу з викликами інструментів. Перші кілька тисяч токенів усі бекенди збігалися, далі почали розходитися. Повторні запуски того самого бекенду давали біт-у-біт ідентичні логити, тож розбіжність походить від математики префілу, а не від випадковості.
У другому тесті квантували лише KV-кеш: int8 зрештою відновлювався після помилки у виклику інструменту, int4 — ні. У третьому порівняли п'ять форматів ваг: найкращим виявився INT8 W8A16, а NVFP4 від Nvidia опинився останнім — близько 50% токенів «переверталися» на контексті 88 тис. токенів. NVFP4 та AWQ W4A16 виконали хибну команду на пристрої Cisco — 'show run' там, де потрібна була 'show arp'.
Один перевернутий токен, одне провалене завдання
У другій частині автор записав 100% логитів під час викликів інструментів і розгалужував генерації, щоб побачити, куди кожна версія пішла. В одному випадку запуск із FlashAttention 2 звернувся до GigabitEthernet0/1/4 замість GigabitEthernet0/0/1.201, а потім виконав 'show run' замість 'show mac address table'; в іншому не вдалося встановити опис інтерфейсу. З тензорним паралелізмом те саме завдання пройшло на TP1, провалилося на TP2 і знову пройшло на TP4 — що за глибшого аналізу зазвичай вказує на NCCL.
Як вимірювати правильно
Порада з теми — запускати стандартні бенчмарки, репрезентативні для вашого реального навантаження: temperature на нулі та три тестові промпти не є добрим аналогом агентної роботи, якій потрібні довгий контекст, виклики інструментів і перевірки в конкретній предметній області. Використовуйте параметри семплера й chat template з картки моделі — надто низька temperature і є причиною того, що деякі моделі застрягають у циклі всередині THINK. Коментатори також наголосили, що KL-дивергенція вимірює зсув розподілу від базового, а не правильність, і є напрямленою; розбіжність top-1 — окрема, суворіша метрика. BF16 — це еталон чисельної точності, а не оракул: квантована модель може відійти від нього й усе одно дати кращу відповідь.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.