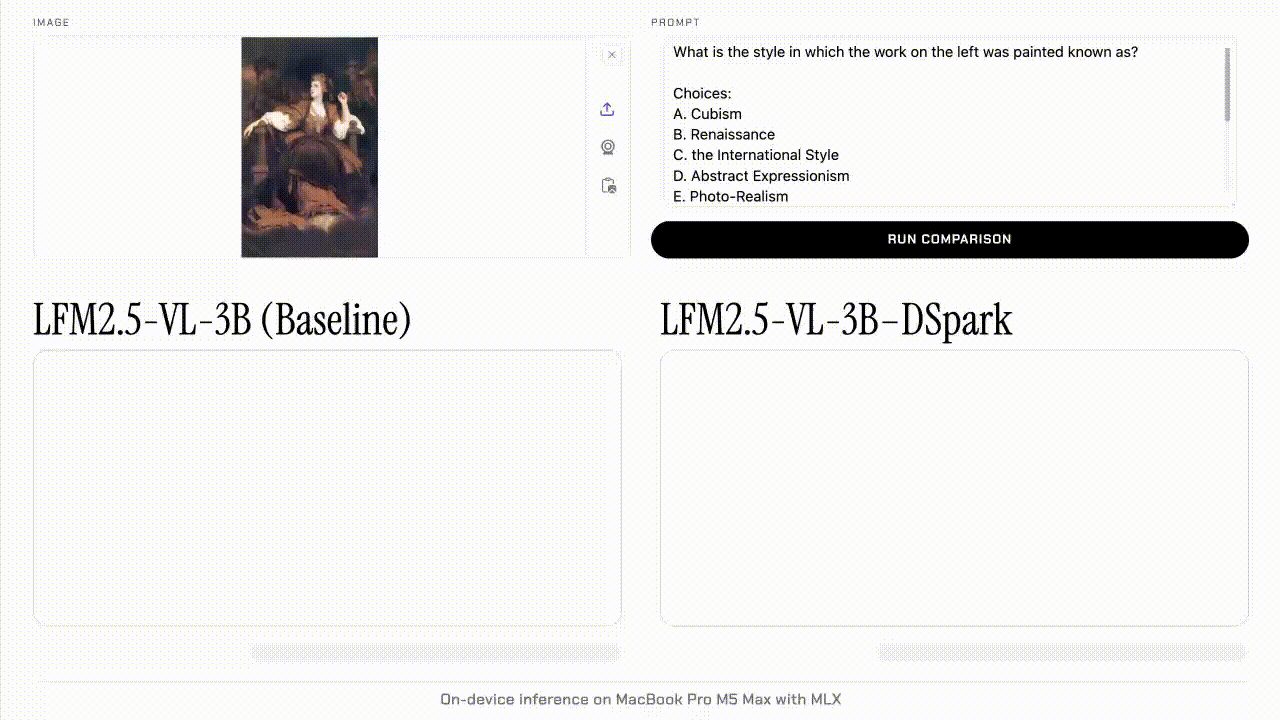
Liquid AI-ը թողարկել է DSpark դրաֆտ մոդելը տեսա-լեզվական մոդելների արագացման համար
Liquid AI-ը ներկայացրել է փորձարարական DSpark դրաֆտ մոդելը տեսա-լեզվական LFM2.5-VL-3B մոդելի համար։ Սպեկուլյատիվ ապակոդավորումը սարքում արագացնում է մինչև 3,13 անգամ, H100-ում՝ 2,66 անգամ, առանց ելքի որակի փոփոխության։
Liquid AI-ը սեպտեմբերի 24-ին ներկայացրել է փորձարարական DSpark դրաֆտ մոդելը տեսա-լեզվական LFM2.5-VL-3B մոդելի համար։ Այն ավելացնում է սպեկուլյատիվ ապակոդավորման ուղի. հիշողության փոքր աճի դիմաց՝ զգալի արագացում՝ առանց ելքի որակը փոխելու։
Ինչ է տալիս դրաֆտ մոդելը
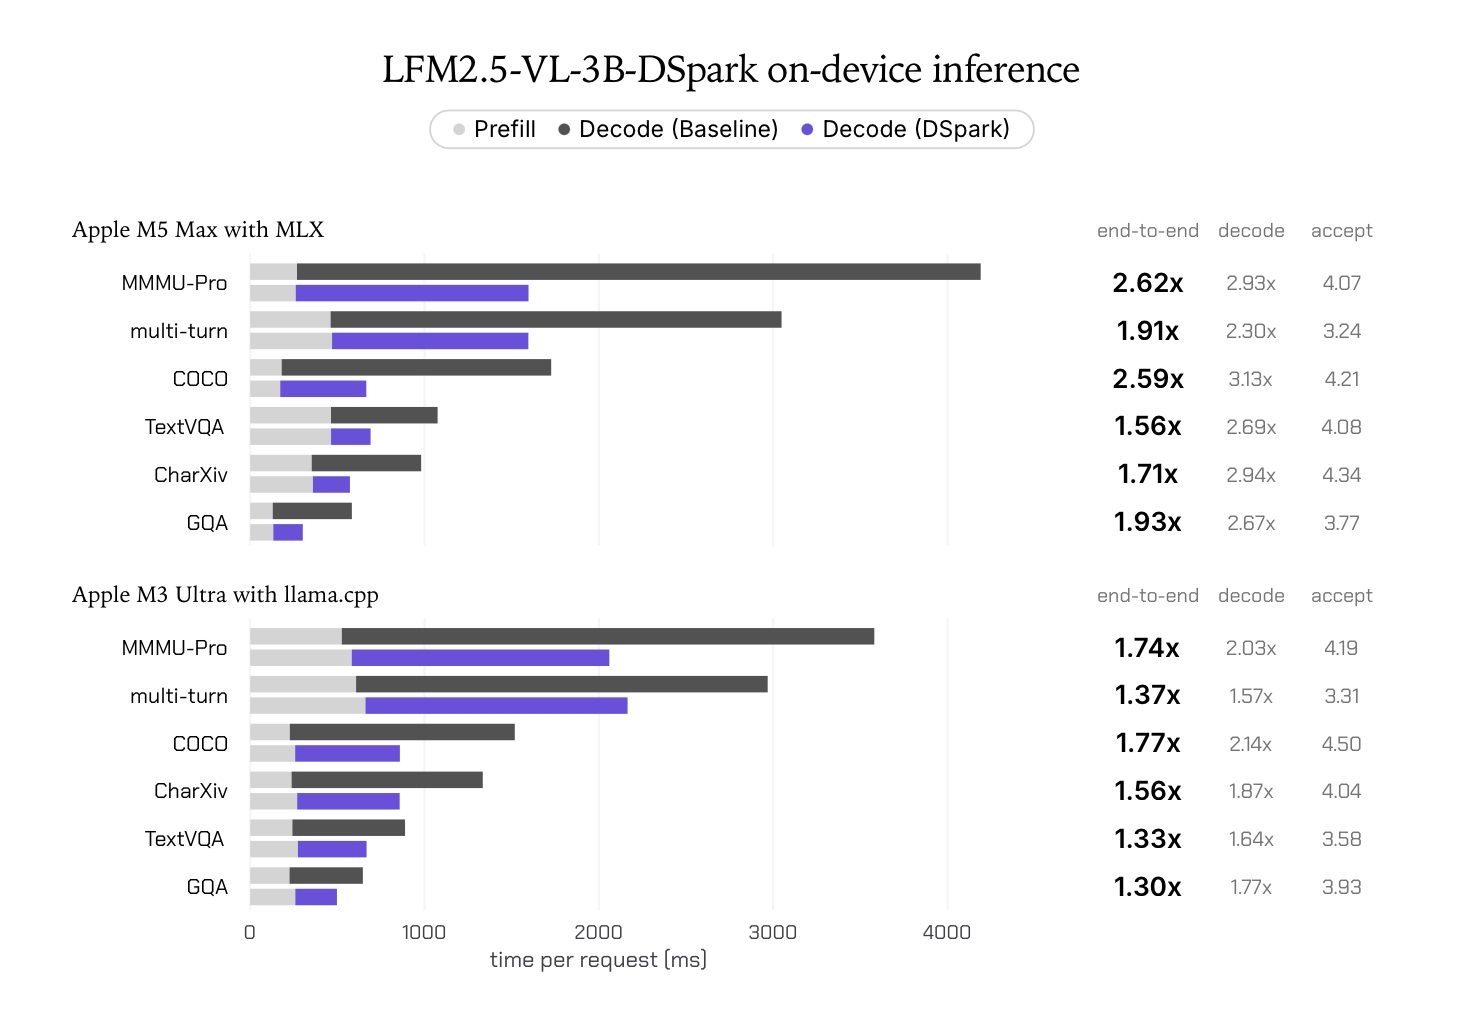
Liquid AI-ի չափումներով՝ ապակոդավորումը սարքում արագանում է մինչև 3,13 անգամ, իսկ H100-ում՝ 2,66 անգամ, ծայրից ծայր ուշացումը նվազում է 2,62 և 2,27 անգամ։ Դրաֆտերը թիրախ մոդելին ավելացնում է 280 միլիոն պարամետր՝ 3B մոդելի 8,9%-ը, իսկ llama.cpp-ի, MLX-VLM-ի և SGLang-ի աջակցությունը կա առաջին իսկ օրվանից։
Ինչպես է աշխատում սպեկուլյատիվ ապակոդավորումը
Տեսային դրաֆտերն օգտագործում է նույն ճարտարապետությունը, ինչ տեքստային LFM2.5-DSpark մոդելները. կարդում է թիրախ մոդելի թաքնված վիճակները սահմանված շերտերում և դրանց հիման վրա առաջարկում k թոքենների բլոկ։ Պատկերի հատվածներն ու տեքստային թոքենները վերածվում են ընդհանուր ներկայացման, ուստի դրաֆտերն աշխատում է միևնույն չափողականության վեկտորների հետ։
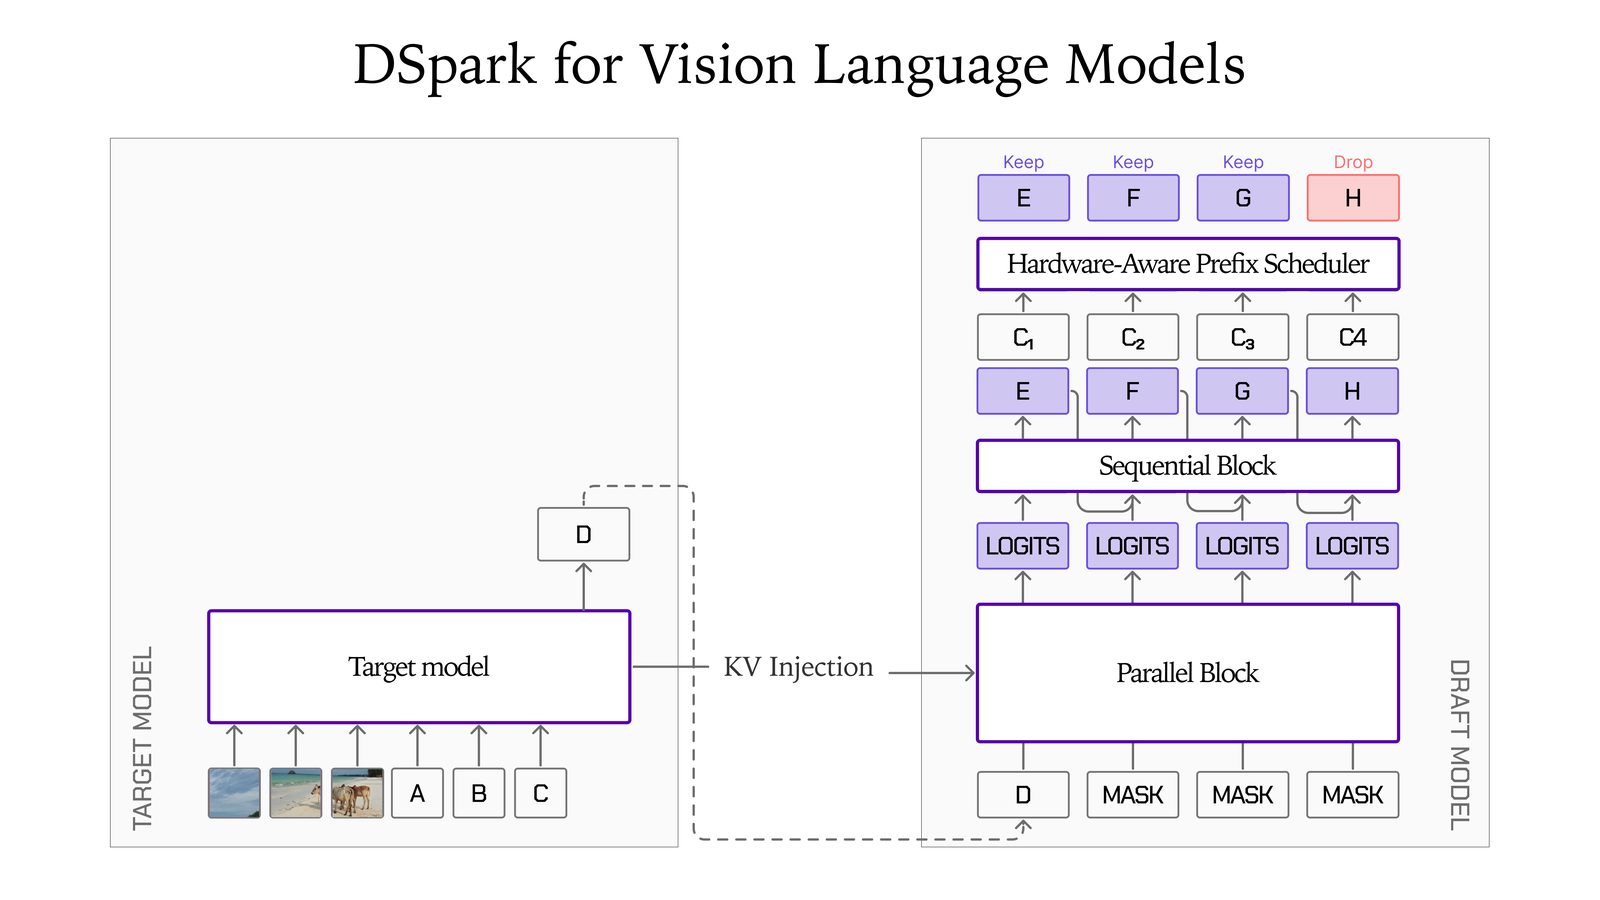
Ուսուցումը ընթացել է DSpark-ի բաղադրատոմսով՝ տեսա-լեզվական SFT տվյալների հիման վրա. 3, 4 և 5 շերտերի համեմատությունից հետո ընտրվել է դրաֆտեր՝ 4 շերտով, որը հիմնվում է միայն ուշադրության մեխանիզմի վրա, բլոկի չափը՝ 9։ Դրաֆտերն ունի մոտ 279,5 միլիոն պարամետր։
Արագացումը սարքում և H100-ում
Չափումները կատարվել են 8 բլոկի չափով և MMSpec չափանիշով վեց տեսային առաջադրանքներում։ M5 Max-ում MLX-ով ապակոդավորումը արագացել է 2,30-ից 3,13 անգամ, իսկ ուշացումը նվազել է 1,56-ից 2,62 անգամ։ M3 Ultra-ում llama.cpp-ով ապակոդավորումը բարելավվել է 1,57-ից 2,14 անգամ, իսկ ընդհանուր ժամանակը՝ 1,30-ից 1,77 անգամ։ H100-ում ապակոդավորումն արագանում է մինչև 2,66 անգամ, իսկ ուշացումը նվազում է 1,64-ից 2,27 անգամ։
Որտեղ սպեկուլյացիան դադարում է օգնել
Սպեկուլյատիվ ապակոդավորումը արագացնում է միայն ապակոդավորումը, ոչ պատկերի կոդավորումը կամ նախնական լրացումը։ Պատկերը սկզբում անցնում է տեսային կոդավորիչով, ապա լեզվական հիմքը միասին մշակում է հարյուրավոր տեսային թոքեններ և տեքստային հարցումը, իսկ սահմանային սարքերում այդ փուլը զբաղեցնում է ուշացման մեծ մասը։ Երբ այդ փուլերն արդեն ծախսում են ժամանակի զգալի մասը, նույնիսկ մեծ արագացումը տալիս է միայն չափավոր շահույթ։ Liquid AI-ը դա բացատրում է Ամդալի օրենքով։
Դրաֆտերը հասանելի է Hugging Face-ում Safetensors և GGUF ձևաչափերով. անհրաժեշտ են llama.cpp-ի, MLX-VLM-ի և SGLang-ի այն տարբերակները, որոնք աջակցում են DSpark-ին։ Սպեկուլյատիվ ապակոդավորումը ճշգրիտ է. թիրախ մոդելը ստուգում է յուրաքանչյուր թոքեն, ուստի greedy ռեժիմում արդյունքը համընկնում է թիրախ մոդելի ելքի հետ։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։