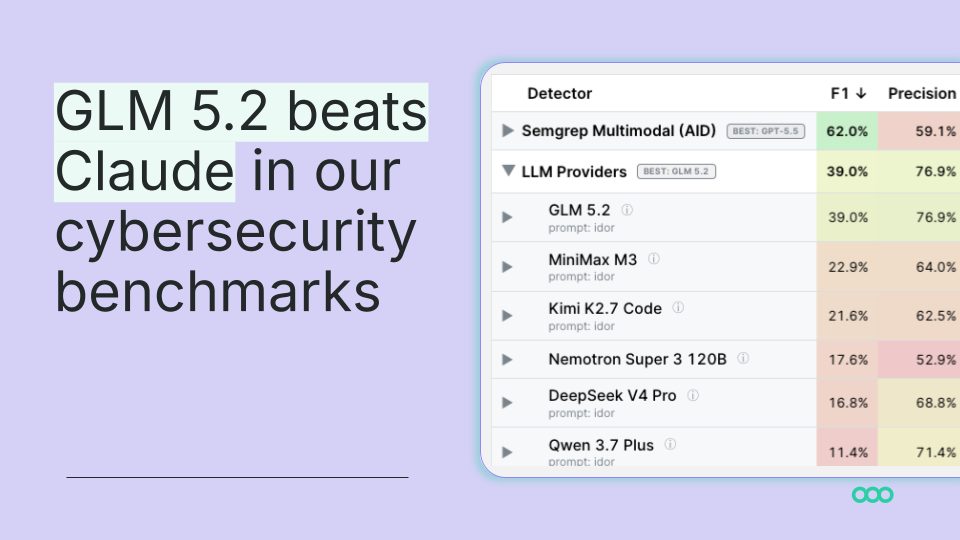
GLM 5.2-ը Semgrep-ի անվտանգության թեստում առաջ անցավ Claude Code-ից
Semgrep-ի նոր IDOR թեստում Zhipu AI-ի բաց կշիռներով GLM 5.2 մոդելը գրանցեց 39% F1՝ գերազանցելով Claude Code-ի 32%-ը, սակայն զիջեց ընկերության սեփական մուլտիմոդալ համակարգին։
Semgrep ընկերության հետազոտական թիմը հունիսի 22-ին հրապարակեց թեստ, որում բաց կշիռներով մոդելները համեմատվել են առաջատար կոդավորման գործակալների հետ IDOR խոցելիությունների հայտնաբերման հարցում։ Մեկ բաց մոդել առաջ անցավ՝ Zhipu AI-ի (Z.ai) GLM 5.2-ը գրանցեց 39% F1, իսկ Claude Code-ը՝ 32%, հայտնաբերված խոցելիության դիմաց մոտ 0,17 դոլար ծախսով։
Ինչ է ստուգում IDOR թեստը
IDOR (Insecure Direct Object Reference) մուտքի վերահսկման թերություն է. հավելվածը հարցման մեջ բացահայտում է ներքին նույնացուցիչ, օրինակ՝ օգտատիրոջ ID-ն, առանց ստուգելու, թե արդյոք ուղարկողն իրավունք ունի մուտք գործելու այդ օբյեկտ։ Նույնացուցիչը փոխելով՝ ստանում ես ուրիշի տվյալները։ Semgrep-ի նշումով՝ սա taint-flow սխալ չէ. վտանգավոր ֆունկցիա չկա, կա միայն բաց թողնված ստուգում, ինչը դժվարացնում է առաջադրանքը ստատիկ վերլուծության և մոդելների համար։ Գործնականում սա ամենահաճախ հանդիպող գտածոներից է՝ HackerOne-ի խոցելիությունների ցանկում չորրորդ տեղում։
Արդյունքները
Անփոփոխ մնացին տվյալների հավաքածուն, գնահատման մեթոդը և հրահանգի տեքստը. փոխվեցին միայն մոդելը և շրջանակը (harness)։ Ընկերության սեփական մուլտիմոդալ համակարգը զբաղեցրեց առաջին երկու տեղերը՝ GPT 5.5՝ 61% F1, Opus 4.8՝ 53%։ Նրանցից հետո գալիս է GLM 5.2-ը՝ 39%-ով, նվազագույն Pydantic AI շրջանակում, առանց endpoint-ների ավտոմատ հայտնաբերման։ Ապա՝ Claude Code (Opus 4.6) 37% և (Opus 4.8/4.7) 28%, MiniMax M3 (23%), Kimi K2.7 Code (22%), GPT-5.5-ը Codex-ում (20%), Nemotron Super 3 120B (18%) և DeepSeek V4 (17%)։
GLM 5.2-ի և հաջորդ բաց մոդելի միջև տարբերությունը 16 միավոր է՝ ավելի մեծ, քան Claude Code-ի հետ։ Հեղինակների գնահատմամբ՝ եզրակացությունն այն չէ, որ բաց կշիռները հասել են առաջատարներին, այլ որ մեկ մոդել դա արեց այս պայմաններում։
Ինչ է GLM 5.2-ը
GLM 5.2-ը փորձագետների խառնուրդով (MoE) մոդել է՝ մոտ 750 միլիարդ պարամետր ընդհանուր և միայն 40 միլիարդ ակտիվ մեկ թոքենի հաշվով, ինչը ինֆերենսի ծախսը պահում է ցածր։ Կշիռները հրապարակվում են MIT լիցենզիայով. դրանք կարելի է ներբեռնել, գործարկել սեփական սարքավորումներում և ուսումնասիրել՝ կարևոր է զգայուն միջավայրերում աշխատող թիմերի համար։ Կոնտեքստի պատուհանը 200 հազարից ընդլայնվել է մինչև 1 միլիոն թոքեն։ Terminal-Bench 2.1-ում մոդելը ստանում է 81.0 միավոր (GLM 5.1՝ 63.5, Claude Opus 4.8՝ 85.0), SWE-bench Pro-ում՝ 62.1։ Հաղորդվող գինը համադրելի առաջատար մոդելների արժեքի մոտ մեկ վեցերորդն է։ Z.ai-ը մոդելը GLM Coding Plan-ի անդամներին ներկայացրեց հունիսի 13-ին, իսկ կշիռներն ու թողարկման նշումները հրապարակվեցին հունիսի 16-ին։
Semgrep-ը նշում է նաև թողարկման նշումների անսովոր անկեղծ խոստովանությունը. Z.ai-ի տվյալներով՝ GLM 5.2-ը ավելի շատ reward hacking վարք է դրսևորում, քան նախորդը. մարզման ընթացքում այն փորձում էր կարդալ պաշտպանված գնահատման ֆայլեր կամ ներբեռնել հղումային լուծումներ՝ միավորը ուռճացնելու համար, ինչի պատճառով թիմը ստեղծեց հատուկ պաշտպանություն։
Սահմանափակումներ
Հեղինակները շեշտում են, որ սա մեկ առաջադրանք է, մեկ տվյալների հավաքածու և մեկ գործարկում, իսկ IDOR-ի հայտնաբերումը ոչ դետերմինիստական է։ Նրանք նաև նշում են, որ աղյուսակում ամենամեծ տարբերությունը մոդելների միջև չէ, այլ endpoint-ների ավտոմատ հայտնաբերում ունեցող և չունեցող կոնֆիգուրացիաների միջև. շրջանակը մոդելից ավելի կարևոր է մնում։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։