NVIDIA-ն թողարկել է Kumo Tabular բաց մոդելը աղյուսակային կանխատեսման համար
NVIDIA-ն թողարկել է Kumo Tabular-ը՝ բաց բազային մոդել, որը նոր տողերի պիտակները կանխատեսում է մեկ առաջանցիկ անցումով՝ առանց ուսուցման և հատկանիշների պատրաստման, և չորս բենչմարքներում առաջին տեղում է։
NVIDIA-ն սեպտեմբերի 29-ին թողարկել է Kumo Tabular-ը։ Սա բաց բազային մոդել է աղյուսակային տվյալների համար և մտնում է NVIDIA Kumo Structured հավաքածուի մեջ։ Կշիռները Hugging Face-ում են, իսկ կոդը՝ ընկերության բաց գրադարանում (structured-data-models)։ Մոդելը տարածվում է OpenMDW-1.1 լիցենզիայով, որը թույլ է տալիս կոմերցիոն օգտագործում։
Մոդելին տրվում է պիտակավորված տողերով աղյուսակ, և այն վերադարձնում է նոր տողերի պիտակները մեկ առաջանցիկ անցումով՝ առանց ուսուցման, նուրբ լիցքավորման և հատկանիշների պատրաստման, ինչպես դասակարգման, այնպես էլ ռեգրեսիայի համար։ Մոդելը լինում է երեք չափով՝ 28 միլիոնից մինչև 215 միլիոն պարամետր, և մարզվել է միայն արհեստական աղյուսակներում։
Ինչպես է աշխատում
Kumo Tabular-ը տրանսֆորմեր է, որը կառուցված է աղյուսակի կառուցվածքի շուրջ. այն օգտագործում է սյունակի, տողի և համատեքստի ուշադրություն, նման TabICL-ի և TabPFN-ի մոտեցմանը։ Յուրաքանչյուր արժեք գնահատվում է իր սյունակի բաշխման մեջ, տողի ներսում հատկանիշների փոխազդեցությունը ֆիքսվում է, իսկ հայտնի պիտակներով տողերը կապվում են նոր տողերին։ Համատեքստը երբեք չի նայում հարցումներին, ուստի նրա բանալիները հաշվարկվում են մեկ անգամ և բազմիցս օգտագործվում հետագա կանխատեսումների համար։ Թվային և կատեգորիկ տվյալները անցնում են Fourier հատկանիշներով, իսկ բաց թողնված արժեքները լրացում չեն պահանջում։ Ուշադրության ջերմաստիճանը աճում է բանալիների քանակի լոգարիթմի հետ միասին, որպեսզի ավելի մեծ աղյուսակներում սուր մնա։
Ուսուցում արհեստական տվյալների վրա
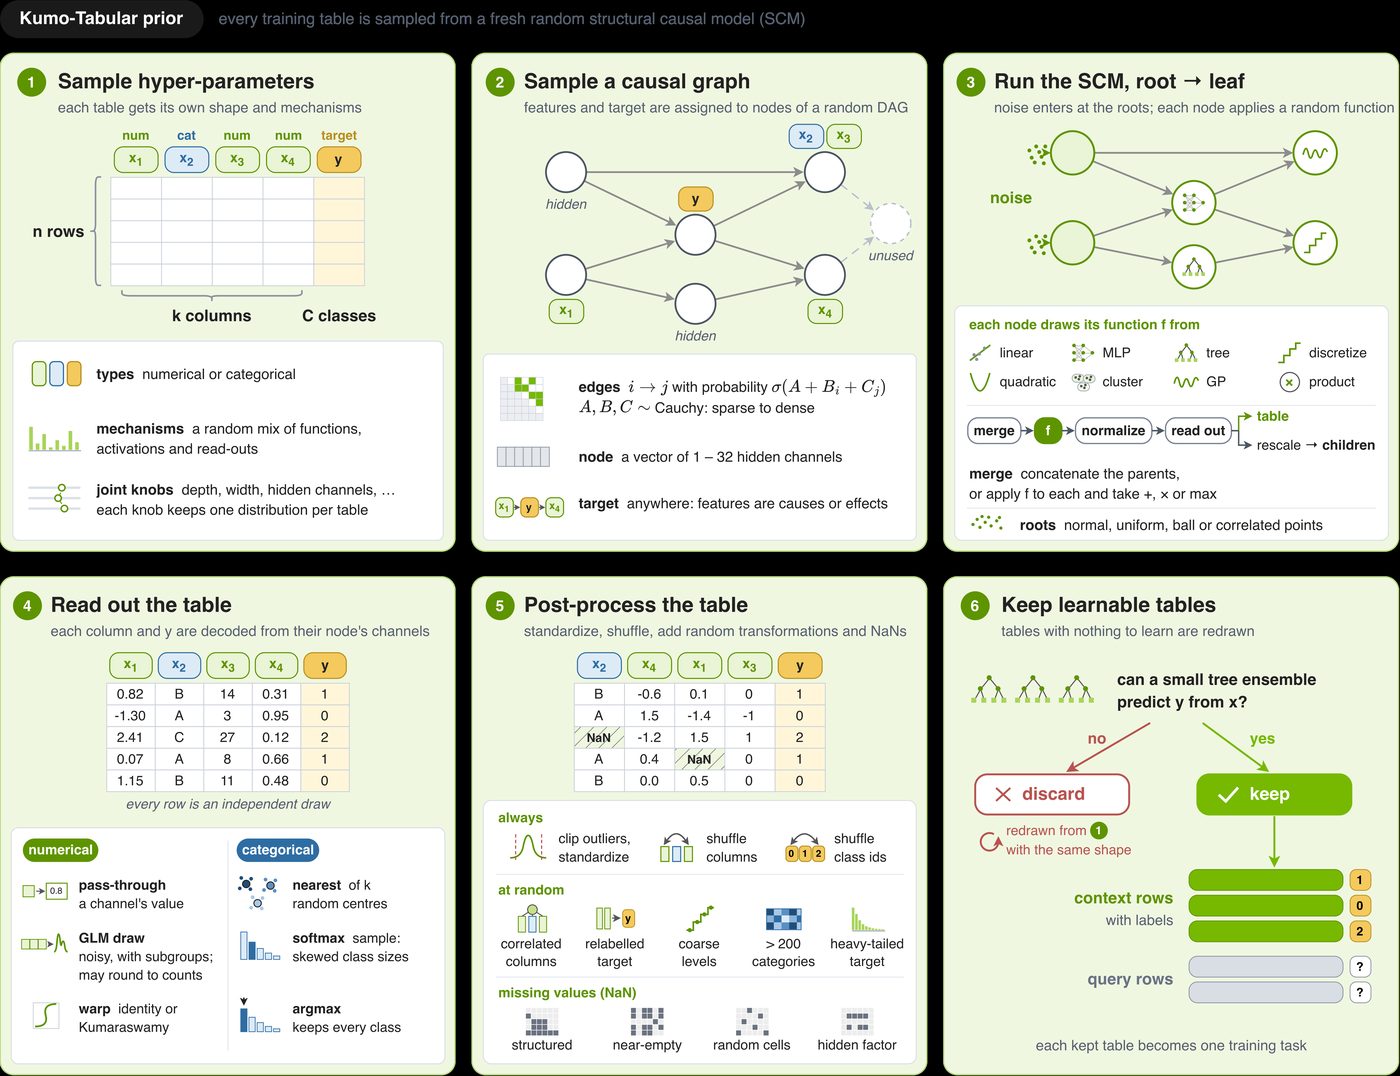
Յուրաքանչյուր մարզումային աղյուսակ գեներացվում է կառուցվածքային պատճառականության մոդելից (Structural Causal Model) և ապա մշակվում. սյունակների խմբերը հատվում են իրար հետ, եզրային արժեքները կտրվում են, աղյուսակում բացակայող տվյալները արհեստականորեն ավելացվում են, իսկ tree-ensemble ստուգումը դուրս է նետում օրինաչափությունից զուրկ մնացած աղյուսակները։ Ուսուցումն ընթացել է երեք փուլով՝ 1 024 տողով և մինչև 100 սյունակ ունեցող աղյուսակներից մինչև 400–10 240 տողով համատեքստ, իսկ վերջում՝ մինչև 60 000 տող։ Small, Medium և Large տարբերակները տեսել են մոտավորապես 35, 71 և 137 միլիոն արհեստական աղյուսակ։ Դասակարգումն ու ռեգրեսիան մարզվում են որպես առանձին մոդելներ։
Արդյունքներ
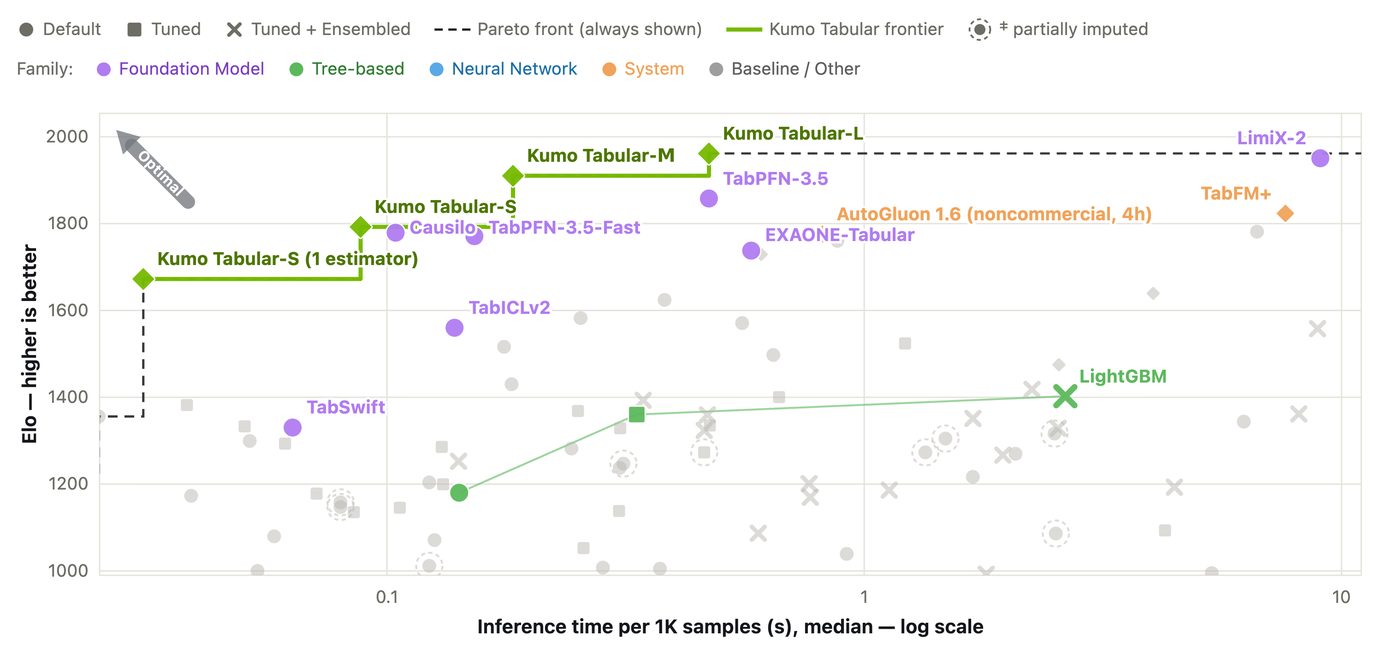
TabArena-ում Kumo Tabular-ը 1950 ELO-ով առաջին տեղում է, և ըստ NVIDIA-ի՝ մեկ RTX 6000 Pro-ի պայմաններում 17 անգամ ավելի արագ է աշխատում, քան LimiX-2-ը։ BeyondArena-ում մոդելը ստացել է 1418 ELO և 7,78% Improvability գնահատական և կրկին առաջինն է։ TALENT-ում այն ընդհանուր դասակարգման մեջ առաջինն է դասակարգման ճշգրտությամբ, log-loss-ով և ռեգրեսիայի RMSE-ով. միջին աստիճանները 6,67; 3,98 և 4,22 են։ ScoringBench-ում Kumo Tabular-Large-ը և Medium-ը միջին աստիճանով առաջին և երկրորդ տեղերում են։
Սահմանափակումներ
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։