AWS-ը WhisperX-ի կոնտեյները ներկայացրեց SageMaker AI-ի համար
AWS-ը հրապարակել է ուղեցույց WhisperX-ը Amazon SageMaker AI-ում աշխատացնելու համար։ Կոնտեյները OpenAI-ի Whisper մոդելին ավելացնում է բառային ժամանականիշներ և խոսողների առանձնացում։
AWS-ը հրապարակել է ուղեցույց, թե ինչպես աշխատացնել WhisperX-ը՝ OpenAI-ի Whisper-ի վրա հիմնված բաց կոդով խոսքի ճանաչման նախագիծը, Amazon SageMaker AI-ում։ Նյութում ներկայացված է AWS WhisperX Deep Learning Container-ը և դրա երկու աշխատեցման եղանակը։
Ինչ է ավելացնում WhisperX-ը Whisper-ին
Whisper-ը շատ լեզուներով խոսքը ճշգրիտ սղագրում է, սակայն ժամանականիշները վերադարձնում է արտահայտության մակարդակով և չի նշում, թե ով է խոսում։ WhisperX-ը ավելացնում է երեք բան՝ խմբային մշակում ավելի արագ սղագրման համար, wav2vec2-ի հարկադիր հավասարեցում բառային ժամանականիշների համար և խոսողների առանձնացում։
Կոնտեյները պարունակում է Whisper-ը, հավասարեցման մոդելները և խոսողների առանձնացման կշիռները մեկ GPU պատկերում, ուստի Hugging Face-ի թոքեն պետք չէ։ Այն աշխատում է 8080 պորտում, տրամադրում է POST /invocations և GET /ping, ընդունում է multipart/form-data՝ աուդիո ֆայլով և language, diarize դաշտերով, պատասխանը վերադարձնում է json, verbose_json, srt կամ vtt ձևաչափով։
Իրական ժամանակի՞, թե՞ ասինխրոն endpoint
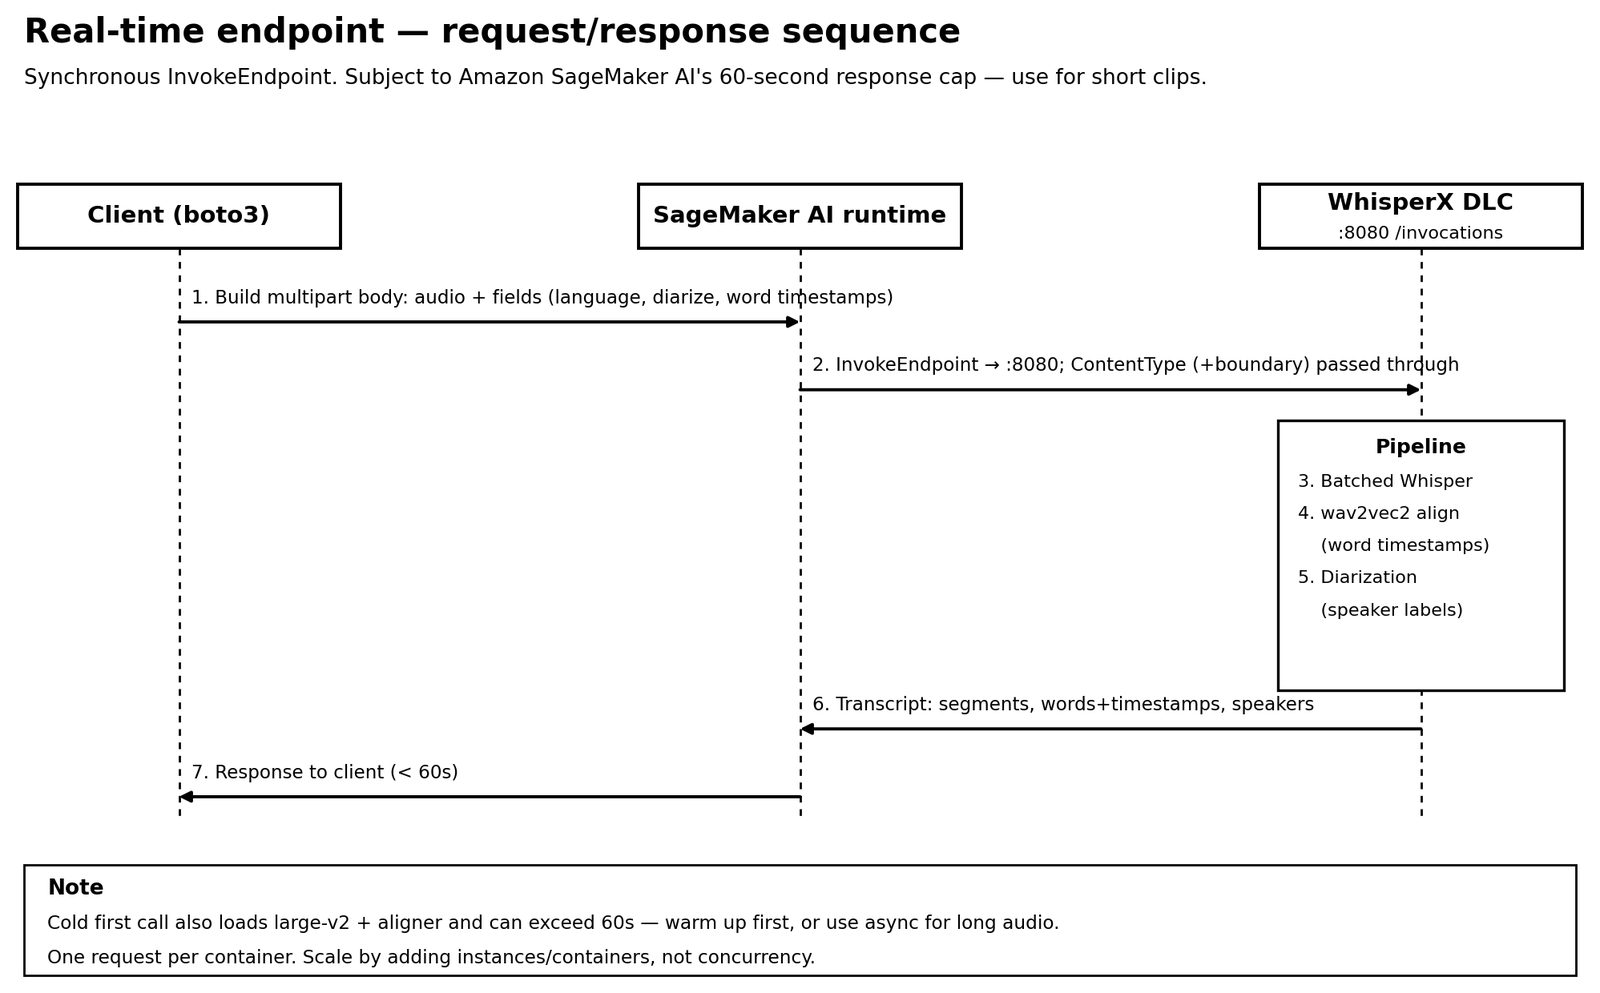
Իրական ժամանակի endpoint-ը սինխրոն է. աուդիոն ուղարկվում է հարցման մեջ, և սղագրությունը վերադառնում է նույն կանչով, ուստի հատվածը պետք է տեղավորվի SageMaker AI-ի 60 վայրկյանի սահմանում։ Այն վճարովի է, մինչև ջնջվի։
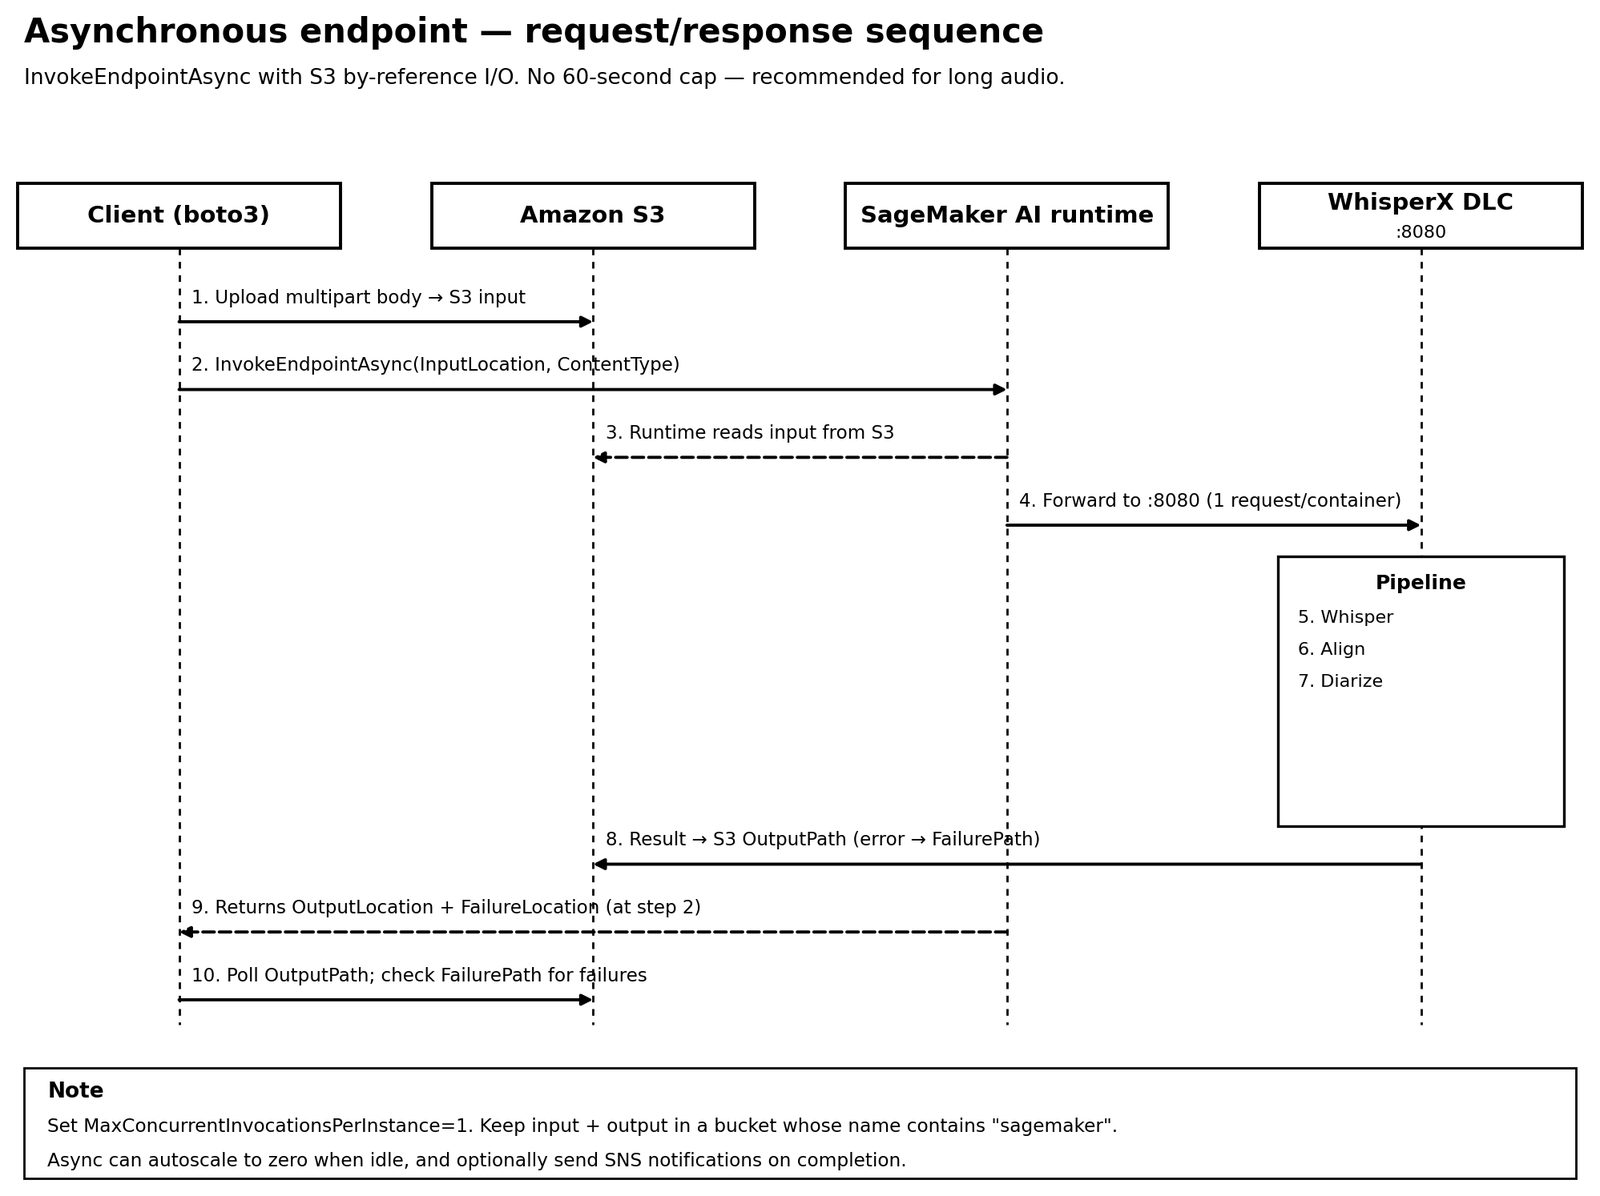
Ասինխրոն endpoint-ը աուդիոն բեռնում է Amazon S3, կանչում InvokeEndpointAsync-ը օբյեկտի հղումով և սպասում ելքի ուղուն. ձախողված առաջադրանքների համար առանձին failure ուղի կա։ Պատասխանի սահման չկա, ուստի AWS-ը այս տարբերակը խորհուրդ է տալիս երկար ձայնագրությունների և խմբային աշխատանքի համար, իսկ պարապ ժամանակ endpoint-ը կարող է կրճատվել մինչև զրո ինստանս։
Արտադրական մանրամասներ և Flight 1549-ի թեստը
Երկու տարբերակներին էլ նույն բաներն են պետք՝ ծախսի համար ml.g4dn.xlarge, ավելի շատ ռեսուրսի համար ml.g5.2xlarge, և GPU AMI-ի al2-ami-sagemaker-inference-gpu-3-1 ամրագրումը, առանց որի CUDA 12.8 պատկերը դատարկ լոգով վերադարձնում է CannotStartContainerError։ Մեկ կոնտեյները մշակում է մեկ հարցում, ուստի թողունակությունը աճում է ինստանսներով, իսկ ասինխրոն S3 bucket-ի անվան մեջ պարտադիր է sagemaker բառը։
Օրինակային notebook-ը մշակում է US Airways Flight 1549 չվերթի օդային երթևեկության ձայնագրությունը՝ ռադիոաղմուկով ու արագ կանչանշաններով. երեք րոպեն ուղարկվում է ասինխրոն endpoint-ին, 40 վայրկյանը՝ իրական ժամանակի։ AWS-ը նաև խորհուրդ է տալիս SNS ծանուցումներ polling-ի փոխարեն, մինչև հինգ ինստանսի տիպով pool և բառային ժամանականիշներով անձնական տվյալների ջնջում։ GPU endpoint-ները վճարովի են մինչև ջնջվելը։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։