Ի՞նչ է RLCD-ն. Jev-ի հետևում կանգնած պարգևատրման մոդելը
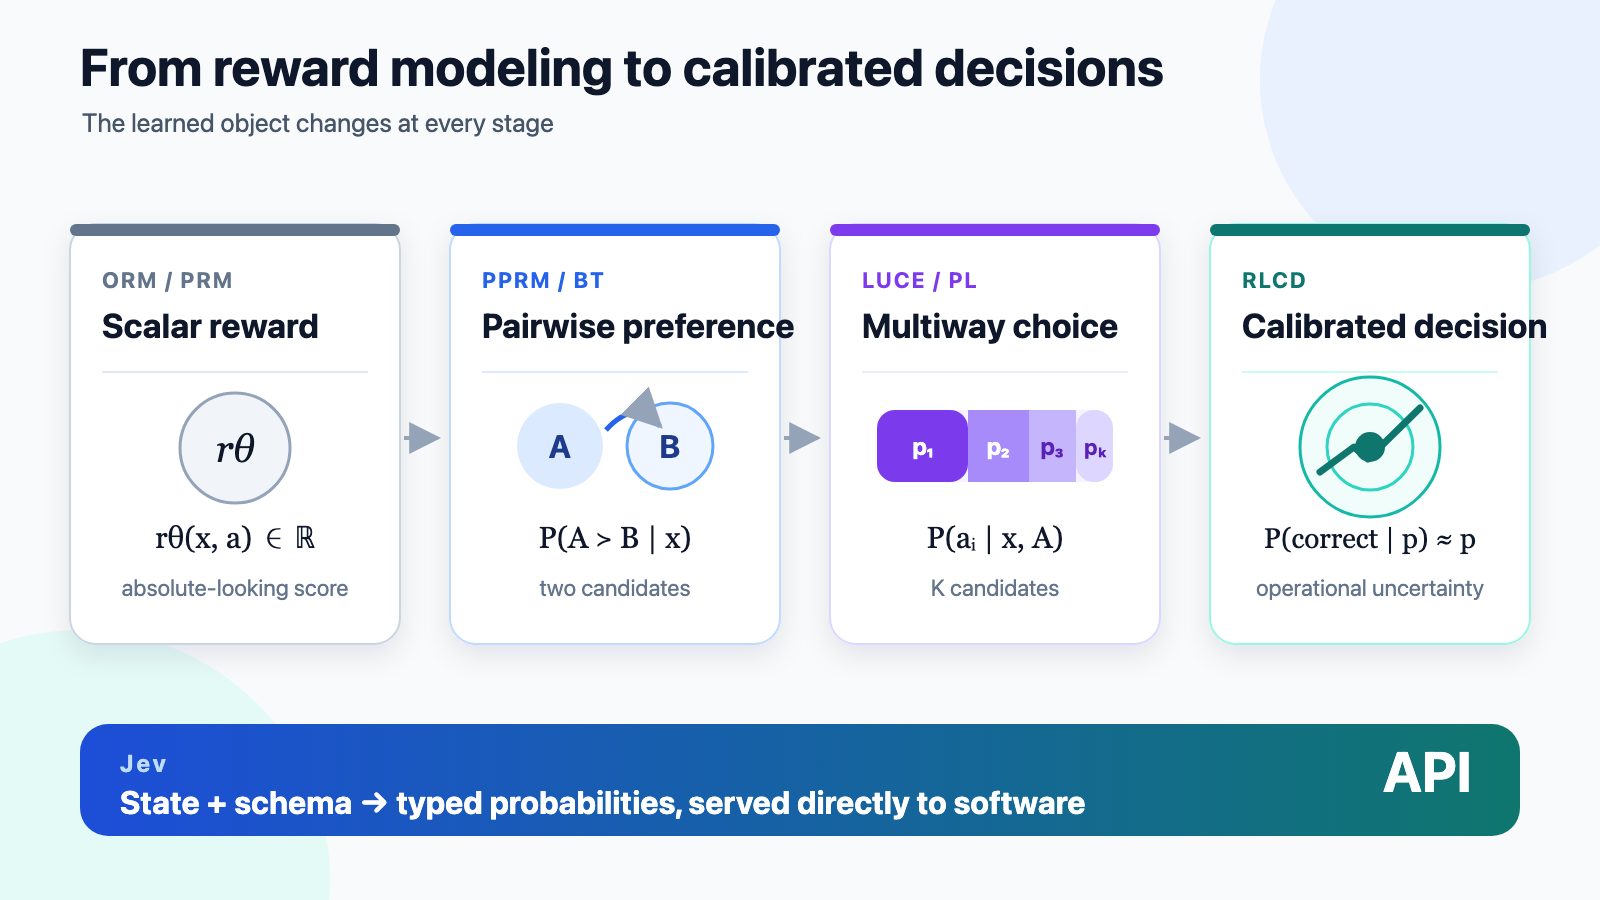
RLCD-ն սխեմայով պայմանավորված Plackett-Luce նպատակ է, որը բազմատարբերակ նախապատվությունների մոդելավորմանը ավելացնում է հավանականությունների չափաբերում։ Ըստ տեխնիկական գրառման՝ Jev-ի հետևում կանգնած պարգևատրման մոդելը այլևս չի թաքնվում գեներատորի հետևում։
di-zhang-llm բլոգի գրառումը RLCD-ն անվանում է TypeSafe-ի որոշման մոդել Jev-ի գաղտնիքը. այն բազմատարբերակ նախապատվությունների մոդելավորում գումարած հավանականությունների չափաբերում է, ավելի ճշգրիտ՝ սխեմայով պայմանավորված Plackett-Luce նպատակ։ Jev այն դարձնում է արտադրանք՝ տիպավորված ելքերով և զուգահեռ inference-ով, և պարգևատրման մոդելն այլևս չի թաքնվում գեներատորի հետևում։
Սկալյար գնահատականից մինչև նախապատվության հավանականություն
Դասական պարգևատրման մոդելը մեկ թիվ է վերադարձնում, բայց ըստ գրառման՝ այդ թիվը բացարձակ չէ. 0,8-ը կայուն իմաստ չունի խնդիրների ու թեկնածուների հավաքածուների միջև։ LLaMA-Berry-ի PPRM-ը բացահայտեց իրական ազդանշանը Bradley-Terry հավանականությամբ և մարզվեց 7,8 միլիոն մաթեմատիկական լուծումների զույգերի վրա՝ DPO-ով։
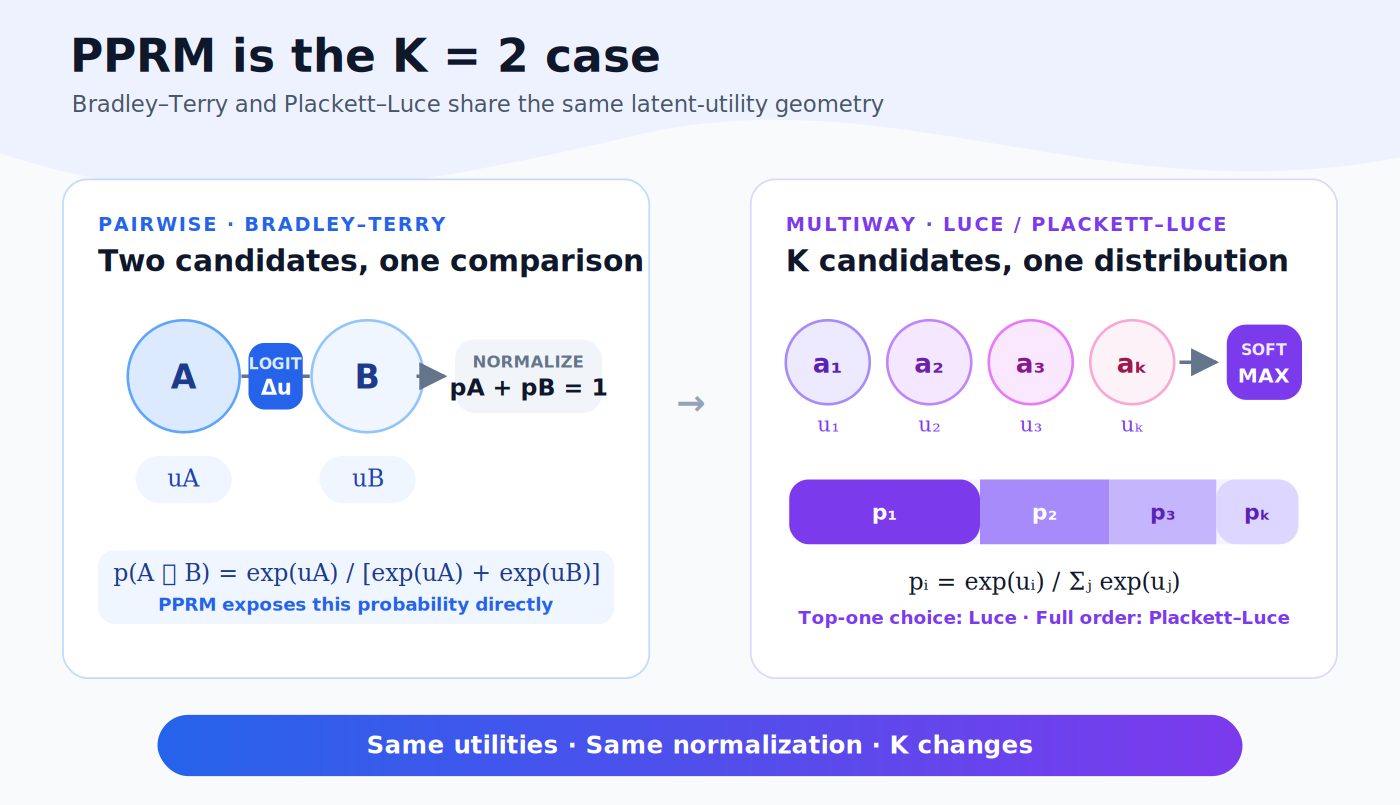
Plackett-Luce-ը բազմատարբերակ PPRM-ն է
Որոշման ինտերֆեյսները սովորաբար երկուսից ավելի թեկնածու ունեն։ Luce-ի ընտրության մոդելը, որը նաև կոչվում է multinomial logit, յուրաքանչյուր թեկնածուի համար նորմավորում է օգտակարությունը. երկու թեկնածուի դեպքում այն ճշգրտորեն վերածվում է Bradley-Terry-ի։ Ամբողջական դասավորության դեպքում Plackett-Luce-ի հավանականությունը ամեն անգամ ընտրում է հաջորդ լավագույն թեկնածուին՝ RLCD-ի մաթեմատիկական կենտրոնը։
Չափաբերումը բաշխումը դարձնում է որոշում
Նորմավորումը չափաբերում չէ. softmax-ը միշտ գումարվում է մեկի, բայց դա չի նշանակում, որ 0,8 գնահատված կանխատեսումը 80% դեպքերում ճիշտ է։ Պայմանագիրը. 0,8 հավանականություն ստացած կանխատեսումների մոտ 80%-ը պետք է ճիշտ լինի, և նույնն է խոստանում TypeSafe-ը Jev-ի համար։
Brier-ի գնահատականը գին է տալիս. p=0,8-ով հաղորդված որոշումը ստանում է 0,04 միավոր, երբ իրադարձությունը տեղի է ունենում, և 0,64՝ երբ չի ունենում, այսինքն՝ ինքնավստահորեն սխալ կանխատեսումը տասնվեց անգամ ավելի թանկ է։ Չափաբերված վստահությունն է որոշում՝ ծրագիրը կկատարի՞, կհետաձգի՞, թե՞ կփոխանցի մարդուն։
Jev-ը գնահատիչին դարձնում է ինտերֆեյս
Սովորական RLHF ստեկում պարգևատրման մոդելը մնում է հետին պլանում։ Jev-ը դա շրջում է. ներս են մտնում վիճակն ու թեկնածուների սխեման, դուրս է գալիս որոշումների բաշխում։ Noul, Choice և Score-ը մեկ օբյեկտի երեք սխեմաներ են՝ տիպավորված արդյունքի հավանականությունը վիճակի, հարցի և թեկնածուների բազմության դեպքում։
Գրառումը քննում է նաև զուգահեռ inference-ի պնդումը. բրենդինգը հանելուց հետո սեմփլերը sequence packing է՝ attention mask և տիպավորված որոշման գլուխներ, այսինքն՝ մեկ forward pass գնահատում է բոլոր թեկնածուներին առանց թոքեն-թոքեն ցիկլի։ TypeSafe-ը հայտարարում է նոր ճարտարապետություն, բայց չի հրապարակում ոչ attention օպերատոր, ոչ աբլյացիա։
Եզրակացության մեջ RLCD-ն սահմանվում է ելքի պայմանագրով՝ տիպավորված հավանականությունների բաշխմամբ։ Jev-ը հենց այն դեպքն է, երբ պարգևատրման մոդելն ինքն է դառնում արտադրանքը։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։