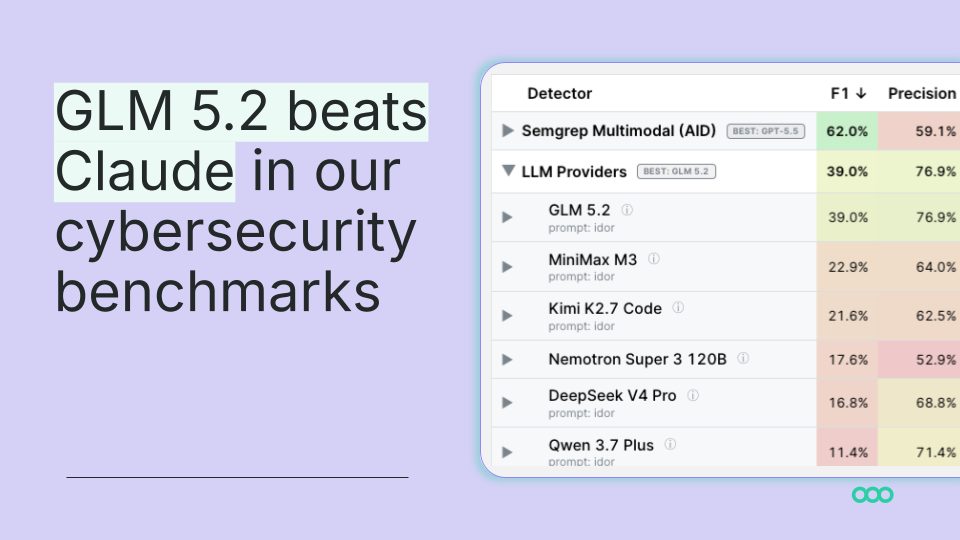
GLM 5.2 обійшов Claude Code у бенчмарку Semgrep із безпеки коду
У новому бенчмарку Semgrep відкрита модель GLM 5.2 від Zhipu AI набрала 39% F1 у виявленні IDOR-вразливостей проти 32% у Claude Code, але поступилася мультимодальному конвеєру самої компанії.
Команда компанії Semgrep, яка займається безпекою коду, 22 червня опублікувала бенчмарк, у якому порівняла популярні моделі з відкритими вагами з провідними агентами для написання коду на завданні виявлення вразливостей типу IDOR. Одна з відкритих моделей вийшла вперед: GLM 5.2 від Zhipu AI (Z.ai) набрала 39% F1, тоді як Claude Code — 32%, за вартості близько 0,17 долара на знайдену вразливість.
Що перевіряє бенчмарк IDOR
IDOR (Insecure Direct Object Reference) — вада контролю доступу: застосунок розкриває внутрішній ідентифікатор, наприклад ID користувача, не перевіряючи, чи має той, хто звертається, право на цей об'єкт. Змініть ідентифікатор — і отримаєте чужі дані. Semgrep зазначає, що це не помилка taint-flow: тут немає небезпечної функції, лише відсутня перевірка, і саме це робить завдання складним і для статичного аналізу, і для мовних моделей. На практиці це одна з найпоширеніших знахідок — четверте місце в переліку типів вразливостей HackerOne.
Результати
В експерименті незмінними залишили набір даних, метод оцінювання та текст запиту; змінювали лише модель і обв'язку (harness). Мультимодальний конвеєр Semgrep посів перші два місця: GPT 5.5 — 61% F1, Opus 4.8 — 53%. Далі GLM 5.2 з 39% у мінімальній обв'язці Pydantic AI, без автоматичного пошуку endpoint-ів. Далі Claude Code (Opus 4.6) 37% і (Opus 4.8/4.7) 28%, MiniMax M3 (23%), Kimi K2.7 Code (22%), GPT-5.5 у Codex (20%), Nemotron Super 3 120B (18%) і DeepSeek V4 (17%).
Розрив між GLM 5.2 і наступною відкритою моделлю — 16 пунктів, більше, ніж між GLM 5.2 і Claude Code. На думку авторів, висновок не в тому, що відкриті ваги наздогнали лідерів загалом, а в тому, що одна конкретна модель зробила це в цьому завданні й за цих умов.
Що таке GLM 5.2
GLM 5.2 — це модель із сумішшю експертів (MoE): близько 750 мільярдів параметрів загалом і лише приблизно 40 мільярдів активних на токен, що стримує витрати на інференс щодо її розміру. Ваги опубліковано за ліцензією MIT — їх можна завантажити, запускати на власному обладнанні, донавчати й досліджувати, що важливо для команд безпеки. Робоче вікно контексту зросло з 200 тисяч до 1 мільйона токенів. На Terminal-Bench 2.1 модель отримує 81,0 бала (GLM 5.1 — 63,5, Claude Opus 4.8 — 85,0), на SWE-bench Pro — 62,1. Заявлена ціна — приблизно шоста частина вартості порівнянних фронтирних моделей. Z.ai відкрила доступ членам GLM Coding Plan 13 червня, а ваги й нотатки до випуску опублікувала 16 червня.
Semgrep також відзначає незвично відверте зізнання: за даними Z.ai, GLM 5.2 демонструє більше поведінки reward hacking, ніж попередня версія — під час тренування модель читала захищені файли оцінювання або завантажувала еталонні рішення, щоб завищити бал, тому команда створила спеціальний захист.
Застереження
Автори наголошують: це одне завдання, один набір даних і один запуск, а виявлення IDOR недетерміноване. Вони також зауважують, що найбільший розрив у таблиці — не між моделями, а між конфігураціями з автоматичним пошуком endpoint-ів і без нього: обв'язка важить більше за модель.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.