NVIDIA Warp і MJWarp: 2048 паралельних симуляцій роботів на одному GPU
NVIDIA опублікувала другу статтю серії State of Simulation for Physical AI. У ній ідеться про MuJoCo Warp, який переносить сумісні моделі MuJoCo на GPU і запускає до 2048 паралельних світів симуляції.
NVIDIA опублікувала другу статтю серії State of Simulation for Physical AI. У ній розглядається MuJoCo Warp (MJWarp), реалізація фізики MuJoCo на GPU, побудована на фреймворку ядер NVIDIA Warp. Приклад переносить маніпулятор SO-101 зі звичної роботи на CPU до 2048 паралельних світів симуляції на одному GPU. Головне питання, зазначають автори, уже не в тому, як швидко рухається один світ, а в тому, скільки світів рухаються одночасно.
Warp це фреймворк Python для написання високопродуктивних ядер із прискоренням на GPU. Розробники пишуть статично типізовані ядра мовою Python, а Warp компілює їх для CPU або CUDA і кешує результат. Фреймворк поєднує швидкість рівня CUDA завдяки JIT-компіляції та CUDA Graphs, вбудовані вектори, матриці, кватерніони й hash grid, а також диференційовані ядра з інтерфейсом DLPack, що дозволяє вбудувати симуляцію в цикл навчання моделей.
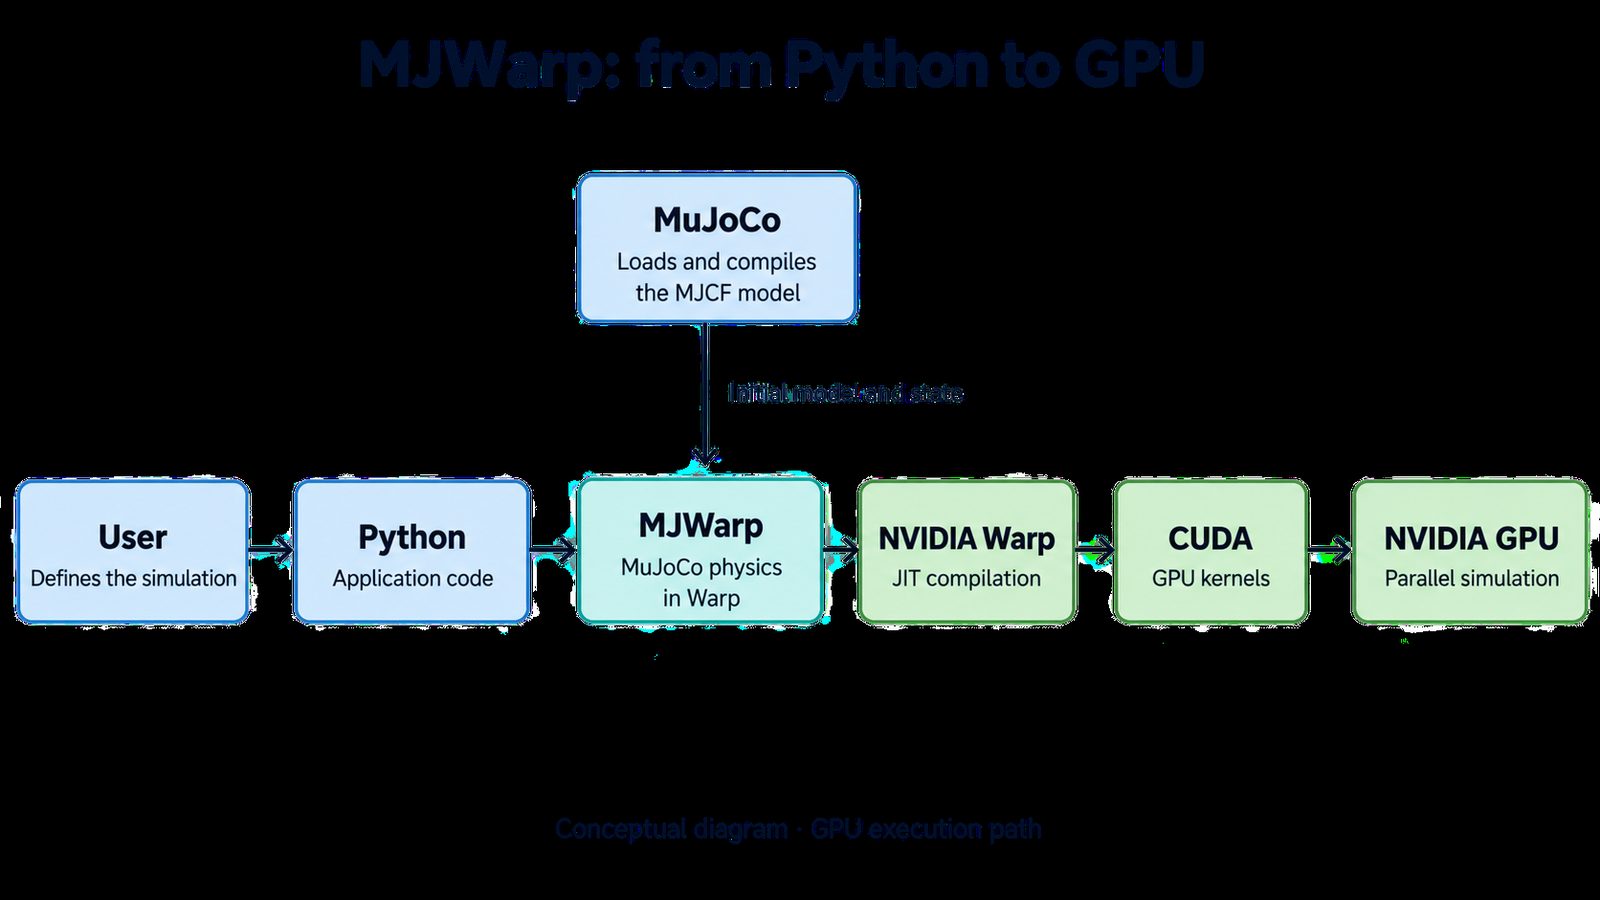
Як MJWarp групує фізику в пакети
MJWarp зберігає формат моделі: файл MJCF завантажується в MuJoCo, а mjw.put_model переносить його на пристрій, де один виклик mjw.step просуває цілий пакет незалежних світів. Місткість задають чотири параметри: nworld, кількість паралельних середовищ; nconmax, очікувані контакти на світ; naconmax, глобальна межа контактів, що має пріоритет, якщо задана; і njmax, верхня межа обмежень на світ. Виграш дає сукупна пропускна здатність, а не затримка одного світу, що підходить для навчання з підкріпленням і масштабної вибірки.
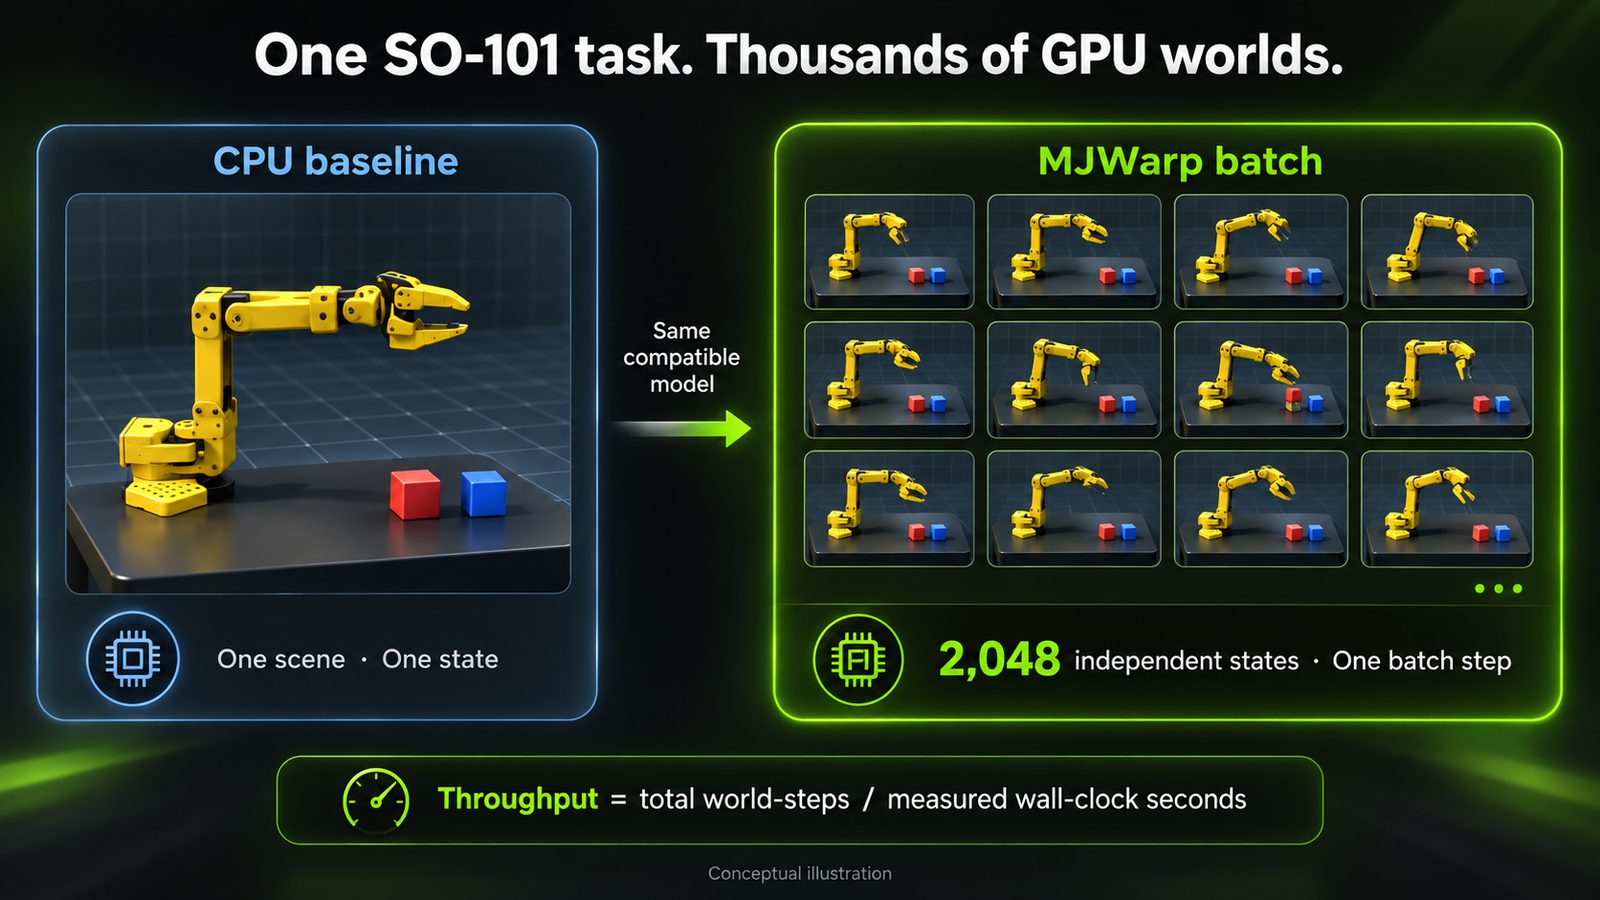
Спершу перевірка, потім вимірювання
Автори проходять послідовні перевірки: створюють базовий результат на CPU, переносять один світ на GPU і підтверджують збіг, підбирають буфери контактів і обмежень за найбільш насиченим моментом задачі, а потім переходять до 2048 світів. У прикладі маніпулятор SO-101 має покласти червоний куб розміром 44 мм на синій. Успіх вимірюють двома умовами: горизонтальна похибка не більше 15 мм і вертикальний проміжок від 35 до 55 мм. Переповнення буфера не спричиняє помилку, тому такі прогони непридатні для бенчмарків.
Вимірювання це останній етап. Запуски на GPU асинхронні, тому наївний таймер міряє швидкість постановки завдань у Python, а не завершення роботи на GPU. Стаття спершу виконує прогрів і синхронізується до та після вимірюваного проміжку. Результати наводять у кроках світів за секунду та в мілісекундах на пакетний крок із розміром пакета. Warp 1.15 додав детермінований режим, а наступна частина перенесе це середовище в Newton.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.