NVIDIA випустила відкриту модель Kumo Tabular для табличного прогнозування
NVIDIA випустила Kumo Tabular — відкриту базову модель, яка прогнозує підписи нових рядків одним проходом вперед без навчання й підготовки ознак та посідає перше місце на чотирьох бенчмарках у табличних задачах.
NVIDIA 29 вересня випустила Kumo Tabular. Це відкрита базова модель для табличних даних, що входить до колекції NVIDIA Kumo Structured. Ваги доступні на Hugging Face, а код — у відкритій бібліотеці компанії (structured-data-models). Модель поширюється за ліцензією OpenMDW-1.1, що дозволяє комерційне використання.
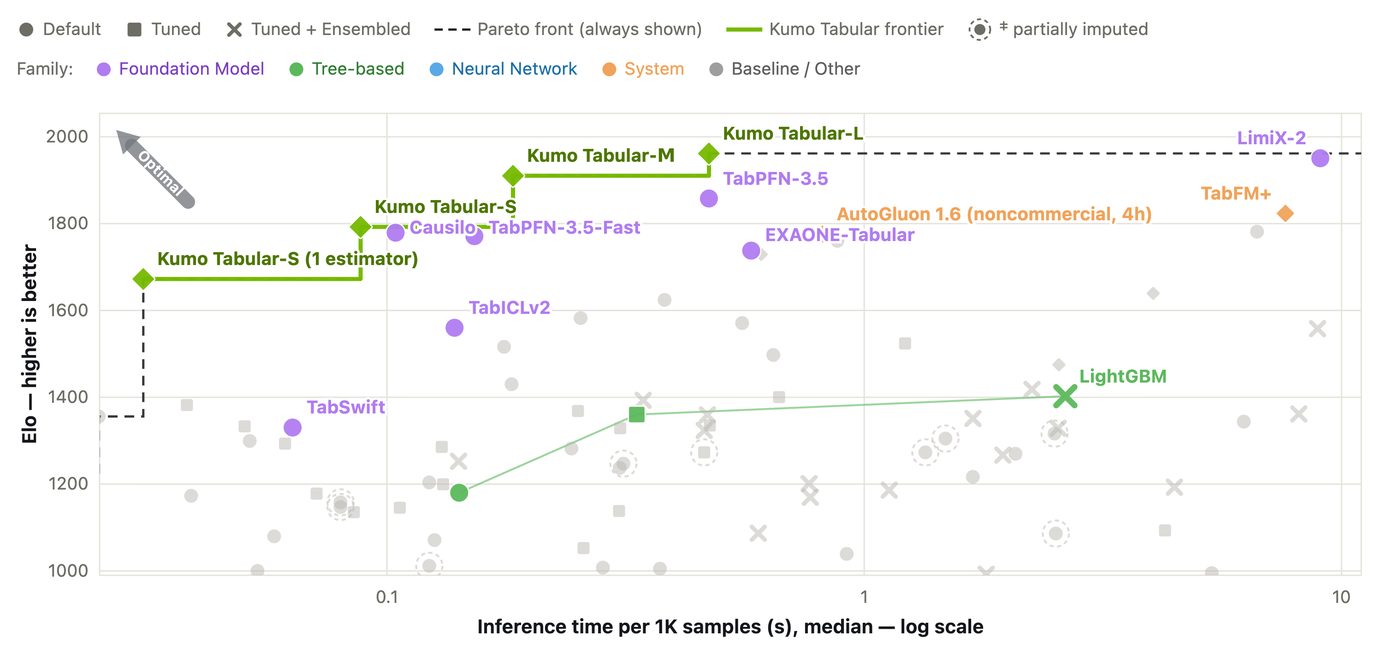
Моделі подають таблицю з підписаними рядками, і вона повертає підписи нових рядків одним проходом вперед: без навчання, донавчання й підготовки ознак, як для класифікації, так і для регресії. Модель існує у трьох розмірах — від 28 мільйонів до 215 мільйонів параметрів — і тренувалася лише на штучних таблицях.
Як це працює
Kumo Tabular — це трансформер, побудований навколо структури таблиці: він використовує увагу до стовпців, рядків і контексту, подібно до підходу TabICL і TabPFN. Кожне значення оцінюється в розподілі свого стовпця, взаємодія ознак усередині рядка фіксується, а рядки з відомими підписами зв’язуються з новими рядками. Контекст ніколи не дивиться на запити, тому його ключі обчислюються один раз і багаторазово використовуються для подальших прогнозів. Числові та категоріальні дані проходять через ознаки Fourier, а пропущені значення не потребують заповнення. Температура уваги зростає разом із логарифмом кількості ключів, щоб залишатися різкою на більших таблицях.
Навчання на штучних даних
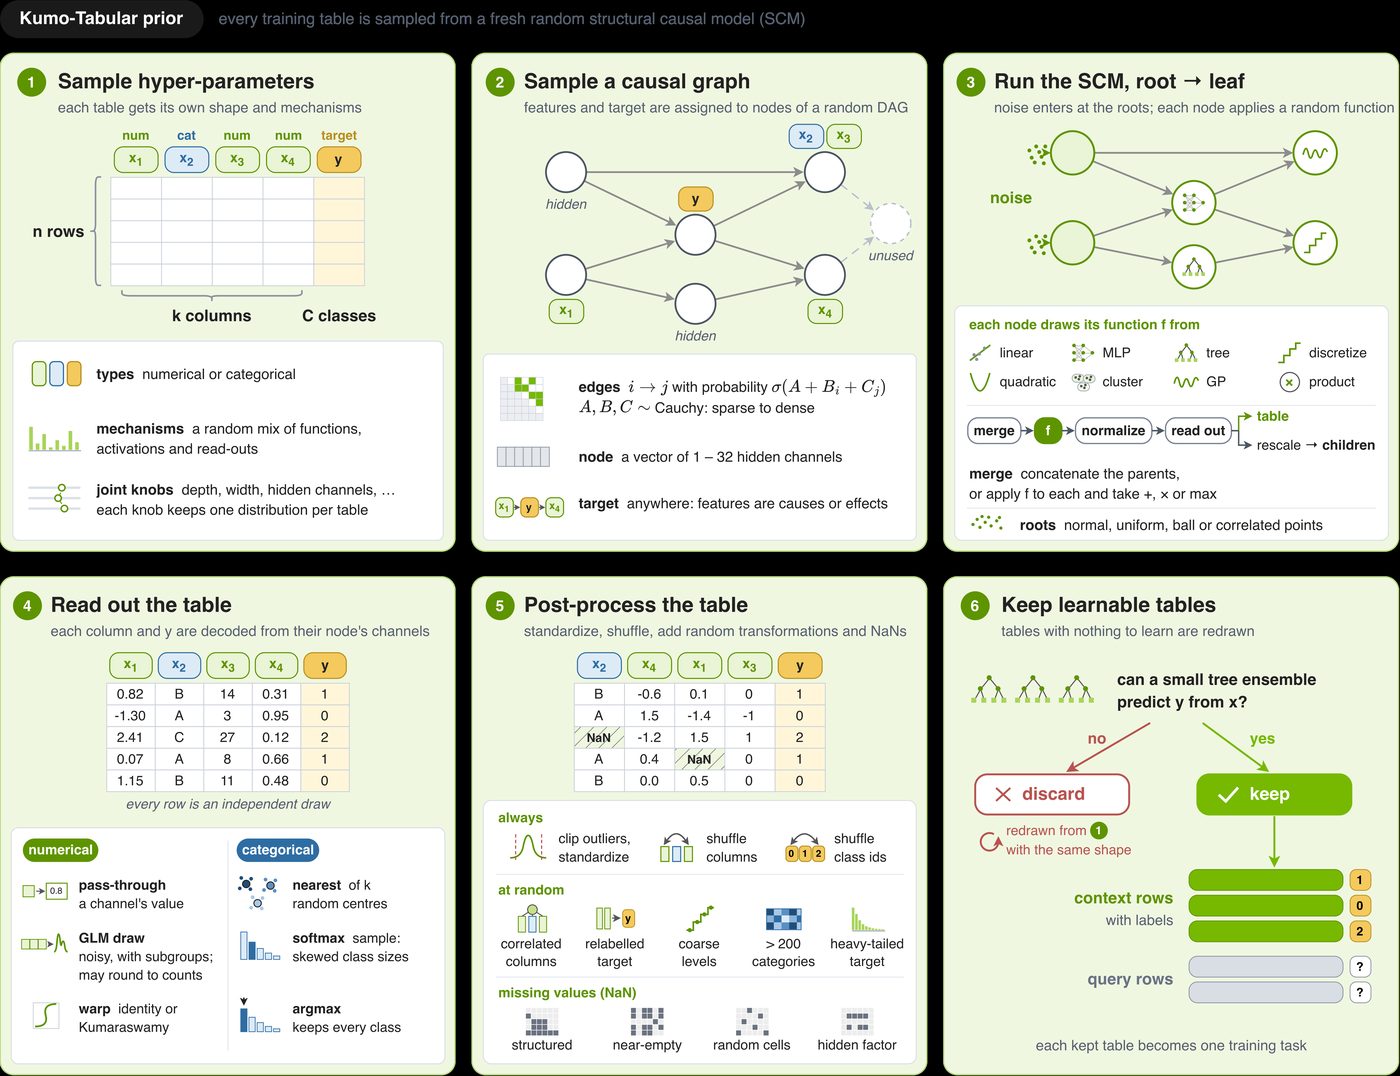
Кожна тренувальна таблиця генерується з моделі структурної причинності (Structural Causal Model) і потім обробляється: групи стовпців перетинаються між собою, крайні значення обрізаються, пропущені дані штучно додаються до таблиці, а перевірка tree-ensemble відкидає таблиці, що залишилися без закономірності. Навчання відбувалося у три етапи: від таблиць із 1 024 рядками та до 100 стовпців до контексту з 400–10 240 рядків, а зрештою — до 60 000 рядків. Версії Small, Medium і Large побачили приблизно 35, 71 і 137 мільйонів штучних таблиць. Класифікація та регресія тренуються як окремі моделі.
Результати
На TabArena Kumo Tabular посідає перше місце з 1950 ELO і, за заявою NVIDIA, в умовах однієї RTX 6000 Pro працює у 17 разів швидше за LimiX-2. На BeyondArena модель отримала 1418 ELO та оцінку Improvability 7,78% і знову перша. На TALENT вона перша в загальному ранжуванні за точністю класифікації, log-loss і RMSE регресії; середні ранги — 6,67; 3,98 і 4,22. На ScoringBench Kumo Tabular-Large і Medium посідають перше та друге місця за середнім рангом.
Обмеження
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.