NVIDIA додала багатопристроєвий інференс TensorRT у Dynamo-Triton
Dynamo-Triton 26.07 дозволяє одному екземпляру моделі Triton володіти кількома GPU — генерація відео Cosmos 3 Nano скоротилася з 156.6 до 34.2 секунди на восьми GPU.
NVIDIA вбудувала підтримку багатопристроєвого інференсу TensorRT у Dynamo-Triton, тож тепер застосунку не потрібно самостійно координувати ранги GPU.
Що змінилося
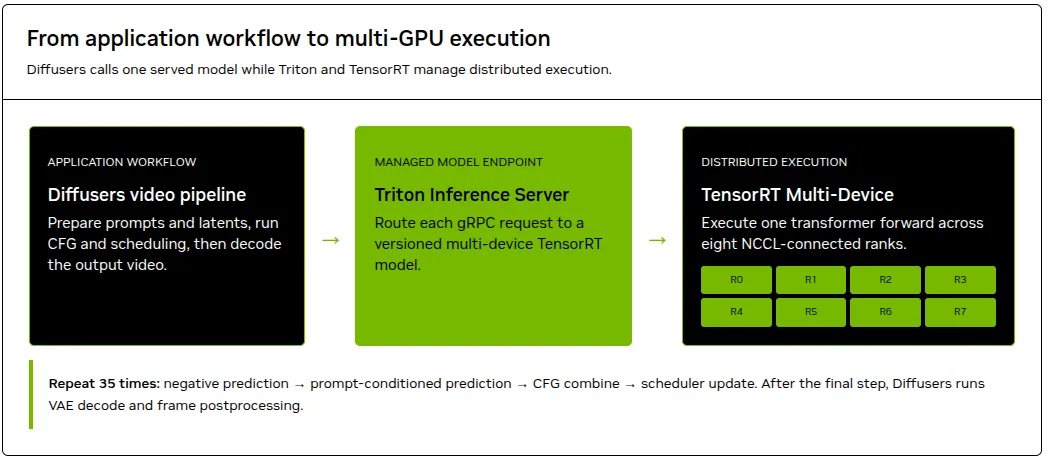
Багатопристроєвий інференс TensorRT дає змогу одній мережі TensorRT виконуватися на кількох GPU за допомогою розподілених колективних операцій на базі NCCL, зберігаючи оптимізації інференсу TensorRT. Dynamo-Triton (раніше Triton Inference Server) вмикає цю можливість у випуску 26.07, і тепер один екземпляр Triton KIND_MODEL може володіти кількома GPU: він створює для кожного рангу контексти виконання, потоки CUDA та комунікатори NCCL, а далі запускає ранги разом на кожен запит одним викликом gRPC.
Як працює шлях обслуговування
Інтеграцію продемонстрували на генерації відео Cosmos 3 Nano: Diffusers далі керує оточенням, а Dynamo-Triton обслуговує 36-шаровий трансформер денойзингу. Багатопристроєвий інференс TensorRT за допомогою контекстного паралелізму Ulysses розподіляє 44 160 відеотокенів між вісьмома GPU.
Розподілений граф компілюється в кожен план TensorRT ще до розгортання, тому конфігурація Triton активує контекстно-паралельний план, а не перетворює одно-пристроєвий рушій. На одному GPU трансформер займає 93.4% часу генерації, і оскільки кожен із 35 кроків денойзингу потребує двох прогнозів для classifier-free guidance, проксі Diffusers робить 70 RPC трансформера на генерацію.
Результати затримки
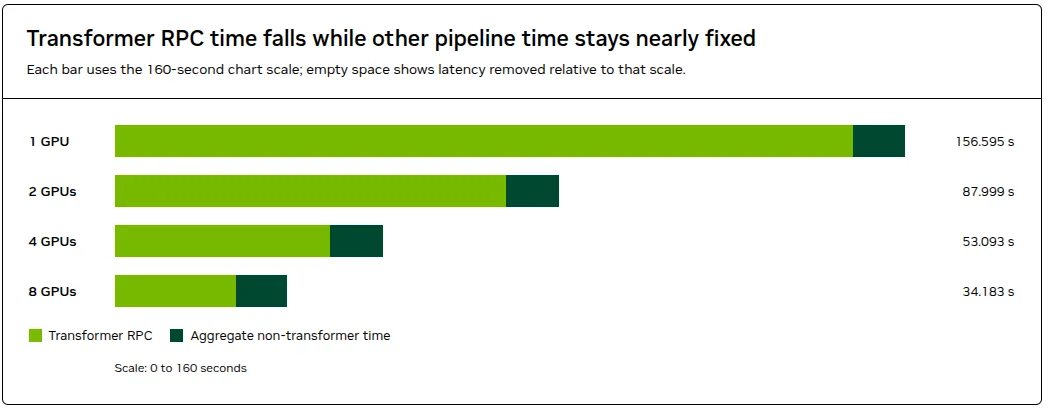
Усі чотири варіанти запускали на одній системі з вісьмома GPU: 1280x720, 189 кадрів при 24 FPS та п'ять виміряних генерацій. Наскрізна затримка впала з 156.595 секунди на одному GPU до 87.999 на двох, 53.093 на чотирьох і 34.183 секунди на восьми — зменшення на 78.17%. Час RPC трансформера скоротився на 83.59%, його частка впала з 93.4% до 70.2%, а час поза цим шляхом залишався в межах 10.2–10.5 секунди в усіх конфігураціях.
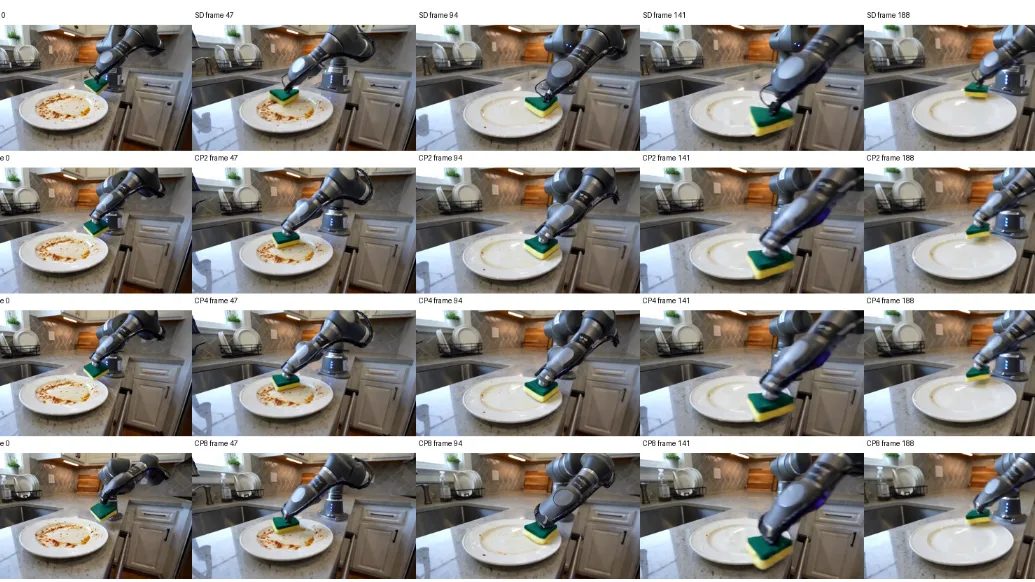
Під час перевірки кожен контекстно-паралельний результат порівнювали з одно-пристроєвим за того самого seed: CP2 і CP4 показали середню абсолютну похибку 12.759 та PSNR 21.111 dB, CP8 — MAE 16.316 і PSNR 19.400 dB, усі в межах порогів. NVIDIA не стверджує, що результати ідентичні до пікселя.
Компроміси
Командам усе одно доведеться зважувати додаткові ресурси GPU проти коротшої затримки. Бенчмарк не вимірює пропускну здатність за одночасних запитів, вартість одного відео чи сукупну вартість володіння — ці метрики варто перевіряти проти власних SLO. Dynamo-Triton 26.07 доступний в NGC.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.