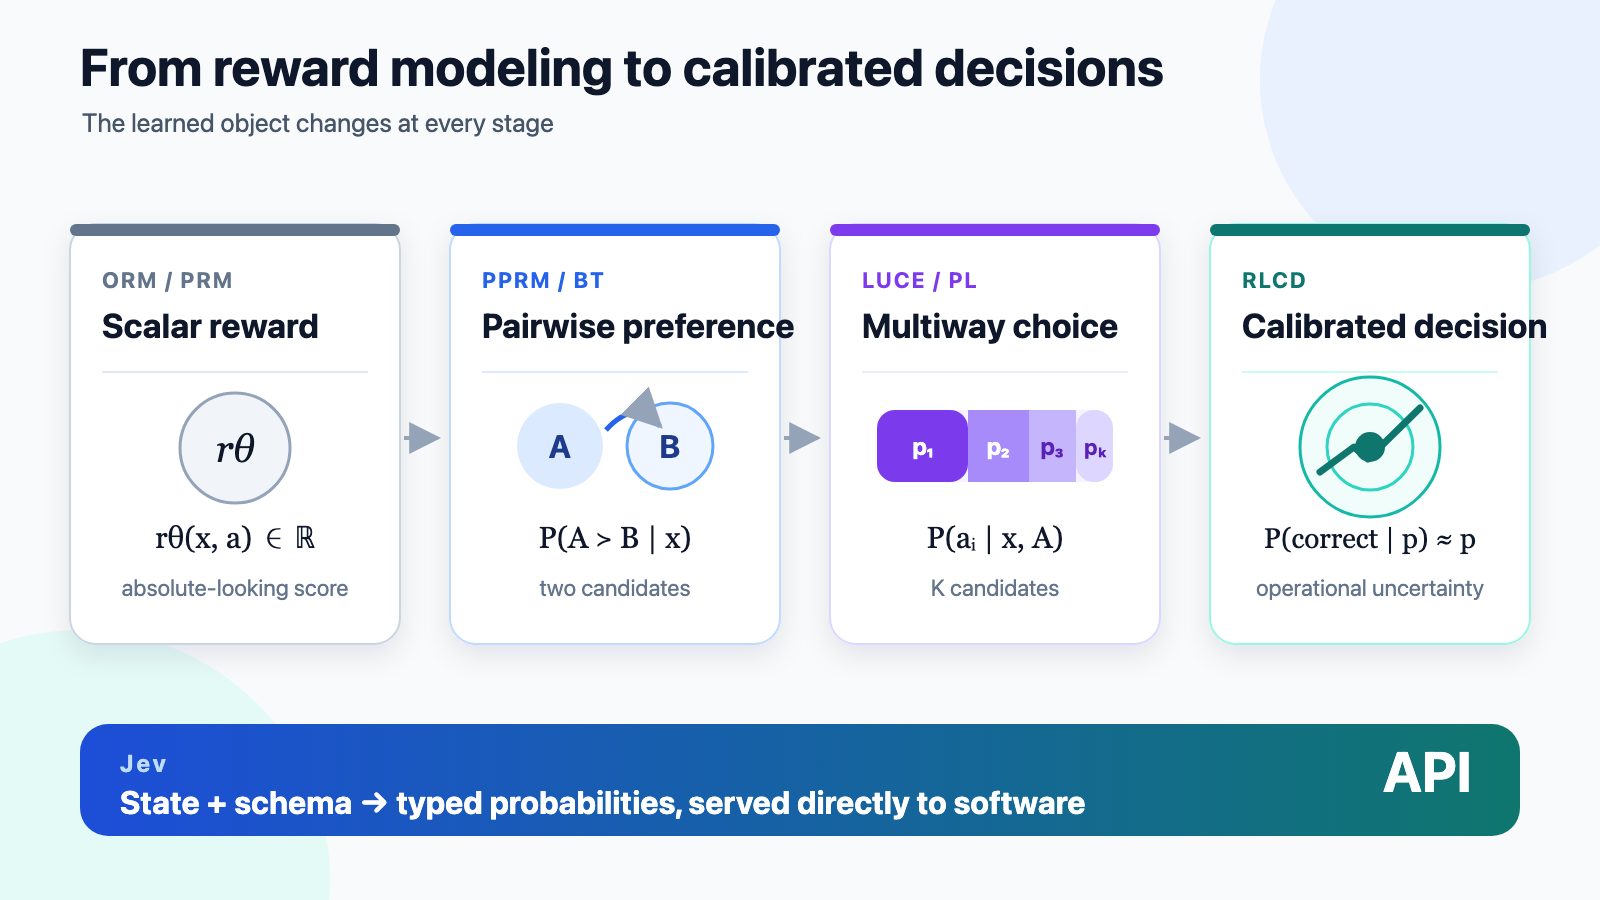
Що таке RLCD: чому модель винагород стала самим продуктом
RLCD — це обумовлена схемою цільова функція Plackett-Luce, яка додає до багатоваріантного моделювання переваг калібрування ймовірностей. За словами автора технічного розбору, модель винагород Jev більше не ховається за генератором, а стає продуктом.
Технічний допис у блозі di-zhang-llm називає RLCD секретом Jev, моделі ухвалення рішень від TypeSafe: це багатоваріантне моделювання переваг плюс калібрування ймовірностей, точніше, обумовлена схемою цільова функція Plackett-Luce. Jev перетворює її на продукт завдяки типізованим виходам і паралельному inference, і модель винагород більше не ховається за генератором: вона й стає моделлю.
Від скалярної оцінки до ймовірності переваги
Класична модель винагород повертає одне число для контексту й відповіді-кандидата, але, за автором, воно не абсолютне: 0,8 не має стабільного значення для різних задач чи наборів кандидатів. Pairwise Preference Reward Model (PPRM) від LLaMA-Berry унаочнила справжній сигнал ймовірністю Bradley-Terry: її навчали майже на 7,8 мільйона пар математичних розв'язків із DPO.
Plackett-Luce як багатоваріантний PPRM
Інтерфейси рішень зазвичай мають більше двох кандидатів. Модель вибору Luce, вона ж multinomial logit, нормалізує корисність для кожного кандидата; для двох кандидатів вона точно зводиться до Bradley-Terry. За наявності повного ранжування правдоподібність Plackett-Luce щоразу обирає наступного найкращого кандидата, і це автор називає математичним центром RLCD.
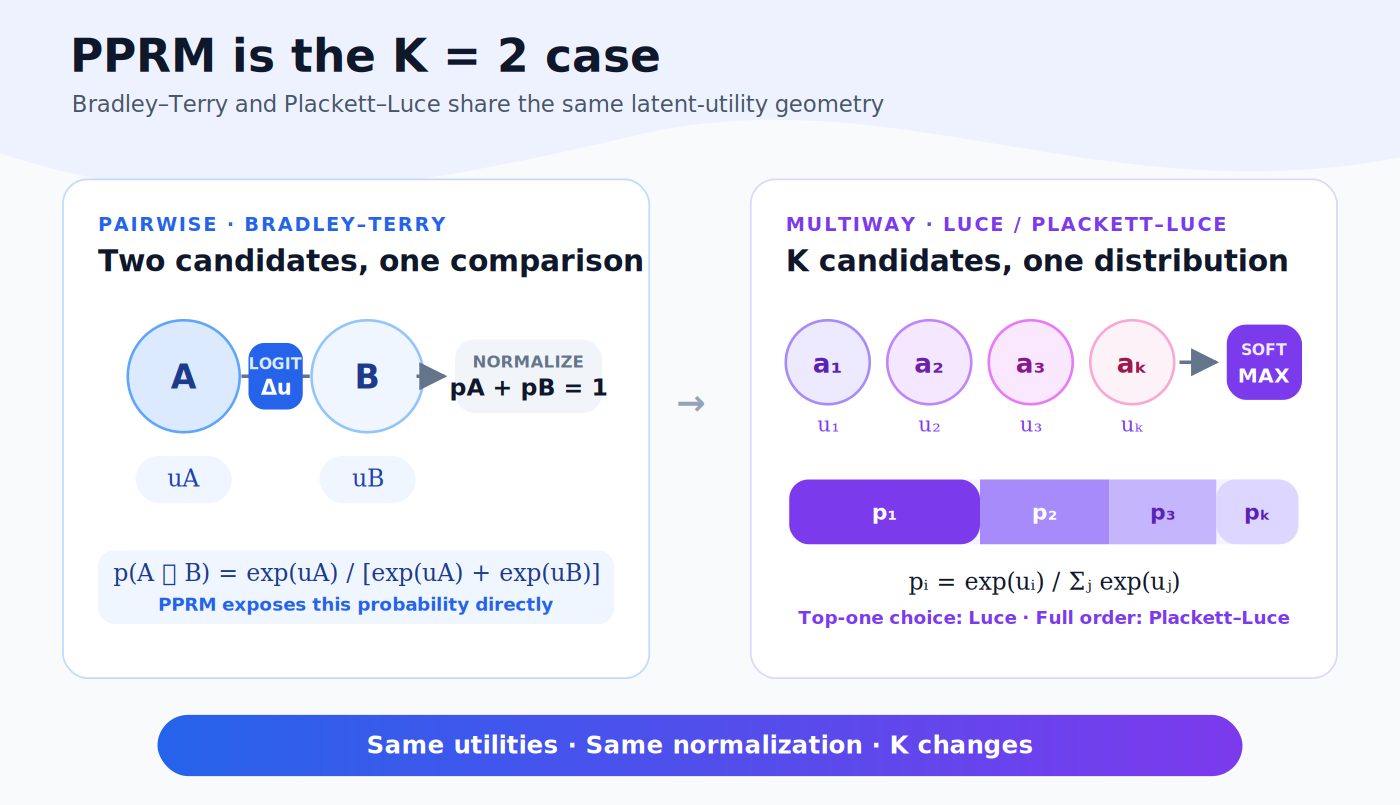
Калібрування перетворює розподіл на рішення
Нормалізація не є калібруванням: softmax завжди сумується до одиниці, але це не означає, що прогноз з оцінкою 0,8 правильний у 80% випадків. Контракт такий: серед прогнозів з імовірністю 0,8 приблизно 80% мають бути правильними, і, за словами автора, те саме TypeSafe обіцяє для Jev.
Оцінка Brier дає цій меті ціну: рішення з p=0,8 отримує 0,04 бала, коли подія сталася, і 0,64, коли ні, тож упевнено помилковий прогноз коштує у шістнадцять разів дорожче за впевнено правильний. Калібрована впевненість визначає, чи виконати рішення чи передати людині.
Jev робить оцінювач інтерфейсом
У звичайному стеку RLHF модель винагород залишається на задньому плані, за генератором. Jev це перевертає: на вході стан і схема кандидатів, на виході калібрований розподіл рішень. Noul, Choice і Score — три схеми над одним об'єктом: імовірність типізованого результату за заданих стану, питання та набору кандидатів.
Автор також розбирає заяву про паралельний inference: без брендування семплер — це sequence packing, attention mask і типізовані голови рішень, тож один forward pass оцінює всіх кандидатів без поколінного циклу. TypeSafe анонсує нову архітектуру, але не публікує ні нового attention-оператора, ні абляції.
У висновку RLCD визначає контракт виходу, типізований розподіл імовірностей. Jev — це випадок, коли модель винагород перестає оцінювати продукт і стає продуктом.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.