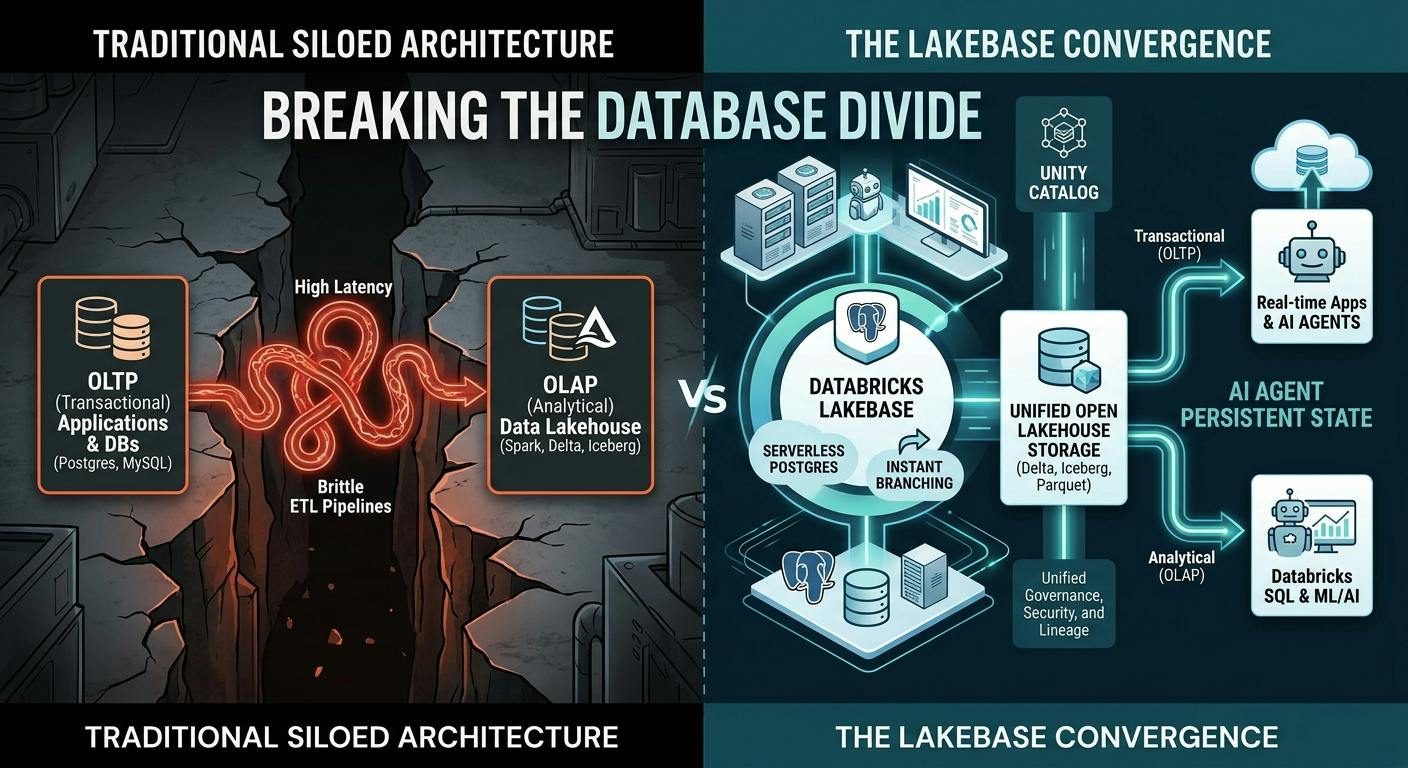
Lakebase від Databricks стирає межу між транзакціями та аналітикою
Аналіз, опублікований на HackerNoon, стверджує, що Lakebase — серверлес-рушій Postgres від Databricks, побудований на відкритому lakehouse, — усуває тридцятирічний поділ між OLTP та OLAP і дає AI-агентам постійне сховище стану.
Понад три десятиліття корпоративні архітектури даних трималися жорсткого розподілу праці: транзакційні системи на кшталт PostgreSQL, MySQL та Oracle відповідали за стан застосунків у реальному часі, а аналітичні рушії Apache Spark, Snowflake і Delta Lake зберігали історичні дані та виконували важкі трансформації й задачі ML.
Між ними лежали крихкі та дорогі ETL-конвеєри: компанії будували складну синхронізацію, щоб переносити операційні дані в аналітичний lakehouse, а потім насилу повертали ознаки в застосунки. В аналізі на HackerNoon автор стверджує, що Lakebase від Databricks — серверлес-рушій Postgres на технології Neon, побудований на відкритому lakehouse, — руйнує цю стіну.
Третє покоління баз даних
Автор відносить Lakebase до нової категорії, а не до чергового керованого екземпляра Postgres. Раніші бази були монолітами або хмарними системами з пропрієтарним сховищем; Lakebase описано як третє покоління — сховище у відкритому форматі просто на озері плюс серверлес-обчислення Postgres.
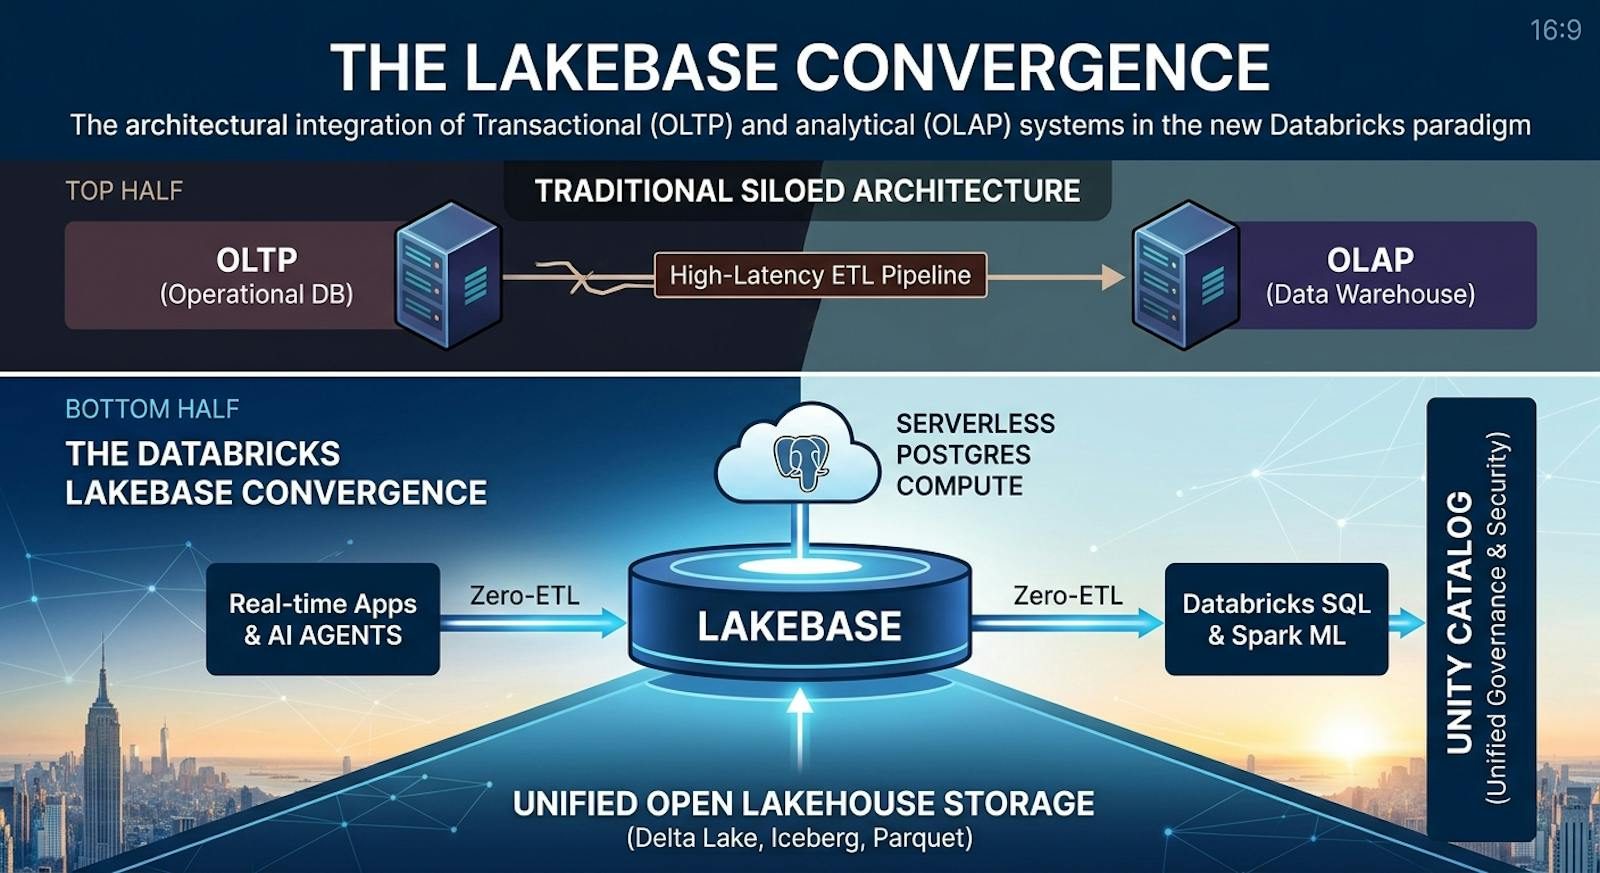
Розгалуження, scale-to-zero та zero-ETL
Три архітектурні властивості. Копіювальне розгалуження (copy-on-write) створює повноцінні ізольовані клони бази за мілісекунди замість годин чи днів, потрібних традиційним середовищам для клонування продакшн-даних, тож розробники та AI-агенти можуть тестувати зміни схеми й миттєво прибирати середовища.
Розділені обчислення дозволяють екземплярам Lakebase запускатися менш ніж за секунду та згортатися до нуля в простої, переводячи пікові навантаження агентів на оплату за споживання. А оскільки транзакційні дані записуються у форматах, які lakehouse читає, командам більше не потрібні CDC- чи ETL-конвеєри для аналітичних запитів або наповнення feature store для LLM: Spark, Databricks SQL і Delta Lake читають живі дані напряму.
Що це означає для інженерів даних та AI
За єдиного управління транзакційні й аналітичні таблиці підпадають під один набір контролю доступу, політик безпеки та відстеження походження через Unity Catalog. Автор називає й пам'ять AI-агентів: агентам потрібні керування станом, векторний пошук через pgvector і швидкі транзакційні вибірки.
Висновок — це напрям, а не готовий продукт: коли підприємства переходять від простого ML-висновування до автономних агентів і конвеєрів реального часу, база даних під ними має розвиватися — до відкритих, реального часу, серверлес і AI-природних платформ.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.