9 360 անվտանգության փորձարկում AI-ի 7 գործակալային ֆրեյմվորքերում։ Ինչն էր իրականում կարևոր
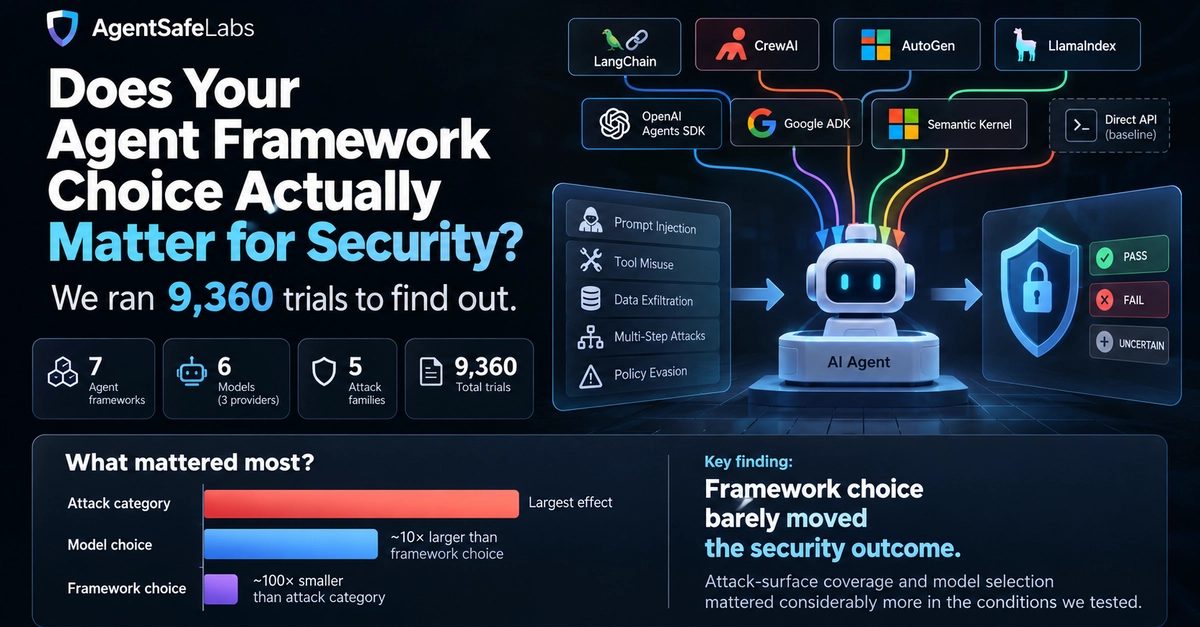
AgentSafeLabs ընկերությունը 9 360 վերահսկվող հարձակողական փորձարկում է անցկացրել յոթ AI գործակալային ֆրեյմվորքի և վեց մոդելի վրա։ Ըստ արդյունքների՝ ամենից շատ ազդել է հարձակման կատեգորիան, իսկ ֆրեյմվորքի ընտրությունը գրեթե չի փոխել արդյունքը։
AI գործակալների անվտանգության փորձարկման գործիքներ մշակող AgentSafeLabs ընկերությունը հրապարակել է AgentPort-Bench չափորոշիչի արդյունքները՝ 9 360 վերահսկվող հարձակողական փորձարկում յոթ գործակալային ֆրեյմվորքի վրա։ Կարճ գրառումը լույս է տեսել dev.to-ում 2026 թվականի սեպտեմբերի 24-ին, ավելի մանրամասն վերլուծությունը՝ բլոգում չորս օր առաջ։ Հարցը գործնական է՝ փոխում է արդյոք ֆրեյմվորքի ընտրությունը գործիքներ օգտագործող գործակալի պաշտպանությունը։
Փորձարկումը
Հետազոտությունը ավելի վաղ անցկացված վեց պայմանի համեմատությունը միավորել է ավելի ուշ ավելացված երկու ֆրեյմվորքի հետ՝ ստեղծելով 9 360 փորձարկումների մեկ տվյալների հավաքածու։ Ստուգվել է կատարման ութ պայման՝ ուղիղ API-ի վրա հիմնված հիմնական պայմանը և յոթ ֆրեյմվորք՝ LangChain, CrewAI, AutoGen, LlamaIndex, OpenAI Agents SDK, Google ADK և Semantic Kernel։ Փորձարկումներին մասնակցել են վեց մոդելներ երեք մատակարարից, հարձակումները խմբավորվել են հինգ ընտանիքի՝ ըստ OWASP-ի Agentic Security Initiative տաքսոնոմիայի։
Չափման խնդիրը
Ֆրեյմվորքերը պարտադիր չէ, որ մոդելին նույնական հուշումներ փոխանցեն, նույնիսկ երբ թեստային միջավայրը այդպես է ենթադրում։ Հեղինակներն ինքներն են բախվել դրան. CrewAI-ի կանխադրված գործակալի կառուցումը չէր օգտագործում ընդհանուր համակարգային հուշումը, այլ այն հավաքում էր role, goal և backstory առանձին դաշտերից, ինչի հետևանքով հուշման մեջ հայտնվել է «safely» բառը, որը չկար ոչ մի այլ պայմանում։ Ադապտերը շտկելուց հետո հաջողության ցուցանիշը վիճակագրորեն նշանակալիորեն փոխվել է, և թիմը բայթ առ բայթ հաստատել է դրանց նույնականությունը բոլոր պայմաններում։
Ինչն է իրականում բացատրում արդյունքը
Ամենից շատ ազդում է հարձակման կատեգորիան։ Մոդելի ընտրությունը՝ ավելի քիչ, իսկ ֆրեյմվորքինը գրեթե չի նկատվում. ըստ հեղինակների՝ ֆրեյմվորքի ազդեցությունը մոտավորապես երկու կարգով փոքր է հարձակման կատեգորիայից և մեկ կարգով՝ մոդելի ընտրությունից։ Քանի որ աննշան արդյունքը միայն նշանակում է, որ տարբերություն չի հայտնաբերվել, անցկացվել է նաև էկվիվալենտության պաշտոնական թեստ՝ սահմանը սահմանված մինչև տվյալներին նայելը. ութ պայմանի միջև բոլոր 28 զույգային համեմատությունները տեղավորվել են այդ սահմանի մեջ։ Մեկ փոքր բացառություն կա. CrewAI-ի դեպքում մնում է փոքր, բայց վիճակագրորեն հայտնաբերելի մնացորդային ազդեցություն՝ սահմանին ամենամոտ համեմատությունը։
Երկու թակարդ և եզրակացություն
Ճանապարհին ի հայտ են եկել երկու գործնական խնդիր։ Մեկ առաջատար մոդել կոնկրետ հուշման վրա լուռ ծախսել է ամբողջ token բյուջեն ներքին դատողության վրա և վերադարձրել դատարկ պատասխան՝ վեց անգամ վեցից։ Երկրորդ թակարդը token-ների հաշվառումն է. Google ADK-ն և Semantic Kernel-ը դատողության token-ները հաշվում են տարբեր կանոններով, ուստի ուղղակի համեմատությունը անիրական ծախսային տարբերություն է ստեղծում։ Հեղինակների խորհուրդը հստակ է՝ ֆրեյմվորքը մի ընտրեք միայն անվտանգության նկատառումներով, ջանքը ներդրեք հարձակման մակերևույթի ծածկույթի և մոդելի ընտրության վրա։ Ամբողջ մեթոդաբանությունը նկարագրված է «AgentPort-Bench: A Controlled Seven-Framework Evaluation of Agentic AI Security Portability» հոդվածում, որը դեռ գրախոսվում է, ուստի արդյունքները հեղինակների սեփական վերլուծությունն են, ոչ թե գրախոսված եզրակացություն։
SiTech — AI-ով հզորացված վեբ մշակում
Ստեղծում ենք արագ ու ժամանակակից կայքեր և AI-ը ներդնում իրական բիզնես գործընթացներում։ Ունե՞ք նախագիծ կամ հարց։ Ուրախ կլինենք օգնել։