Liquid AI представила драфтер DSpark для прискорення візуально-мовних моделей
Liquid AI випустила експериментальну драфт-модель DSpark для своєї візуально-мовної моделі LFM2.5-VL-3B: спекулятивне декодування прискорює генерацію до 3,13 раза на пристрої та до 2,66 раза на H100, не змінюючи якість результатів.
24 вересня Liquid AI представила експериментальну драфт-модель DSpark для своєї візуально-мовної моделі LFM2.5-VL-3B. Вона додає шлях спекулятивного декодування, який в обмін на невелике зростання обсягу пам'яті дає помітне прискорення, не змінюючи якість вихідних даних.
Що дає драфтер
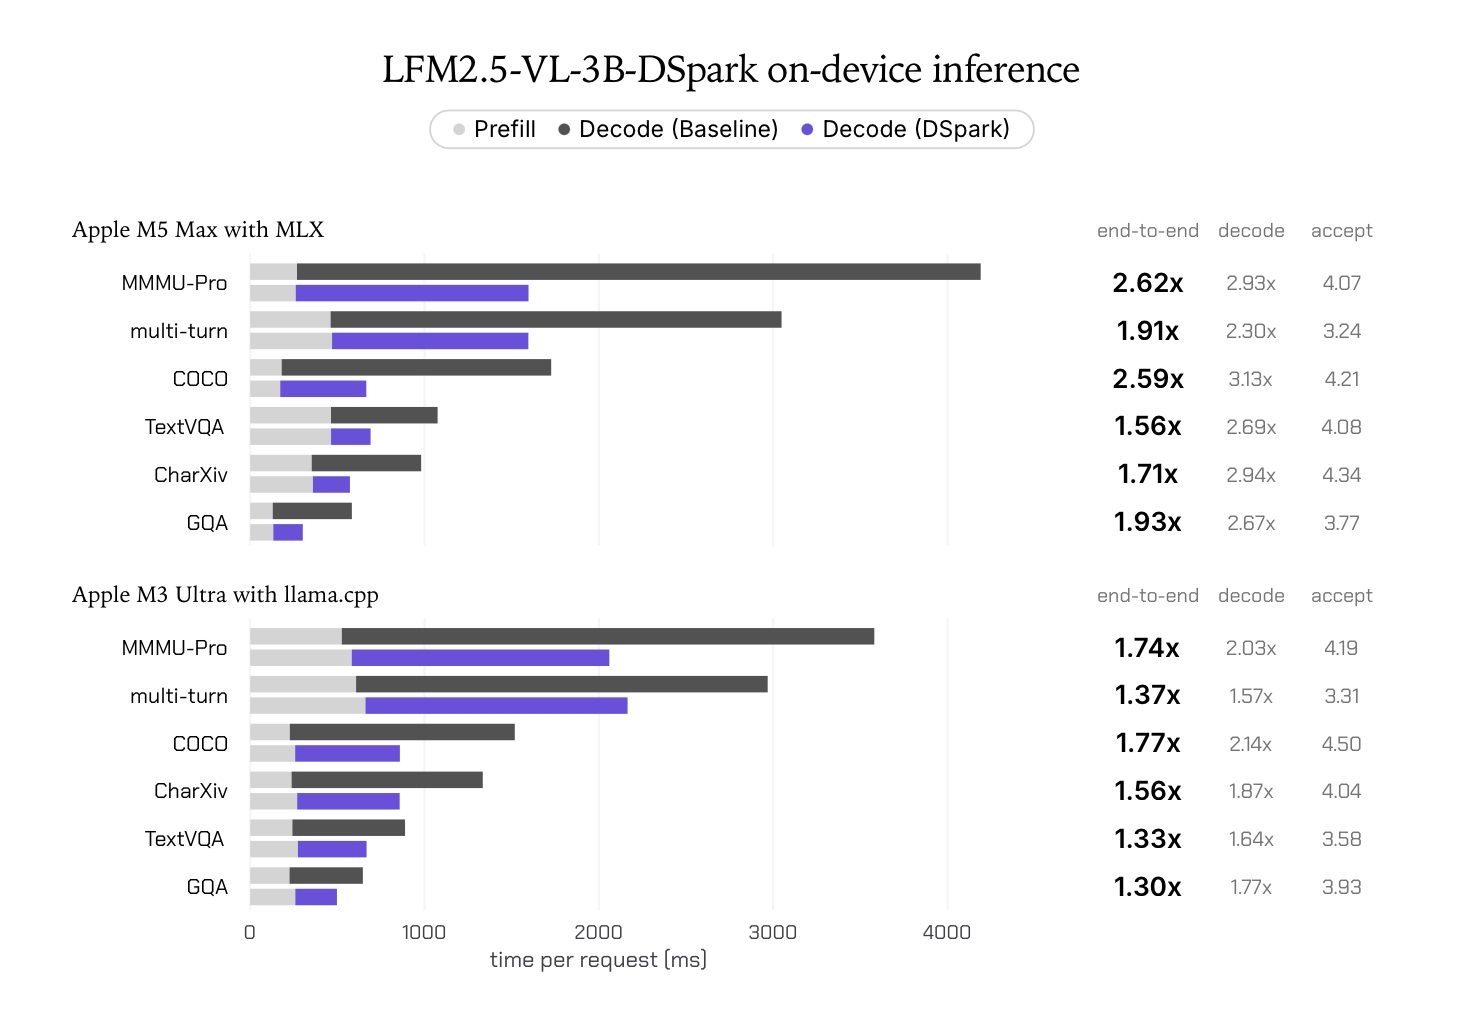
За вимірюваннями Liquid AI, декодування прискорюється до 3,13 раза на пристрої та до 2,66 раза на H100, а наскрізна затримка зменшується до 2,62 і 2,27 раза. Драфтер додає близько 280 мільйонів параметрів, тобто 8,9% до цільової моделі на 3B, а підтримку llama.cpp, MLX-VLM і SGLang забезпечено з першого дня.
Як працює спекулятивне декодування
Драфтер має ту саму архітектуру, що й текстові моделі LFM2.5-DSpark: зчитує приховані стани цільової моделі на визначених шарах і пропонує блок із k токенів-кандидатів. Фрагменти зображення й текстові токени проєктуються у спільне подання, тож драфтер працює з однаковими за розмірністю векторами.
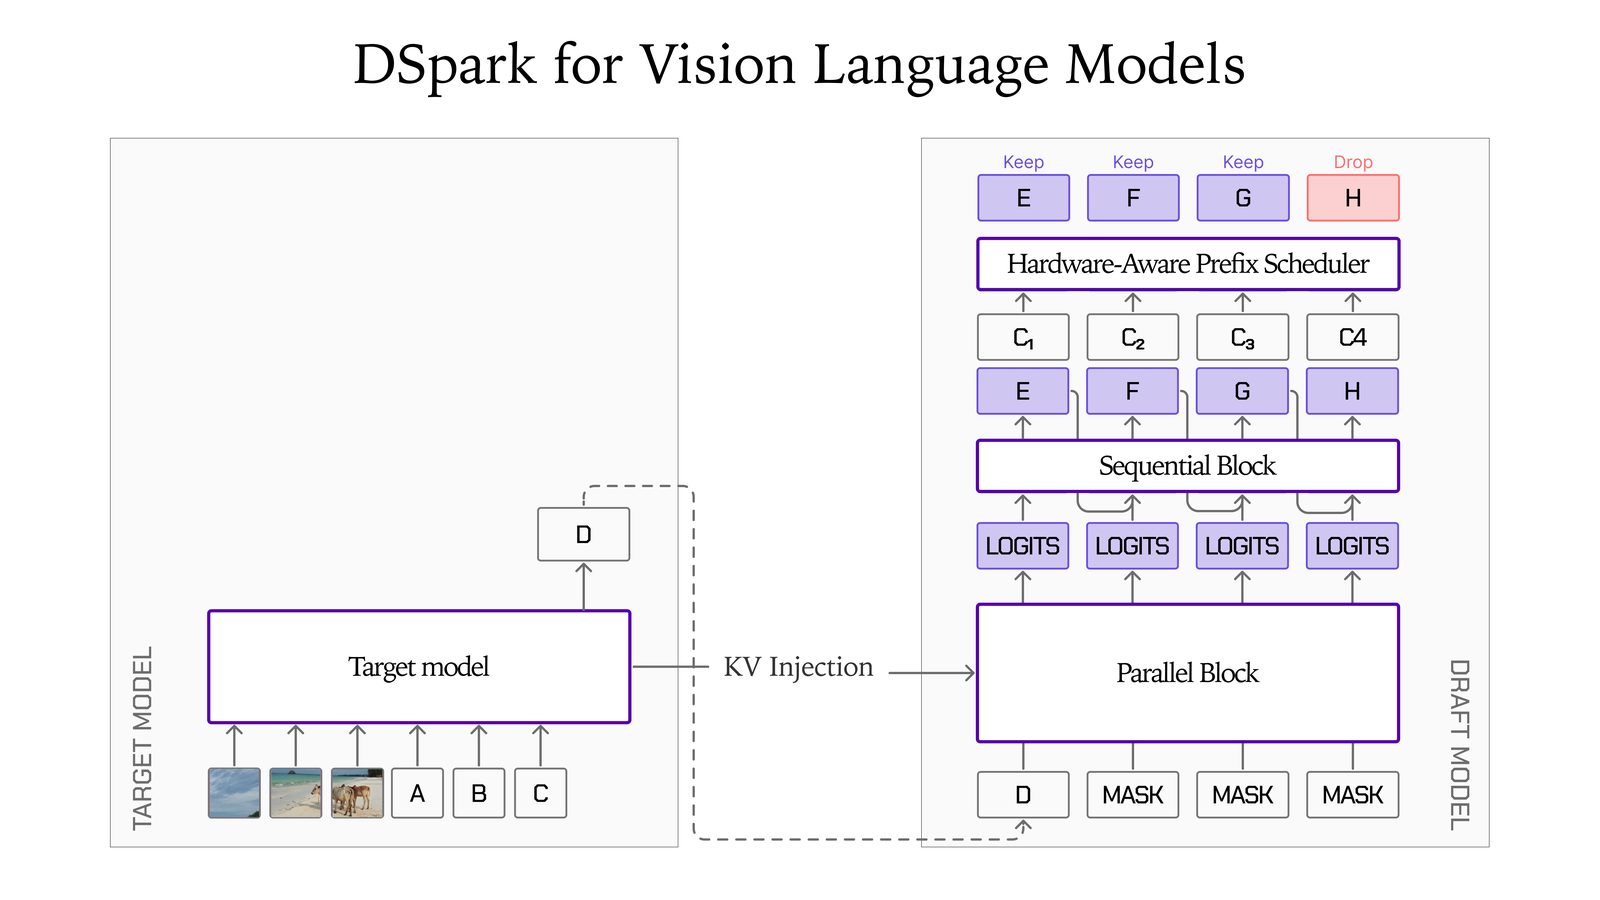
Навчання йшло за рецептом DSpark на суміші візуально-мовних SFT-даних: після порівняння 3, 4 і 5 шарів обрано драфтер із 4 шарами, що використовує лише механізм уваги, з розміром блоку 9. Драфтер налічує близько 279,5 мільйона параметрів.
Прискорення на пристрої та на H100
Вимірювання проводили з розміром блоку 8 на шести візуальних завданнях за бенчмарком MMSpec: від загального VQA до VQA за діаграмами й багатокрокового діалогу. З MLX на M5 Max декодування пришвидшилося від 2,30 до 3,13 раза, а наскрізна затримка зменшилася від 1,56 до 2,62 раза. З llama.cpp на M3 Ultra декодування покращилося від 1,57 до 2,14 раза, наскрізний час від 1,30 до 1,77 раза. На H100 декодування прискорюється до 2,66 раза, наскрізна затримка зменшується від 1,64 до 2,27 раза.
Де спекуляція перестає допомагати
Спекулятивне декодування прискорює лише декодування, а не кодування зображення чи попереднє заповнення. Зображення спершу проходить візуальний енкодер, а потім мовний бекбон обробляє сотні візуальних токенів із текстовим запитом, і на слабших пристроях це займає більшу частку часу. Якщо він і так споживає значну частину часу, навіть велике прискорення декодування дає лише помірний виграш. Liquid AI пояснює це законом Амдала.
Драфтер доступний на Hugging Face у форматах Safetensors і GGUF; потрібні збірки llama.cpp, MLX-VLM і SGLang із підтримкою DSpark. Спекулятивне декодування точне: цільова модель перевіряє кожен запропонований токен, тож результат збігається з її власним виводом.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.