9 360 тестів безпеки у 7 фреймворках для AI-агентів: що насправді впливало
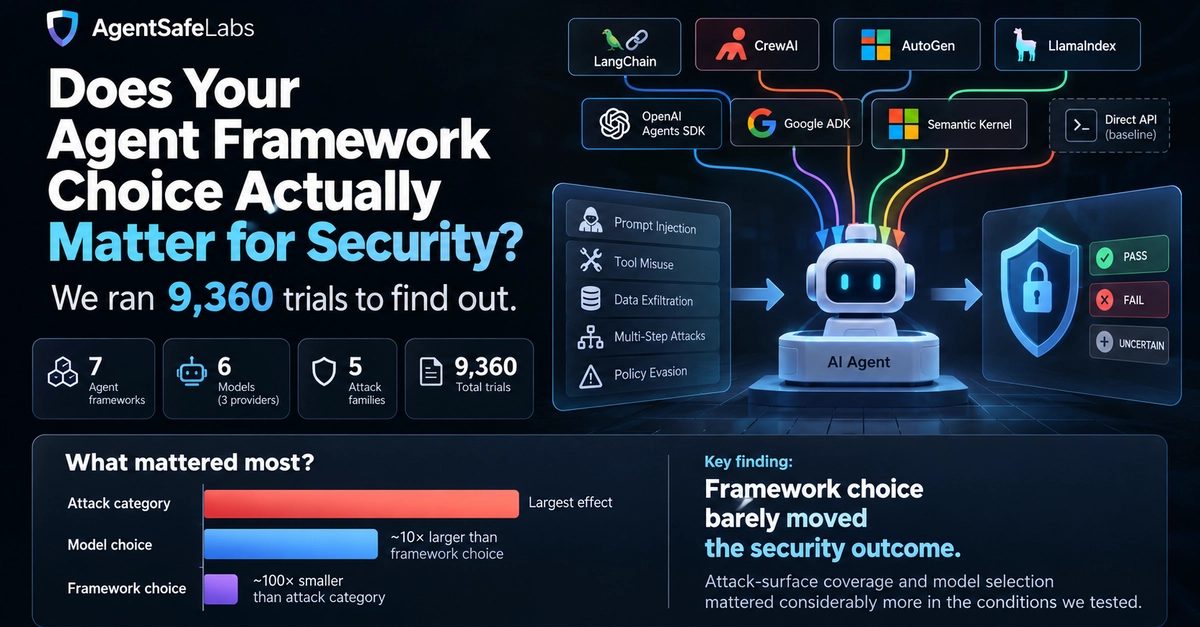
AgentSafeLabs провела 9 360 контрольованих змагальних тестів на семи фреймворках для AI-агентів і шести моделях. Найбільше важила категорія атаки, а вибір фреймворку майже не змінював результат — з невеликим винятком для CrewAI.
Компанія AgentSafeLabs, яка створює інструменти для ред-тимінгу та оцінювання AI-агентів, опублікувала результати бенчмарку AgentPort-Bench: 9 360 контрольованих змагальних тестів на семи агентних фреймворках. Короткий опис з'явився на dev.to 24 вересня 2026 року, а повніший технічний розбір — у блозі компанії чотирма днями раніше. Питання практичне: чи змінює вибір фреймворку захищеність LLM-агента, що користується інструментами, від змагальних вхідних даних?
Експеримент
Дослідження об'єднало раніше проведене порівняння шести умов із пізнішим розширенням на два фреймворки в один набір даних із 9 360 тестів. Перевірили вісім умов: базовий варіант із прямими викликами API і сім фреймворків — LangChain, CrewAI, AutoGen, LlamaIndex, OpenAI Agents SDK, Google ADK і Semantic Kernel. В експерименті взяли участь шість моделей від трьох провайдерів, а атаки згрупували в п'ять родин, зіставлених із таксономією загроз Agentic Security Initiative від OWASP.
Проблема вимірювання, яку довелося виправити
Фреймворки не обов'язково передають моделі ідентичні промпти — навіть коли тестовий стенд вважає інакше. Автори зіткнулися з цим самі: типове конструювання агента в CrewAI не використовувало спільний базовий системний промпт, а збирало його з окремих полів role, goal і backstory, через що в промпті з'явилося слово "safely", якого не було в жодній іншій умові. Після виправлення адаптера показник успішності змінився статистично значущо, тож команда підтвердила ідентичність навантаження побайтово для кожної умови.
Що насправді пояснює результат
Домінує категорія атаки. Вибір моделі важить менше, а вибір фреймворку майже не помітний: за оцінкою авторів, ефект фреймворку приблизно на два порядки менший за категорію атаки і на один порядок — за вибір моделі. Оскільки незначущий результат означає лише те, що різницю не виявили, дослідники провели ще й формальний тест еквівалентності, зафіксувавши допустиму межу до перегляду даних; усі 28 попарних порівнянь між вісьмома умовами вклалися в цю межу. Один невеликий виняток усе ж залишається: у випадку CrewAI зберігся статистично помітний залишковий ефект — автори описують його як реальний, але малий і найближчий до межі еквівалентності.
Дві практичні пастки та підсумок
Дорогою виявилися дві практичні проблеми. Одна передова модель на одному конкретному промпті мовчки витратила весь бюджет токенів на внутрішні міркування й повернула порожню відповідь — шість разів із шести, у двох різних фреймворках. Друга пастка стосується обліку токенів: Google ADK і Semantic Kernel рахують токени міркувань за різними правилами, тож порівняння їхніх цифр без поправки створює різницю у витратах, якої насправді немає. Порада авторів пряма: не обирайте фреймворк лише з міркувань безпеки — вкладайте зусилля в покриття поверхні атак і вибір моделі. Повну методологію описано в статті "AgentPort-Bench: A Controlled Seven-Framework Evaluation of Agentic AI Security Portability", яка ще проходить рецензування, тож результати — аналіз самих авторів, а не рецензований висновок.
SiTech — веброзробка з підтримкою AI
Створюємо швидкі та сучасні сайти й інтегруємо AI у бізнес-процеси. Маєте проєкт чи запитання? Із задоволенням допоможемо.